개요
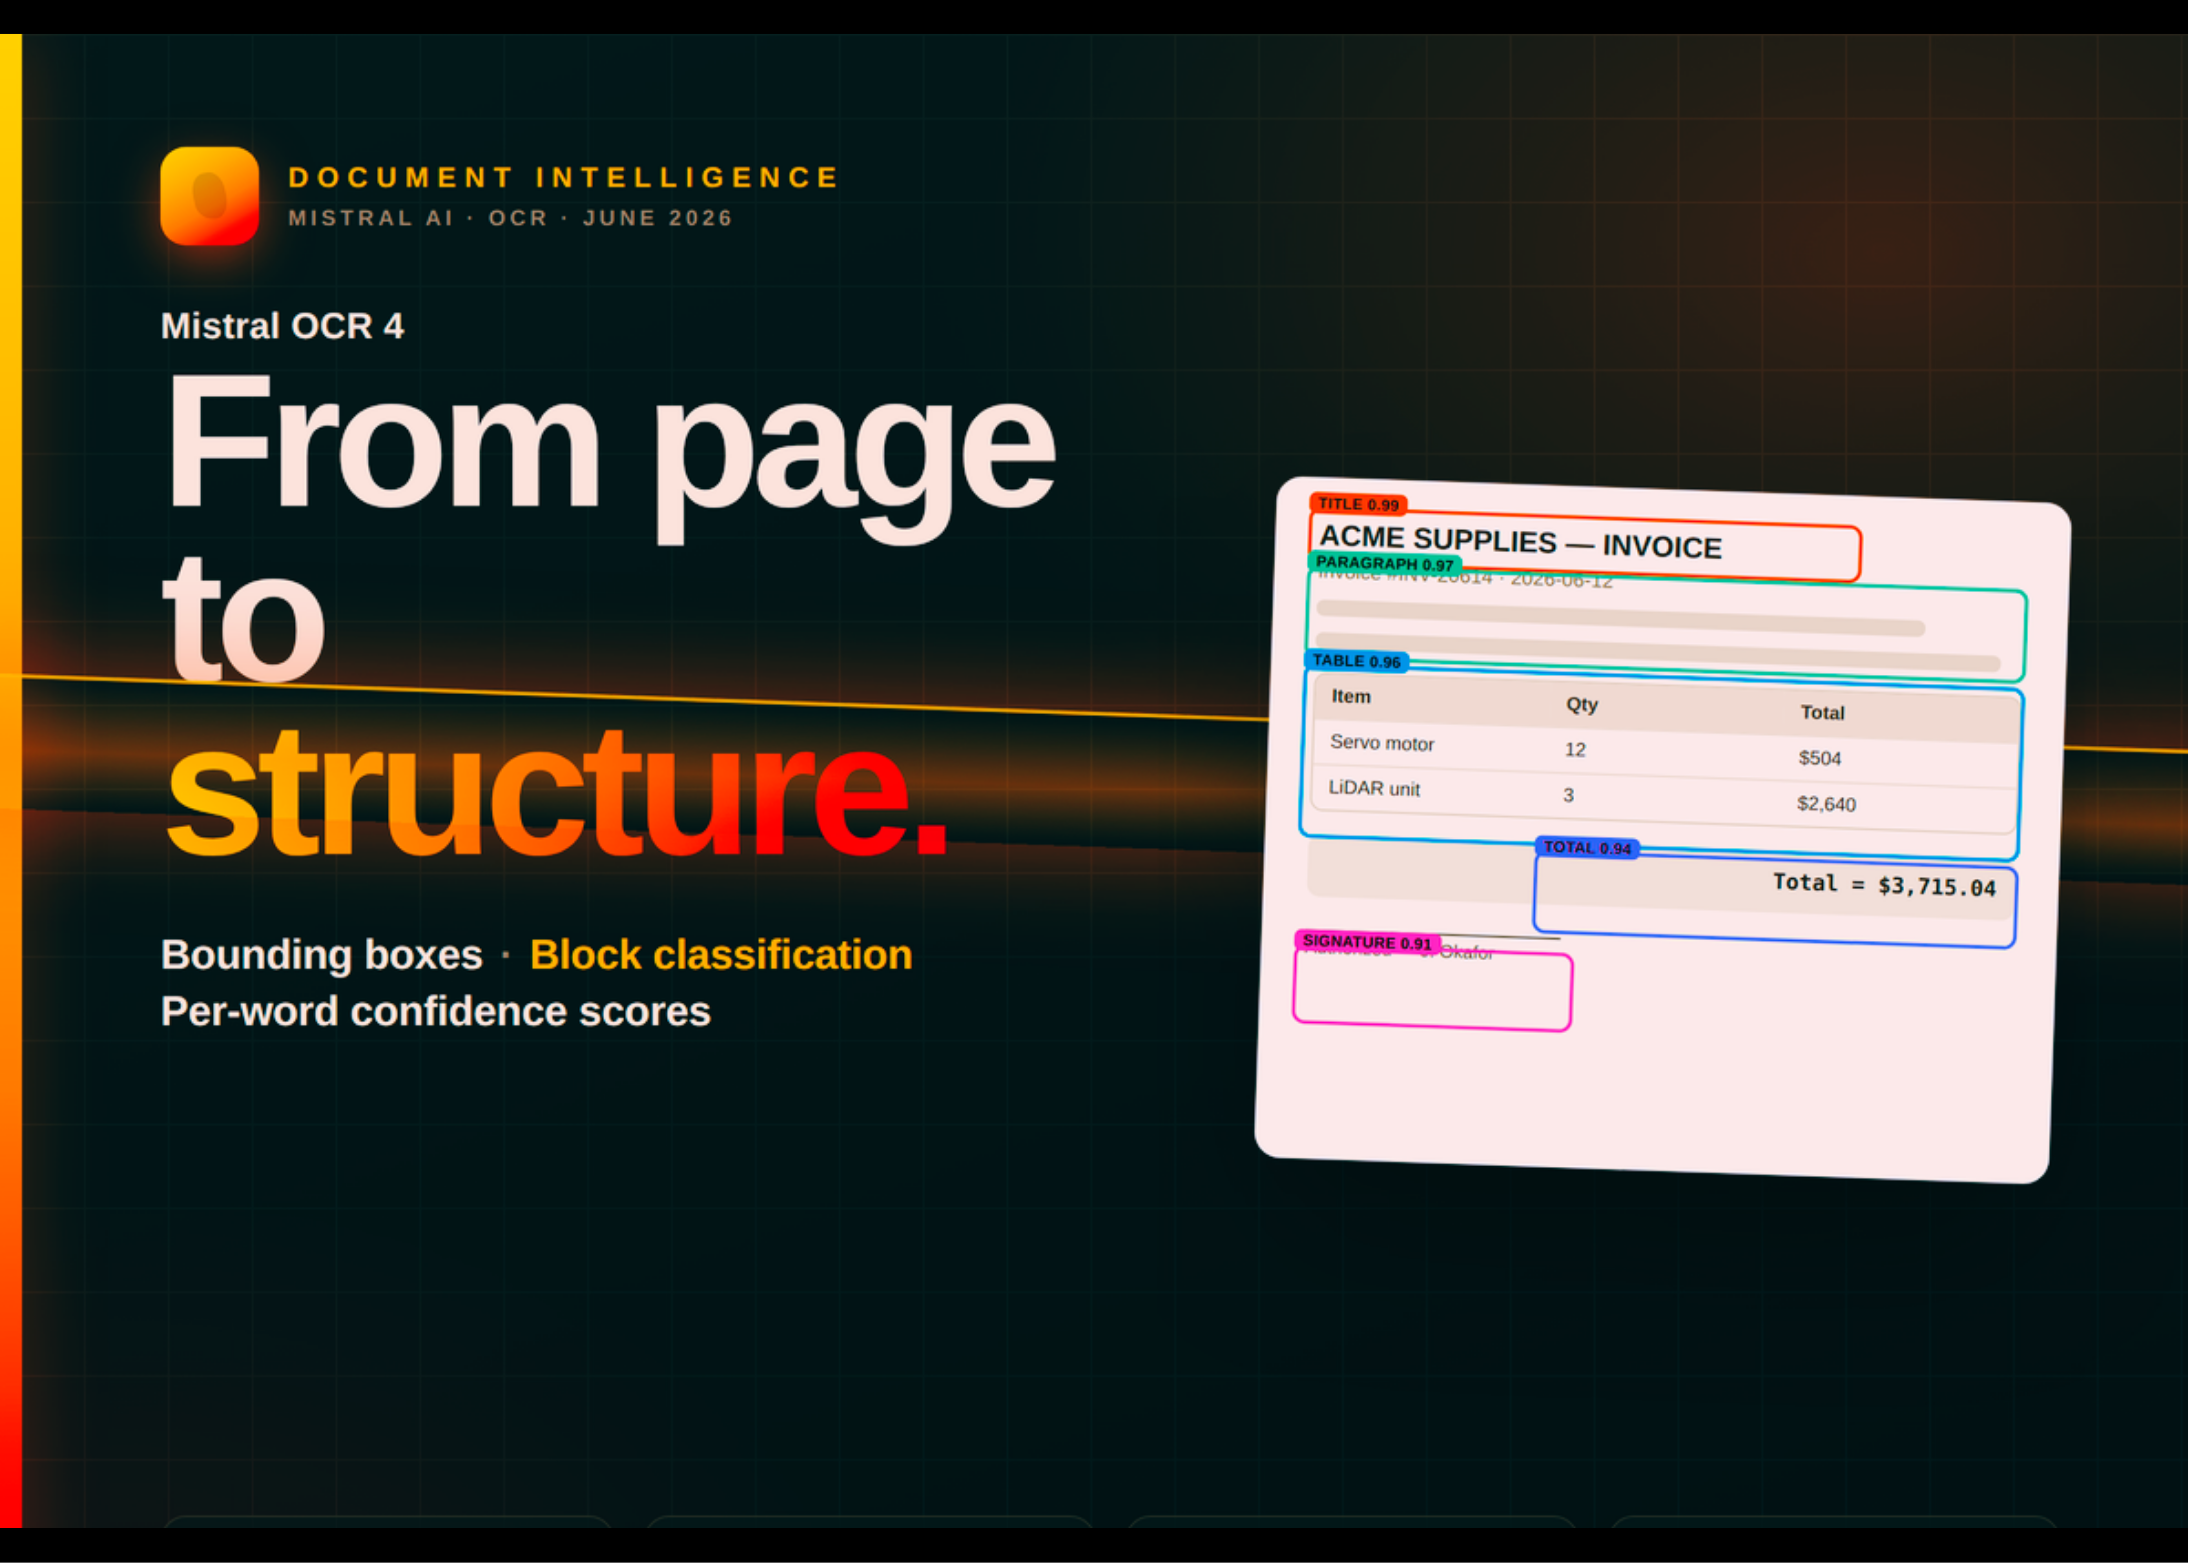
문서에서 글자만 뽑아 주던 시대는 끝나가는 것 같습니다. Mistral이 6월 23일 공개한 OCR 4는 한 문서를 통째로 “구조"로 돌려줍니다. 어디에 무엇이 있고(바운딩 박스), 그 덩어리는 어떤 종류이며(제목·문단·표·수식·서명·그림), 모델이 얼마나 확신하는지(페이지·단어별 신뢰도)까지 같이 나옵니다. 그냥 보기 좋은 결과물이 아니라, RAG에 그대로 넣어도 인용이 되는 입력을 만들겠다는 설계입니다.
핵심 요약
- 출력이 달라졌습니다. 텍스트만 주던 OCR이 이제 바운딩 박스, 블록 타입 라벨, 단어 단위 신뢰도까지 같이 돌려줍니다.
- 170개 언어, 10개 언어군 지원. 희소 언어와 저자원 언어에서도 개선이 있다고 합니다.
- 사람 평가에서 평균 72% 승률. 600개가 넘는 문서, 12개 이상 언어에서 독립 평가자들이 다른 시스템보다 OCR 4를 더 자주 선택했습니다.
- 가격은 1,000페이지당 4달러, 배치 API를 쓰면 2달러로 떨어집니다.
- 엔드포인트는 하나입니다. 원시 추출도, 스키마 기반 Document AI 출력도 같은 API로 받아 옵니다.
- 컨테이너 하나로 자체 호스팅. 데이터 잔류·규정 준수가 까다로운 기업이 직접 돌릴 수 있게 만들었습니다.
OCR이 “구조"를 돌려준다는 게 무슨 뜻일까
지금까지의 OCR은 페이지에서 글자를 깨끗하게 뽑아 텍스트와 표로 정리해 주는 데 집중했습니다. OCR 4는 한 단계 더 들어갑니다. 페이지 전체를 블록 단위로 잘라서, 그 블록의 위치(좌표)와 종류, 신뢰도까지 같이 줍니다.
블록 타입은 제목, 문단, 표, 수식, 서명, 그림 같은 것들입니다. 각 블록마다 페이지 안의 위치를 정확히 알려 주는 바운딩 박스가 붙고, 페이지 단위와 단어 단위 신뢰도가 함께 따라옵니다.
이 차이가 실제 시스템에서는 꽤 큽니다. 다운스트림이 받는 정보가 “문서에 뭐라고 쓰여 있다"에서 “어디에, 어떤 역할로, 얼마나 확실하게 쓰여 있다"로 늘어나기 때문입니다. 인용을 붙여야 하는 RAG, 민감 영역을 검게 가리는 리덕션, 사람이 검토를 거드는 휴먼-인-더-루프에서 바로 활용할 수 있는 정보입니다.
지원 포맷은 기업이 실제로 다루는 것들 — PDF, DOC, PPT, OpenDocument입니다. 모델은 컨테이너 하나에 들어갈 정도로 작아서, 데이터 잔류나 규정 준수 때문에 외부에 보낼 수 없는 기업도 직접 돌릴 수 있습니다.
벤치마크 — 사람이 골랐고 자동 평가도 통과했습니다
Mistral은 OCR 4를 네 부류와 붙여 봤습니다. AI 네이티브 OCR 모델, 일반 목적의 프런티어 모델, 기업용 문서 서비스, 그리고 자기네 이전 버전인 OCR 3입니다.
먼저 사람 평가. 독립 평가자들이 600개 이상의 문서, 12개 이상 언어에서 OCR 4와 경쟁 시스템의 결과를 문서별로 비교했습니다. 평균 승률이 72%. 모든 비교 대상에 대해 OCR 4가 더 자주 선택됐다는 뜻입니다.
자동 벤치마크에서도 숫자가 따라옵니다. 공개 벤치마크 OlmOCRBench에서 85.20, OmniDocBench에서 93.07, 자체 평가인 Crawl Multilingual에서 0.98을 기록했다고 합니다.
고객 사례도 두 건 공개됐습니다. Rogo는 같은 정확도를 유지하면서 약 8배 저렴한 비용과 17배 짧은 지연 시간을 봤다고 했고, Anaqua는 기존 공급자 대비 페이지당 약 4배 빠른 처리를 측정했다고 합니다. 둘 다 회사가 직접 공개한 수치니까 곧이곧대로 받기보다는 방향 신호로 보는 게 맞습니다.
그냥 텍스트가 아니라 “블록"이 필요한 이유
바운딩 박스는 사용자들이 가장 많이 요청한 기능이었다고 합니다. 그도 그럴 것이, 좌표가 있어야 원본 위에 형광펜처럼 글자를 짚어 줄 수 있고, 좌표가 있어야 데이터 파이프라인이 안정적으로 돌아갑니다.
블록 타입과 신뢰도는 또 다른 일을 합니다.
- 인용 가능한 답변 — RAG가 답을 줄 때 “이 문장은 12쪽 표 두 번째 행에서 왔습니다"처럼 짚어 줄 수 있습니다.
- 리덕션 — 서명 블록, 개인정보 블록만 골라서 검게 가리기.
- 사람 검토 분기 — 신뢰도가 낮은 영역만 사람에게 넘기고, 나머지는 자동 승인.
이렇게 정리된 블록은 RAG 입장에서는 그 자체로 더 나은 검색 단위입니다. 에이전트는 문서를 “읽는” 게 아니라 “조작"할 수 있는 기본 단위로 받을 수 있고, 커넥터는 색인과 적재에 쓸 수 있는 일관된 타입 정보를 받습니다.
OCR 4는 Mistral이 같이 공개한 오픈소스 검색 프레임워크인 Search Toolkit의 적재 컴포넌트이기도 합니다. 구조화된 출력이 그대로 검색·평가 워크플로의 “인용 준비된 입력"이 되도록 묶어 둔 셈입니다.
어떤 일에 쓸 수 있나 — 실제 예시
Mistral이 정리한 활용 시나리오는 대략 이렇습니다.
- 문서 파싱·추출 — 다국어 계약서를 색인용 마크다운으로 깔끔하게 변환.
- RAG — 분류된 블록을 Search Toolkit에 넣어, 출처가 붙은 답변을 생성.
- 에이전트 워크플로 — 인보이스 처리 에이전트가 타입이 정해진 필드와 박스 좌표로 양식을 자동 채움.
- 신뢰도 게이트 파이프라인 — 신뢰도 낮은 영역만 사람에게 보내고, 나머지는 자동 승인.
- 기업 검색 — 아카이브 전체를 OCR 4로 적재하면서 엔티티 추출도 함께.
초기 도입 사례로는 인보이스를 구조화된 필드로 바꾸는 곳, 사내 아카이브를 디지털화하는 곳, 기술 보고서에서 깨끗한 텍스트만 뽑아 가는 곳, 기업 검색 백엔드로 쓰는 곳 등이 있다고 합니다.
Mistral이 명시적으로 못 박은 한계도 있습니다. OCR 4는 이해를 도와주는 모델이지 결정을 내리는 모델이 아닙니다. 의료 진단, 법적 판결, 고위험 금융 의사결정, 안전이 중요한 시스템, 실시간 처리, 영상·음성 같은 비문서 입력에는 쓰지 말라고 합니다.
같은 API, 두 가지 모드 — 원시 추출과 Document AI
OCR 4의 엔드포인트는 하나입니다. 모든 요청이 같은 모델을 통과하고, 매번 추출된 텍스트, 바운딩 박스, 블록 타입, 신뢰도, 마크다운이 같이 나옵니다. 다른 건 그 위에 얼마나 더 얹느냐입니다.
판단 기준은 단순합니다.
- 원시 추출 결과 그대로가 필요하면 OCR 4를 그대로 호출.
- 스키마에 맞춰 다시 짜거나 도메인 필드로 라벨링이 필요하면, 같은 호출에 Document AI 파라미터를 더 얹기.
다른 모델로 바꿀 필요 없이, 같은 엔드포인트 안에서 “얼마나 다듬어진 출력을 받을지"만 정하는 셈입니다.
API는 어떻게 생겼나
기본 추출은 문서 URL 하나면 됩니다. 페이지가 구조화된 형태로 돌아오는데, include_blocks=True를 주면 타입이 붙은 블록과 바운딩 박스가 함께 옵니다.
응답은 JSON이고, pages 배열에 페이지마다 다음이 들어 있습니다.
markdown— 깨끗하게 정리된 텍스트images— 페이지 내 이미지tables— 표 데이터hyperlinks— 링크dimensions— 페이지 치수confidence_scores— 페이지·요소별 신뢰도
사람 검토 파이프라인을 만들고 싶다면 신뢰도를 단어 단위로 받으면 됩니다. 옵션을 "word"로 두면 페이지마다, 그리고 표 항목마다 word_confidence_scores 배열이 추가로 붙어 옵니다. 단어 하나하나에 점수가 붙기 때문에, 임계값을 정해서 그 아래 단어만 사람에게 보내는 게 그대로 됩니다.
대규모 작업은 배치 추론을 권장합니다. 페이지당 비용이 절반으로 떨어집니다.
가격은 페이지당으로 계산됩니다. 1,000페이지에 4달러, 배치 API를 쓰면 2달러. 같은 정확도에서 비용을 8분의 1로 줄였다는 고객 발표가 있을 정도면, 가격표 자체보다 “어디까지 자동으로 돌릴 수 있느냐"가 실제 절감의 핵심으로 보입니다.
실무자가 볼 핵심 포인트
- 인용 가능한 RAG를 만들 거라면 출력 포맷부터 점검하세요. 블록 타입, 바운딩 박스, 단어 단위 신뢰도가 그대로 인용 메타데이터가 됩니다. 답변에 “12쪽 표 2행” 수준의 출처를 붙이고 싶다면 OCR 단에서 이런 정보를 챙겨 두는 게 가장 깔끔합니다.
- 자동 처리율을 끌어올리고 싶다면 신뢰도 게이트를 먼저 설계하세요. 페이지·단어 신뢰도를 임계값으로 끊어서, 낮은 영역만 사람에게 보내면 됩니다. 모든 결과를 사람이 보지 않아도 됩니다.
- 자체 호스팅 시나리오가 무겁다면 OCR 4가 답일 수 있습니다. 컨테이너 하나로 떨어진다는 점이 결정적입니다. 데이터를 외부로 못 보내는 환경에서도 같은 출력 포맷을 그대로 쓸 수 있습니다.
- 단일 엔드포인트 설계를 잘 활용하세요. 원시 추출과 Document AI 출력이 같은 호출에서 갈리기 때문에, 파이프라인을 단계별로 쪼개지 않아도 됩니다. 같은 호출 안에서 “스키마 필요 여부"만 분기시키면 충분합니다.
- 비용은 배치에서 갈립니다. 인보이스나 대량 문서 적재처럼 실시간이 필수가 아닌 작업은 배치 API로 보내야 페이지당 2달러로 떨어집니다. 실시간 인입을 묶어서 배치로 흘리는 큐 설계가 의미 있는 절감으로 이어집니다.
- 안 쓰는 영역은 분명히 하세요. Mistral 본인이 의료 진단, 법적 판결, 고위험 금융 의사결정, 안전 중요 시스템, 실시간·영상·음성 입력은 적합하지 않다고 밝혔습니다. 이런 영역에 끼워 넣지 마세요.
정리하면
OCR 4의 진짜 새로움은 “더 정확해진 OCR"이 아니라 “OCR이 RAG·에이전트·검색의 친화적 입력으로 다시 그려졌다"는 데 있습니다. 위치, 블록 타입, 신뢰도가 같이 나온다는 건 다운스트림이 받을 정보가 한 단계 풍부해진다는 뜻이고, 그 정보로 인용·리덕션·검토 분기·자동 채움 같은 일을 OCR 출력만으로 처리할 수 있다는 뜻입니다. 가격이 1,000페이지에 4달러, 배치는 2달러, 컨테이너 하나로 돌아간다는 조건까지 합쳐 보면, 사내 문서 파이프라인을 다시 짜는 회사들에게는 검토해 볼 만한 선택지가 하나 늘었습니다.