개요
MiniMax가 HuggingFace에 M3 모델 카드를 올렸습니다. 발표 글만 보고 “오, 좋네” 하고 끝낼 수도 있지만, 진짜 궁금한 건 따로 있습니다. 실제로 어떻게 돌리지? 이 글은 모델 카드에 나와 있는 vLLM, SGLang, Transformers, Docker 실행법을 한국 개발자 입장에서 정리한 실전 메모입니다.
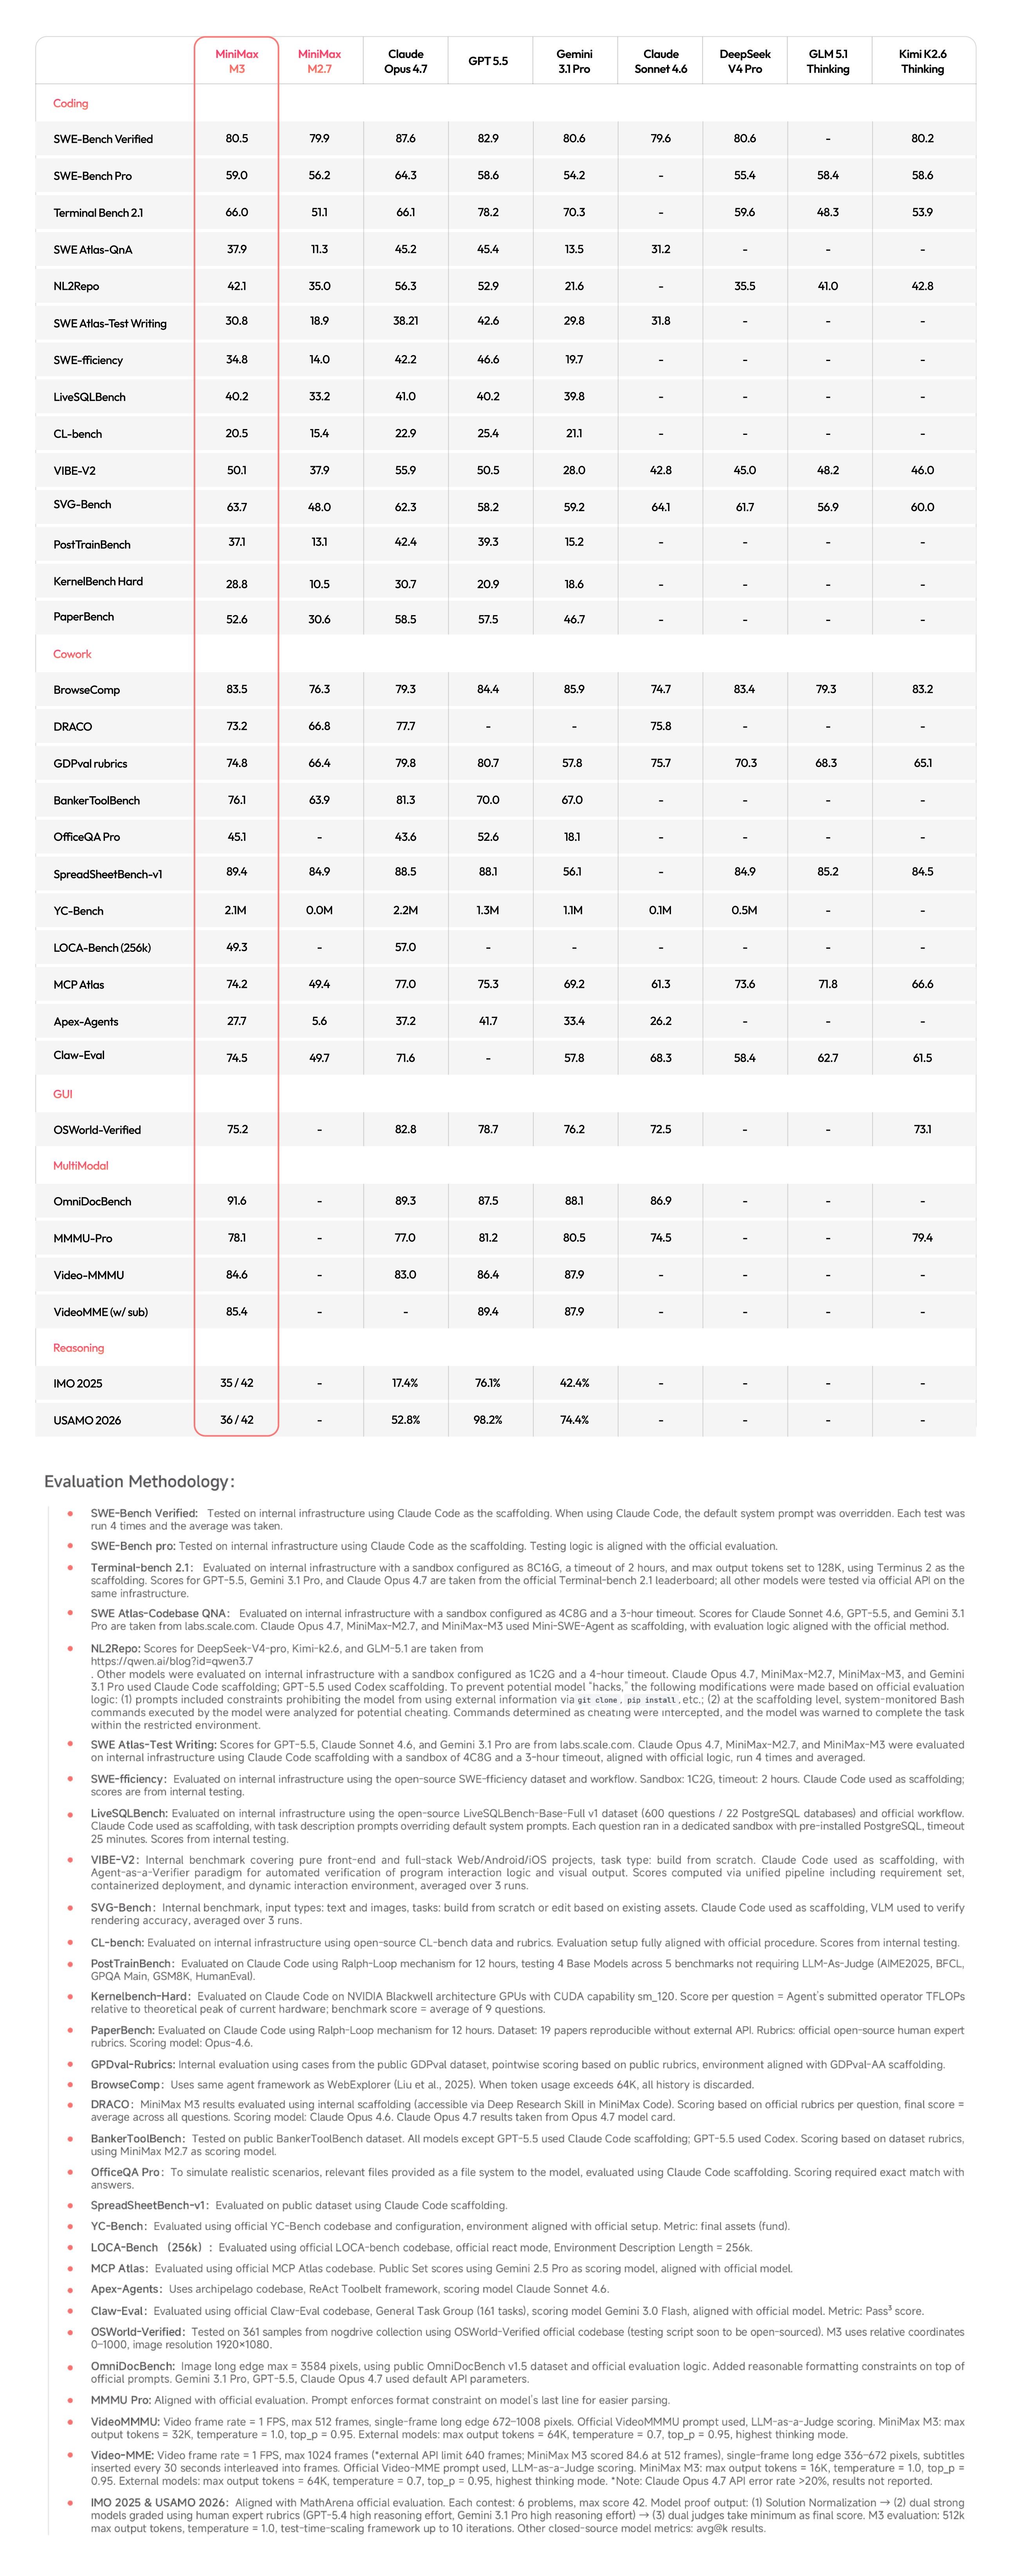
스펙부터 짧게 짚고 들어가겠습니다. 총 파라미터 약 428B, MoE 구조로 활성 파라미터는 약 23B, 컨텍스트는 1M 토큰. Safetensors·BF16·F32. 라이선스는 minimax-community. 이미지·텍스트 입력을 받는 네이티브 멀티모달입니다.
핵심 요약
- 총 428B·활성 23B MoE, 1M 컨텍스트, BF16/F32 텐서 — Transformers 공식 지원
- MSA(MiniMax Sparse Attention)로 prefill 9배·decode 15배 가속 (이전 세대 대비)
- 추론 백엔드 4종 지원: vLLM, SGLang, Transformers 파이프라인, Docker Model Runner
- 이미 11종 양자화가 올라와 있어 llama.cpp·LM Studio·Ollama에서도 바로 사용 가능
- 권장 하이퍼파라미터: Temperature 1.0 / Top-p 0.95 / Top-k 40
- Thinking / Non-thinking 두 가지 추론 모드 — 작업 성격에 맞춰 선택
아키텍처: MSA가 핵심입니다
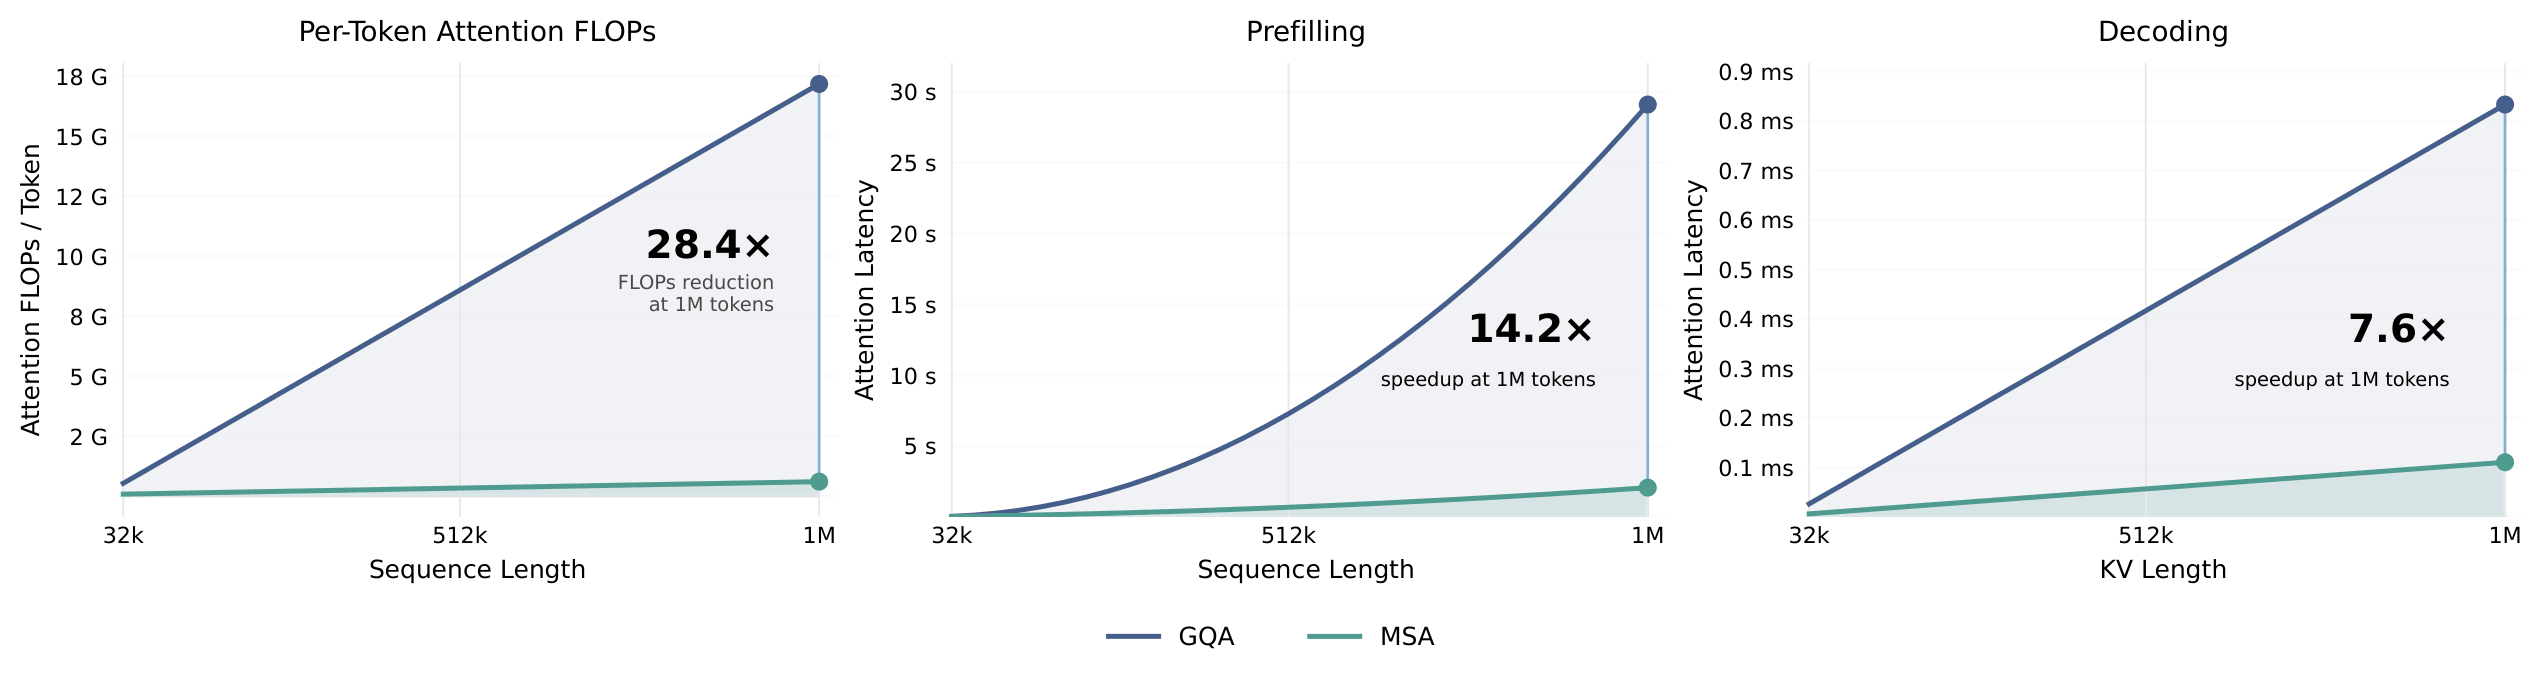
M3의 진짜 차별점은 어텐션 구조에 있습니다. 일반적인 GQA는 컨텍스트가 길어질수록 어텐션 연산량이 폭증합니다. M3는 MiniMax Sparse Attention(MSA) 라는 자체 sparse 어텐션을 씁니다.
모델 카드가 강조하는 수치는 두 가지입니다.
- per-token 연산량이 기존 대비 1/20 수준
- 1M 컨텍스트에서 M2 대비 prefill 9배·decode 15배 가속
성능을 거의 그대로 유지하면서 메모리와 연산을 크게 깎았다는 게 포인트입니다. 1M 토큰을 “선언만” 하는 모델이 아니라, 실제로 그 길이에서 돌릴 만한 비용 구조를 갖췄다는 뜻입니다.
vLLM으로 띄우기
가장 손이 덜 가는 방법입니다. OpenAI 호환 API가 그대로 떨어집니다.
pip install vllm
vllm serve "MiniMaxAI/MiniMax-M3"
서버가 뜨면 평소 OpenAI SDK 쓰던 그대로 호출하면 됩니다. 멀티모달 입력은 image_url 형식을 그대로 넣어줍니다.
curl -X POST "http://localhost:8000/v1/chat/completions" \
  -H "Content-Type: application/json" \
  --data '{
    "model": "MiniMaxAI/MiniMax-M3",
    "messages": [{
      "role": "user",
      "content": [
        {"type": "text", "text": "이 이미지를 한 문장으로 설명해줘."},
        {"type": "image_url", "image_url": {"url": "https://example.com/photo.jpg"}}
      ]
    }]
  }'
vLLM 팀이 별도 레시피를 올려뒀습니다(recipes.vllm.ai/MiniMaxAI/MiniMax-M3). 실제 운영용 설정은 그쪽을 한 번 더 확인하세요.
SGLang으로 띄우기
장기 세션·툴 콜이 많은 에이전트 워크로드에는 SGLang이 잘 맞습니다.
pip install sglang
python3 -m sglang.launch_server \
    --model-path "MiniMaxAI/MiniMax-M3" \
    --host 0.0.0.0 \
    --port 30000
요청 포맷은 vLLM과 동일한 OpenAI 호환 스키마라 클라이언트 코드를 바꿀 필요가 없습니다. SGLang 공식 문서(docs.sglang.io/cookbook/autoregressive/MiniMax/MiniMax-M3)에 권장 설정이 정리돼 있습니다.
Transformers 파이프라인으로 빠르게 테스트
추론 서버 띄우기 전에 노트북에서 한 번 찍어보고 싶을 때 쓰는 방법입니다.
from transformers import pipeline

pipe = pipeline(
    "image-text-to-text",
    model="MiniMaxAI/MiniMax-M3",
    trust_remote_code=True,
)

messages = [{
    "role": "user",
    "content": [
        {"type": "image", "url": "https://example.com/photo.jpg"},
        {"type": "text", "text": "이 사진에 사탕이 있어? 어떤 동물 캐릭터야?"},
    ],
}]
pipe(text=messages)
trust_remote_code=True는 필수입니다. MSA 같은 커스텀 모듈이 모델 레포 안에 들어 있기 때문입니다. 더 세밀하게 제어하고 싶다면 AutoProcessor + AutoModelForMultimodalLM을 직접 사용하면 됩니다.
Docker로 끝내기
가장 빠른 검증 루트입니다. 환경 세팅이 귀찮으면 이걸 먼저 쓰세요.
docker model run hf.co/MiniMaxAI/MiniMax-M3
CI나 격리 환경에서 빠르게 검증할 때 유용합니다.
양자화 11종이 이미 올라와 있습니다
PRO GPU가 없어도 됩니다. 모델 카드 사이드바에 적힌 대로, M3 호환 양자화가 이미 11개 올라와 있습니다. llama.cpp·LM Studio·Jan·Ollama 호환 GGUF 변종을 골라 쓰면 됩니다.
배포 환경별 가이드라인은 대략 이렇습니다.
- 로컬 개발 머신(맥북·게이밍 PC): Ollama / LM Studio + 작은 양자화로 멀티모달 테스트
- 단일 H100 서버: vLLM + BF16 또는 큰 양자화로 처리량 우선
- 다중 GPU 클러스터: SGLang + 전체 정밀도, 에이전트 세션·툴 콜 위주
다운로드는 모델 카드의 한 줄짜리 명령으로 해결됩니다.
hf download MiniMaxAI/MiniMax-M3 --local-dir MiniMax-M3
추론 모드 두 가지
M3는 같은 가중치로 두 가지 모드를 지원합니다.
- Thinking mode: 복잡한 추론, 에이전트 작업, 장기 세션
- Non-thinking mode: 챗·코드 자동완성처럼 지연이 중요한 경우
처음 도입할 때 흔히 하는 실수가 모든 호출에 Thinking을 거는 겁니다. 그러면 비용도 늘고 응답도 느려집니다. 라우터 단에서 작업 성격에 따라 모드를 가르는 설계가 안전합니다.
권장 추론 파라미터
모델 카드가 명시한 기본값입니다.
| 파라미터 | 권장값 |
|---|---|
| temperature | 1.0 |
| top-p | 0.95 |
| top-k | 40 |
| max new tokens | 40 (작업에 맞게 조정) |
코드 생성처럼 결정적인 출력을 원하면 temperature를 0.2~0.5로 낮추고, 창작 작업은 그대로 두는 식으로 운영하면 됩니다.
실무자가 볼 핵심 포인트
프로토타입 단계라면 Docker Model Runner나 Transformers 파이프라인이 가장 빠릅니다. 환경 변수 하나 안 만지고 모델 카드의 첫 번째 예제를 그대로 붙여 넣어도 동작합니다.
프로덕션을 본다면 vLLM과 SGLang 중에서 워크로드 패턴을 보고 고르세요. 단일 응답 처리량이 중요하면 vLLM, 멀티턴 에이전트·툴 콜이 많으면 SGLang이 잘 맞는 편입니다. 두 가지 모두 OpenAI 호환이라 클라이언트 코드를 따로 만들 필요가 없습니다.
GPU가 빠듯하다면 11종 양자화 중 자신의 VRAM에 맞는 GGUF를 골라 Ollama·LM Studio로 시작하세요. 1M 컨텍스트는 양자화 버전에서도 활용 가능하지만, 실제 컨텍스트 길이를 늘릴수록 KV 캐시가 빠르게 차오릅니다. 처음 도입할 때는 32k~128k 정도로 시작해 천천히 확장하는 게 안전합니다.
라이선스는 minimax-community입니다. 상용 사용 조건은 반드시 라이선스 원문을 확인하세요. 오픈웨이트라고 모두 같은 자유도를 주는 게 아니라는 점은 늘 그대로입니다.
원문 출처
원문: MiniMaxAI/MiniMax-M3 Model Card — Hugging Face