개요
영상 생성 모델은 다음 프레임을 그리는 데에는 점점 능숙해지고 있습니다. 그런데 카메라가 방 한 바퀴를 돌고 다시 원래 자리로 오면, 같은 벽인데도 모양이 달라져 있는 경우가 흔합니다. 마이크로소프트 리서치와 여러 대학이 함께 만든 Mirage는 이 문제를 정면으로 다룹니다. 색이 아니라 모델 내부의 ‘특징(feature)‘을 3차원 공간에 기억해 두는 방식입니다. 그 결과 속도는 최대 10.57배, 메모리 사용량은 55분의 1까지 줄였습니다.
핵심 요약
- Mirage는 카메라가 길게 움직여도 장면의 공간 구조를 유지하는 비디오 월드 모델입니다
- 기존 방식(Voyager, WonderWorld, Spatia)은 3D 포인트 클라우드에 색 정보를 채워 넣고, 매 단계마다 렌더링 → 다시 인코딩하는 이중 병목을 안고 있었습니다
- Mirage는 픽셀을 거치지 않고 잠재공간(latent) 의 특징을 그대로 3D 좌표에 묶어 둡니다
- 결과: 픽셀 메모리 대비 최대 10.57배 빠른 생성, 최대 55배 낮은 메모리
- 알리바바 오픈소스 모델 Wan2.2 위에 작은 모듈을 얹고 LoRA로 학습시켰습니다
- 한계: 움직이는 물체와 하늘은 메모리에 안 들어갑니다. 즉, 정적 장면일수록 효과가 큽니다
본문
영상 생성이 ‘코너 돌면 잊어버리는’ 이유
비디오 월드 모델은 출발 프레임 한 장과 카메라 경로를 받아 그럴듯한 영상을 그려냅니다. 시뮬레이션, 게임 환경, 자율주행 학습용 가상 도로 같은 데에 쓰이죠. 문제는 기억력입니다. 모델이 ‘내가 방금 본 공간’을 어딘가에 적어 두지 않으면, 카메라가 한 바퀴 돌아 같은 코너로 돌아왔을 때 가구 위치가 바뀌어 있거나 벽 무늬가 달라져 있습니다. 사람으로 치면 단기 기억만 가지고 방을 그리는 셈입니다.
Voyager·Spatia가 택한 길과 그 비용
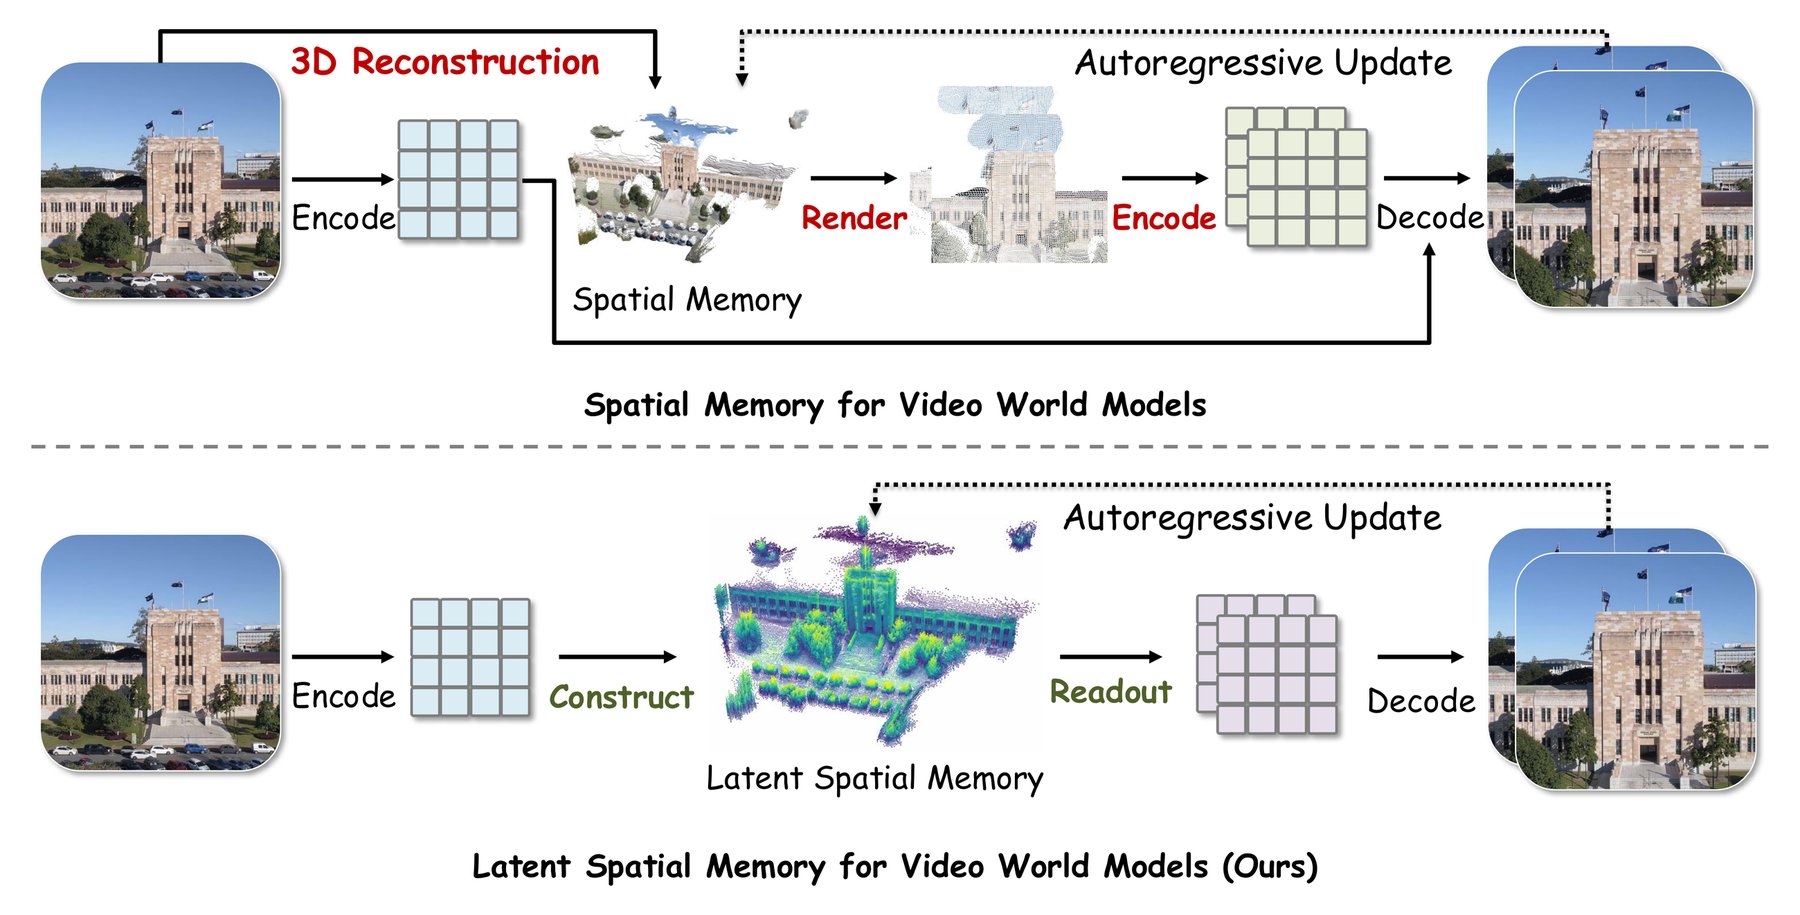
기존 시도들 — Voyager, WonderWorld, Spatia — 은 3D 포인트 클라우드에 색을 입혀 외부 메모리로 들고 다녔습니다. 다음 프레임을 만들 때마다 이 점 구름을 카메라 시점으로 렌더링하고, 그 결과 픽셀을 다시 모델이 이해할 수 있는 내부 표현으로 인코딩합니다. 마이크로소프트 논문은 이걸 이중 병목이라고 부릅니다. 매번 픽셀 공간을 한 번 들렀다 와야 하니 계산도 많이 들고, 그 과정에서 정보 손실도 누적됩니다.
Mirage가 잡은 지름길
Mirage는 색을 아예 저장하지 않습니다. 디퓨전 모델이 내부에서 이미 쓰고 있는 잠재 특징(latent feature) 을 3D 공간의 한 점에 그대로 묶어 둡니다. 새로운 시점에서 영상을 만들 때는 이 저장소를 목표 카메라 위치로 투영해서, 그 결과를 곧장 생성기에 넘깁니다. 픽셀로 그렸다가 다시 인코딩하는 단계가 통째로 빠집니다. 데이터도 풀해상도가 아니라 모델 내부의 압축된 해상도로 들고 다니니, 메모리도 자연스럽게 줄어듭니다.
기억은 영상이 진행될수록 쌓입니다
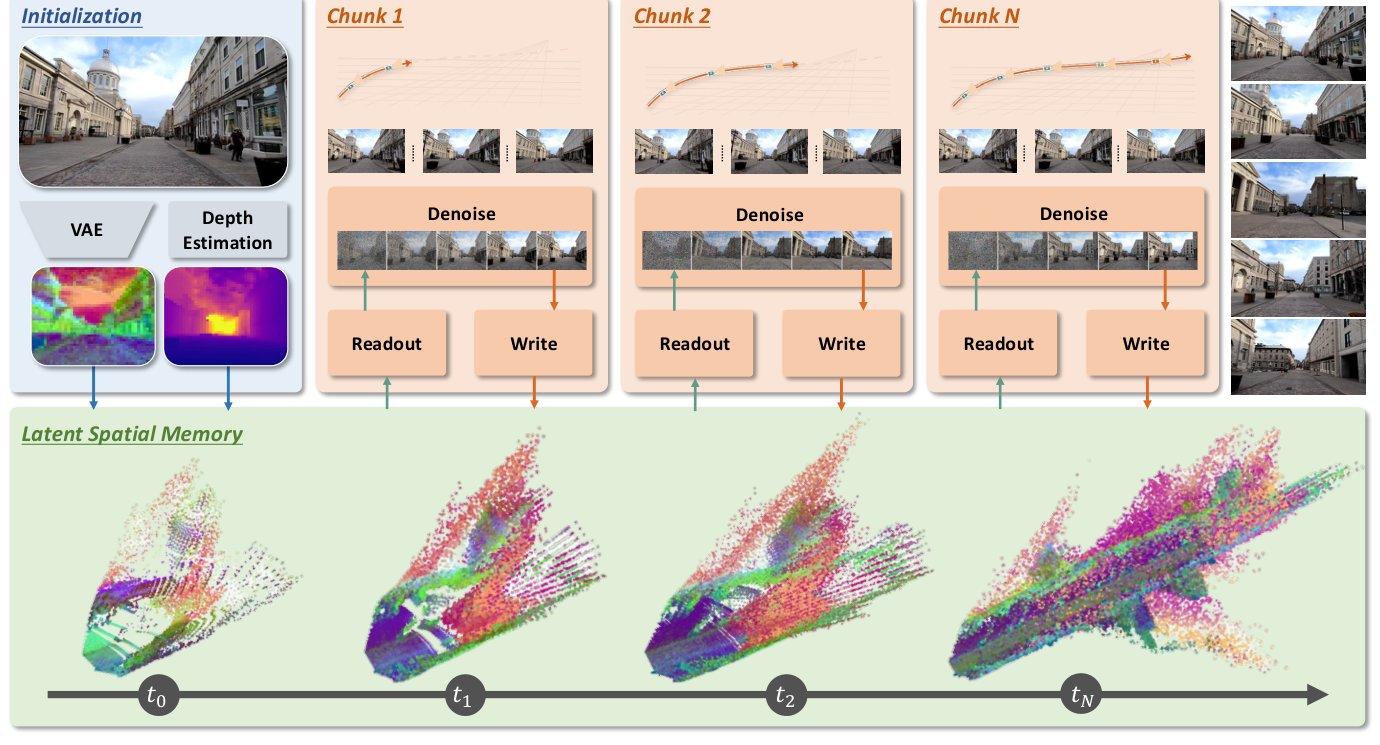
Mirage는 영상을 짧은 구간으로 쪼개 만듭니다. 시작 이미지로 첫 잠재 기억을 심어 두고, 다음 구간을 그릴 때는 그 기억에서 관련 부분을 꺼내 쓴 뒤 새로 만들어진 내용을 다시 캐시에 적어 둡니다. 영상이 진행될수록 메모리도 함께 커지는 구조입니다. 한 가지 장치를 더 둡니다. 움직이는 물체와 하늘은 메모리에 쓰기 전에 걸러 냅니다. 사람이 걸어 다니는 위치를 영원히 박제해 두면 안 되니, 신뢰할 수 있는 ‘고정된 기하’ 만 장기 기억으로 남깁니다.
어디에 얹어 만들었나
연구팀은 알리바바가 공개한 비디오 모델 Wan2.2 위에 작은 어댑터 모듈을 붙이고, 그 위에 LoRA로 본 모델을 미세조정했습니다. 처음부터 거대한 모델을 새로 학습시키지 않아도 된다는 점이 실용성을 키운 부분입니다.
벤치마크: Spatia를 넘었고, 일반 모델은 격차가 큽니다
WorldScore 벤치마크에서 Mirage는 가장 가까운 경쟁자인 Spatia(여전히 색 기반 메모리 사용)를 앞섰고, Wan2.1·CogVideoX 같은 일반 영상 생성 모델과는 격차가 큽니다. 특히 장면의 공간 구조를 일관되게 유지하는 능력과 표면(텍스처) 일관성에서 두드러집니다.
부동산 데이터셋인 RealEstate10K의 폐루프(closed-loop) 테스트 — 카메라가 출발점으로 돌아오는 가장 가혹한 조건 — 에서도 세 지표 중 두 개를 Mirage가 가져갔습니다. 작은 오차가 한 바퀴 도는 동안 누적되는 시나리오라, 공간 기억의 진가가 드러나는 자리입니다.
진짜 강점은 효율입니다
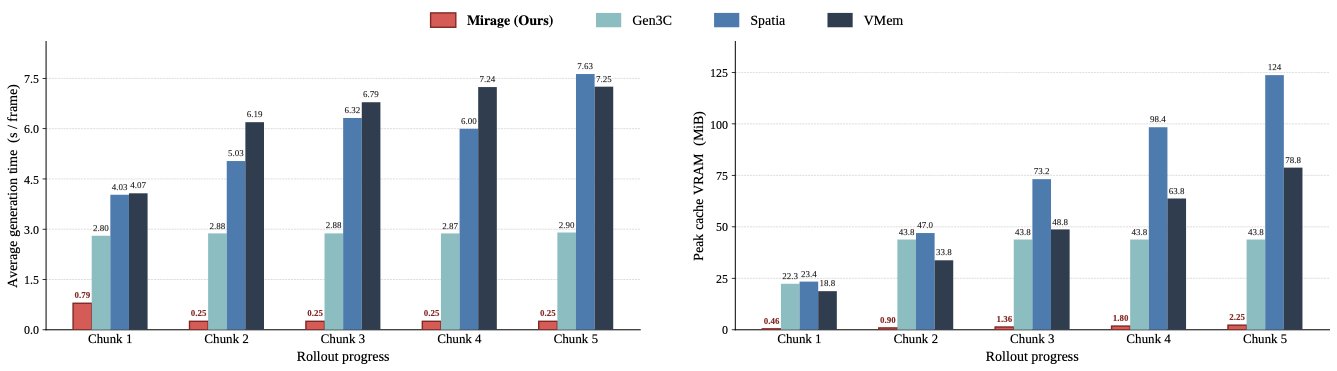
색 기반 메모리는 영상이 길어질수록 무거워집니다. 점이 늘어나니 그릴 것도, 인코딩할 것도 늘어나기 때문입니다. Mirage는 첫 구간 이후 프레임당 계산 비용이 거의 평평하게 유지됩니다. 논문이 제시한 수치로 최대 10.57배 빠른 생성, 최대 55배 적은 메모리입니다. 긴 영상으로 갈수록 격차는 더 벌어집니다.
그래서 어디가 약한가
연구팀은 한계를 숨기지 않습니다. 움직이는 객체는 구간 경계에서 버려집니다. 위치를 신뢰할 수 없는 것을 굳이 기억에 남기면 다음 프레임을 망치니까요. 그래서 거실·복도처럼 정적인 장면에서는 효과가 크지만, 사람이 북적이는 거리 같은 영상에서는 이득이 줄어듭니다. 팀이 꼽은 다음 과제도 ‘동적인 콘텐츠를 어떻게 안전하게 기억할 것인가’입니다.
실무자가 볼 핵심 포인트
- ‘세상을 시뮬레이션하는 AI’ 흐름에서 Mirage는 좋은 방향타입니다. 픽셀이 아니라 잠재공간에서 기억하는 게 결국 정공법이라는 신호입니다
- 자율주행·로보틱스·게임 환경 생성을 고민한다면, 픽셀 메모리를 들고 있는 파이프라인은 길어질수록 비용 폭발 위험이 크다는 점을 다시 생각해 볼 만합니다
- Wan2.2처럼 공개된 비디오 모델 위에 얇은 어댑터 + LoRA 만으로 새 능력을 붙였다는 점도 시사적입니다. 거대한 사전학습을 다시 돌릴 필요가 없습니다
- 단, 사람·차량처럼 움직이는 대상이 많은 시나리오에는 그대로 쓰기 어렵습니다. 동적 객체 전용 메모리를 별도로 설계해야 합니다
- 마이크로소프트가 GitHub에
Latent Spatial Memory저장소를 공개했고, 프로젝트 페이지에서 추가 자료를 받아볼 수 있습니다
원문 출처
- The Decoder: Microsoft Research’s Mirage gives video generation a persistent spatial memory that doesn’t forget what’s around the corner
- 논문 원문: arXiv (검색: “Mirage Latent Spatial Memory Video World Model”)
- GitHub: Microsoft / Latent Spatial Memory