핵심 요약
AI 에이전트 이야기는 보통 코딩 생산성에서 시작합니다. 그런데 Meta Engineering의 글 **“Capacity Efficiency at Meta”**는 조금 다른 현장을 보여줍니다. AI 에이전트가 코드를 더 빨리 쓰는 수준을 넘어, 하이퍼스케일 인프라의 성능 문제를 찾고 고치며 전력 낭비까지 줄이는 데 쓰이고 있다는 이야기입니다.
0.1% 성능 저하도 거대한 비용이 된다
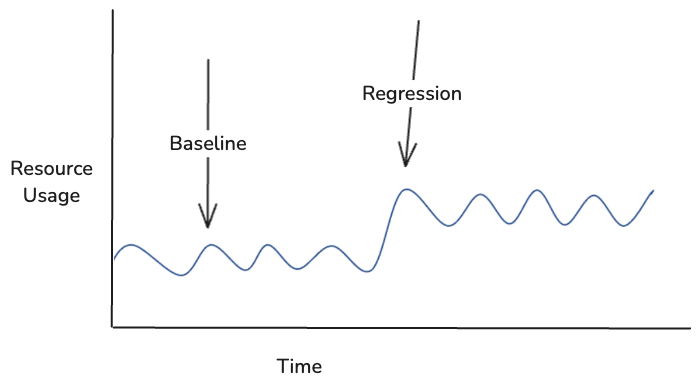
Meta처럼 30억 명 이상에게 서비스를 제공하는 환경에서는 아주 작은 성능 회귀도 큰 전력 소비로 이어집니다. 글에서는 0.1% 수준의 성능 저하도 대규모 인프라에서는 무시하기 어렵다고 설명합니다.
Meta의 Capacity Efficiency 조직은 이 문제를 두 방향으로 봅니다. 하나는 offense, 즉 기존 시스템에서 더 효율적으로 만들 수 있는 기회를 찾아 코드 변경으로 연결하는 일입니다. 다른 하나는 defense, 즉 배포 후 생긴 성능 회귀를 감지하고 원인을 찾아 완화하는 일입니다.
두 흐름 모두 오래전부터 도구는 있었습니다. 병목은 도구가 아니라 사람의 시간입니다. 프로파일링 데이터를 보고, 최근 PR과 설정 변경을 추적하고, 문서를 뒤지고, 어떤 최적화 패턴이 맞는지 판단하는 데 엔지니어 시간이 많이 들어갑니다.
Meta의 해법: 도구와 스킬을 분리한 통합 에이전트 플랫폼
Meta가 발견한 핵심은 offense와 defense가 생각보다 같은 구조를 갖고 있다는 점입니다. 둘 다 데이터를 모으고, 맥락을 해석하고, 적절한 최적화 패턴을 적용하고, 코드 변경으로 이어져야 합니다.
그래서 Meta는 별도 AI 시스템 두 개가 아니라 하나의 통합 플랫폼을 만들었습니다. 이 플랫폼은 크게 두 층으로 구성됩니다.
첫째는 MCP Tools입니다. LLM이 프로파일링 데이터 조회, 실험 결과 확인, 설정 이력 탐색, 코드 검색, 문서 추출 같은 작업을 표준 인터페이스로 호출할 수 있게 합니다.
둘째는 Skills입니다. 스킬은 성능 효율화에 대한 도메인 지식을 담습니다. 예를 들어 특정 지연 시간 회귀에서는 GraphQL 엔드포인트를 먼저 확인하라거나, 직렬화 관련 함수라면 최근 스키마 변경을 보라는 식의 판단 패턴입니다.
Defense: 회귀를 찾고 바로 수정 PR까지 만든다
Meta의 FBDetect는 노이즈가 많은 프로덕션 환경에서도 0.005% 수준의 성능 회귀를 잡아내는 내부 도구입니다. 기존에는 회귀를 감지한 뒤 원인이 되는 PR을 찾고, 담당 엔지니어가 직접 대응해야 했습니다.
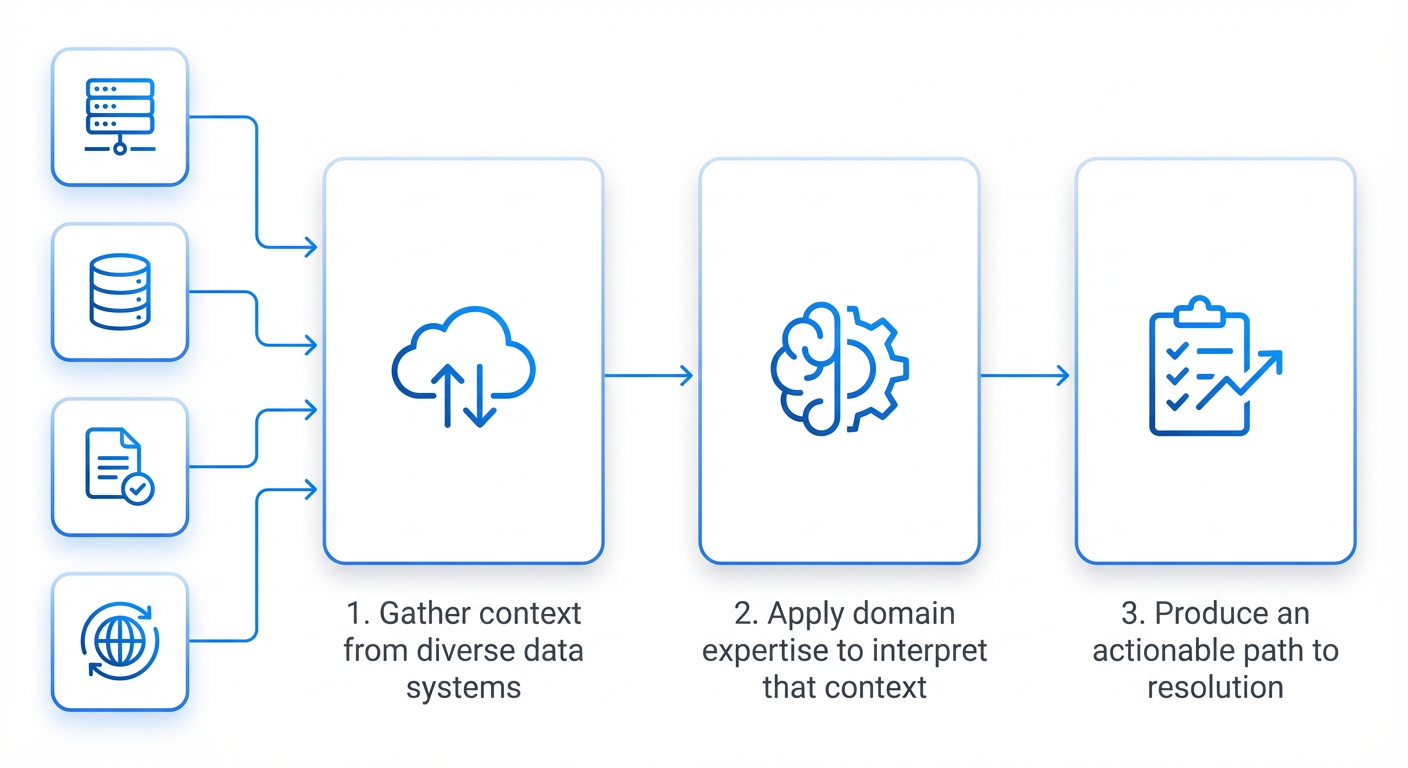
여기에 AI Regression Solver가 붙었습니다. 이 에이전트는 회귀 증상과 영향을 받은 함수, 원인이 된 PR의 파일과 라인을 수집합니다. 그 다음 코드베이스와 회귀 유형에 맞는 스킬을 적용해 완화 방안을 만들고, 최종적으로 원 작성자가 리뷰할 수 있는 수정 PR을 생성합니다.
Offense: 최적화 기회를 코드 변경으로 연결한다
공격 측면에서도 비슷합니다. Meta는 효율화 기회를 발견하면, AI 에이전트가 관련 메타데이터, 최적화 패턴 문서, 과거 예시, 대상 파일과 함수, 검증 기준을 모읍니다. 이후 특정 최적화 유형에 맞는 스킬을 적용해 후보 코드를 만들고, 문법과 스타일을 확인한 뒤 엔지니어가 바로 적용할 수 있는 형태로 제시합니다.
중요한 점은 defense와 offense가 같은 도구를 공유한다는 것입니다. 프로파일링 데이터, 문서, 코드 검색은 그대로 쓰고, 문제 유형에 따라 스킬만 달라집니다. 이 구조 덕분에 새로운 에이전트나 기능을 만들 때 데이터 통합을 매번 새로 하지 않아도 됩니다.
실무자가 볼 포인트
이 글에서 가장 중요한 메시지는 “AI 에이전트 하나가 모든 걸 한다”가 아닙니다. 진짜 포인트는 도구 인터페이스를 표준화하고, 도메인 지식을 스킬로 분리했을 때 에이전트 활용 범위가 복리처럼 늘어난다는 점입니다.
Meta는 이 구조로 수백 메가와트 규모의 전력을 회수했다고 말합니다. 수동으로 약 10시간 걸리던 회귀 조사가 약 30분으로 줄어드는 사례도 언급합니다. 더 중요한 건 엔지니어가 “어디서부터 봐야 하지?”에서 출발하지 않아도 된다는 점입니다. AI가 조사 초안을 만들고, 사람은 고영향 수정안을 검토하고 배포하는 쪽으로 이동합니다.
기업이 AI 에이전트를 도입할 때도 같은 질문이 필요합니다. 모델을 고르기 전에, 우리 조직의 반복 조사 업무는 무엇인지, 어떤 도구 호출이 표준화될 수 있는지, 어떤 전문가 판단을 스킬로 만들 수 있는지부터 봐야 합니다.
결론
Meta의 사례는 AI 에이전트가 단순한 코드 생성 도구를 넘어 운영 효율화 시스템이 될 수 있음을 보여줍니다. 특히 하이퍼스케일 환경에서는 작은 성능 개선도 전력, 비용, 엔지니어 시간에 큰 영향을 줍니다.
앞으로의 에이전트 경쟁력은 모델 자체보다 표준화된 도구, 축적된 스킬, 그리고 실제 운영 문제에 연결되는 워크플로우에서 갈릴 가능성이 큽니다. 겅허게 말하면, 좋은 에이전트는 똑똑한 챗봇이 아니라 조직의 반복 병목을 줄이는 운영 시스템에 가깝습니다.
원문: Capacity Efficiency at Meta: How Unified AI Agents Optimize Performance at Hyperscale