출처: Mem0
문서유형: 번역·해설
#Mem0 #AgentMemory #AIAgent #LLMOps
핵심 요약
많은 AI 에이전트는 처음에 MEMORY.md, CLAUDE.md, .cursorrules 같은 파일 하나로 기억을 시작합니다. 작고 단순할 때는 이 방식이 빠르고 투명합니다. 문제는 사용자가 늘고, 기억이 쌓이고, 여러 에이전트가 동시에 쓰기 시작하는 순간부터입니다.

파일 메모리가 매력적인 이유
파일 기반 메모리는 시작하기 쉽습니다. 인프라가 필요 없고, 사람이 직접 열어볼 수 있고, Git으로 관리하기도 편합니다. 개인용 코딩 에이전트가 “탭 대신 스페이스를 쓴다”거나 “프로젝트는 TypeScript 기반이다” 정도를 기억하는 데는 충분합니다.
정적인 규칙에도 잘 맞습니다. 바뀌지 않는 코딩 규칙, 팀 컨벤션, 디자인 시스템 지침처럼 읽기만 하면 되는 정보라면 파일이 오히려 가장 단순한 선택입니다.
하지만 규모가 커지면 문제가 달라진다
Mem0가 지적하는 첫 번째 벽은 컨텍스트 창입니다. 파일 메모리는 보통 전체를 한 번에 읽습니다. 기억이 50개일 때는 괜찮지만, 500개, 2,000개, 10,000개가 되면 답변 전에 메모리 파일만으로 컨텍스트를 태워버립니다. 관련 없는 기억까지 모두 넣는 셈입니다.
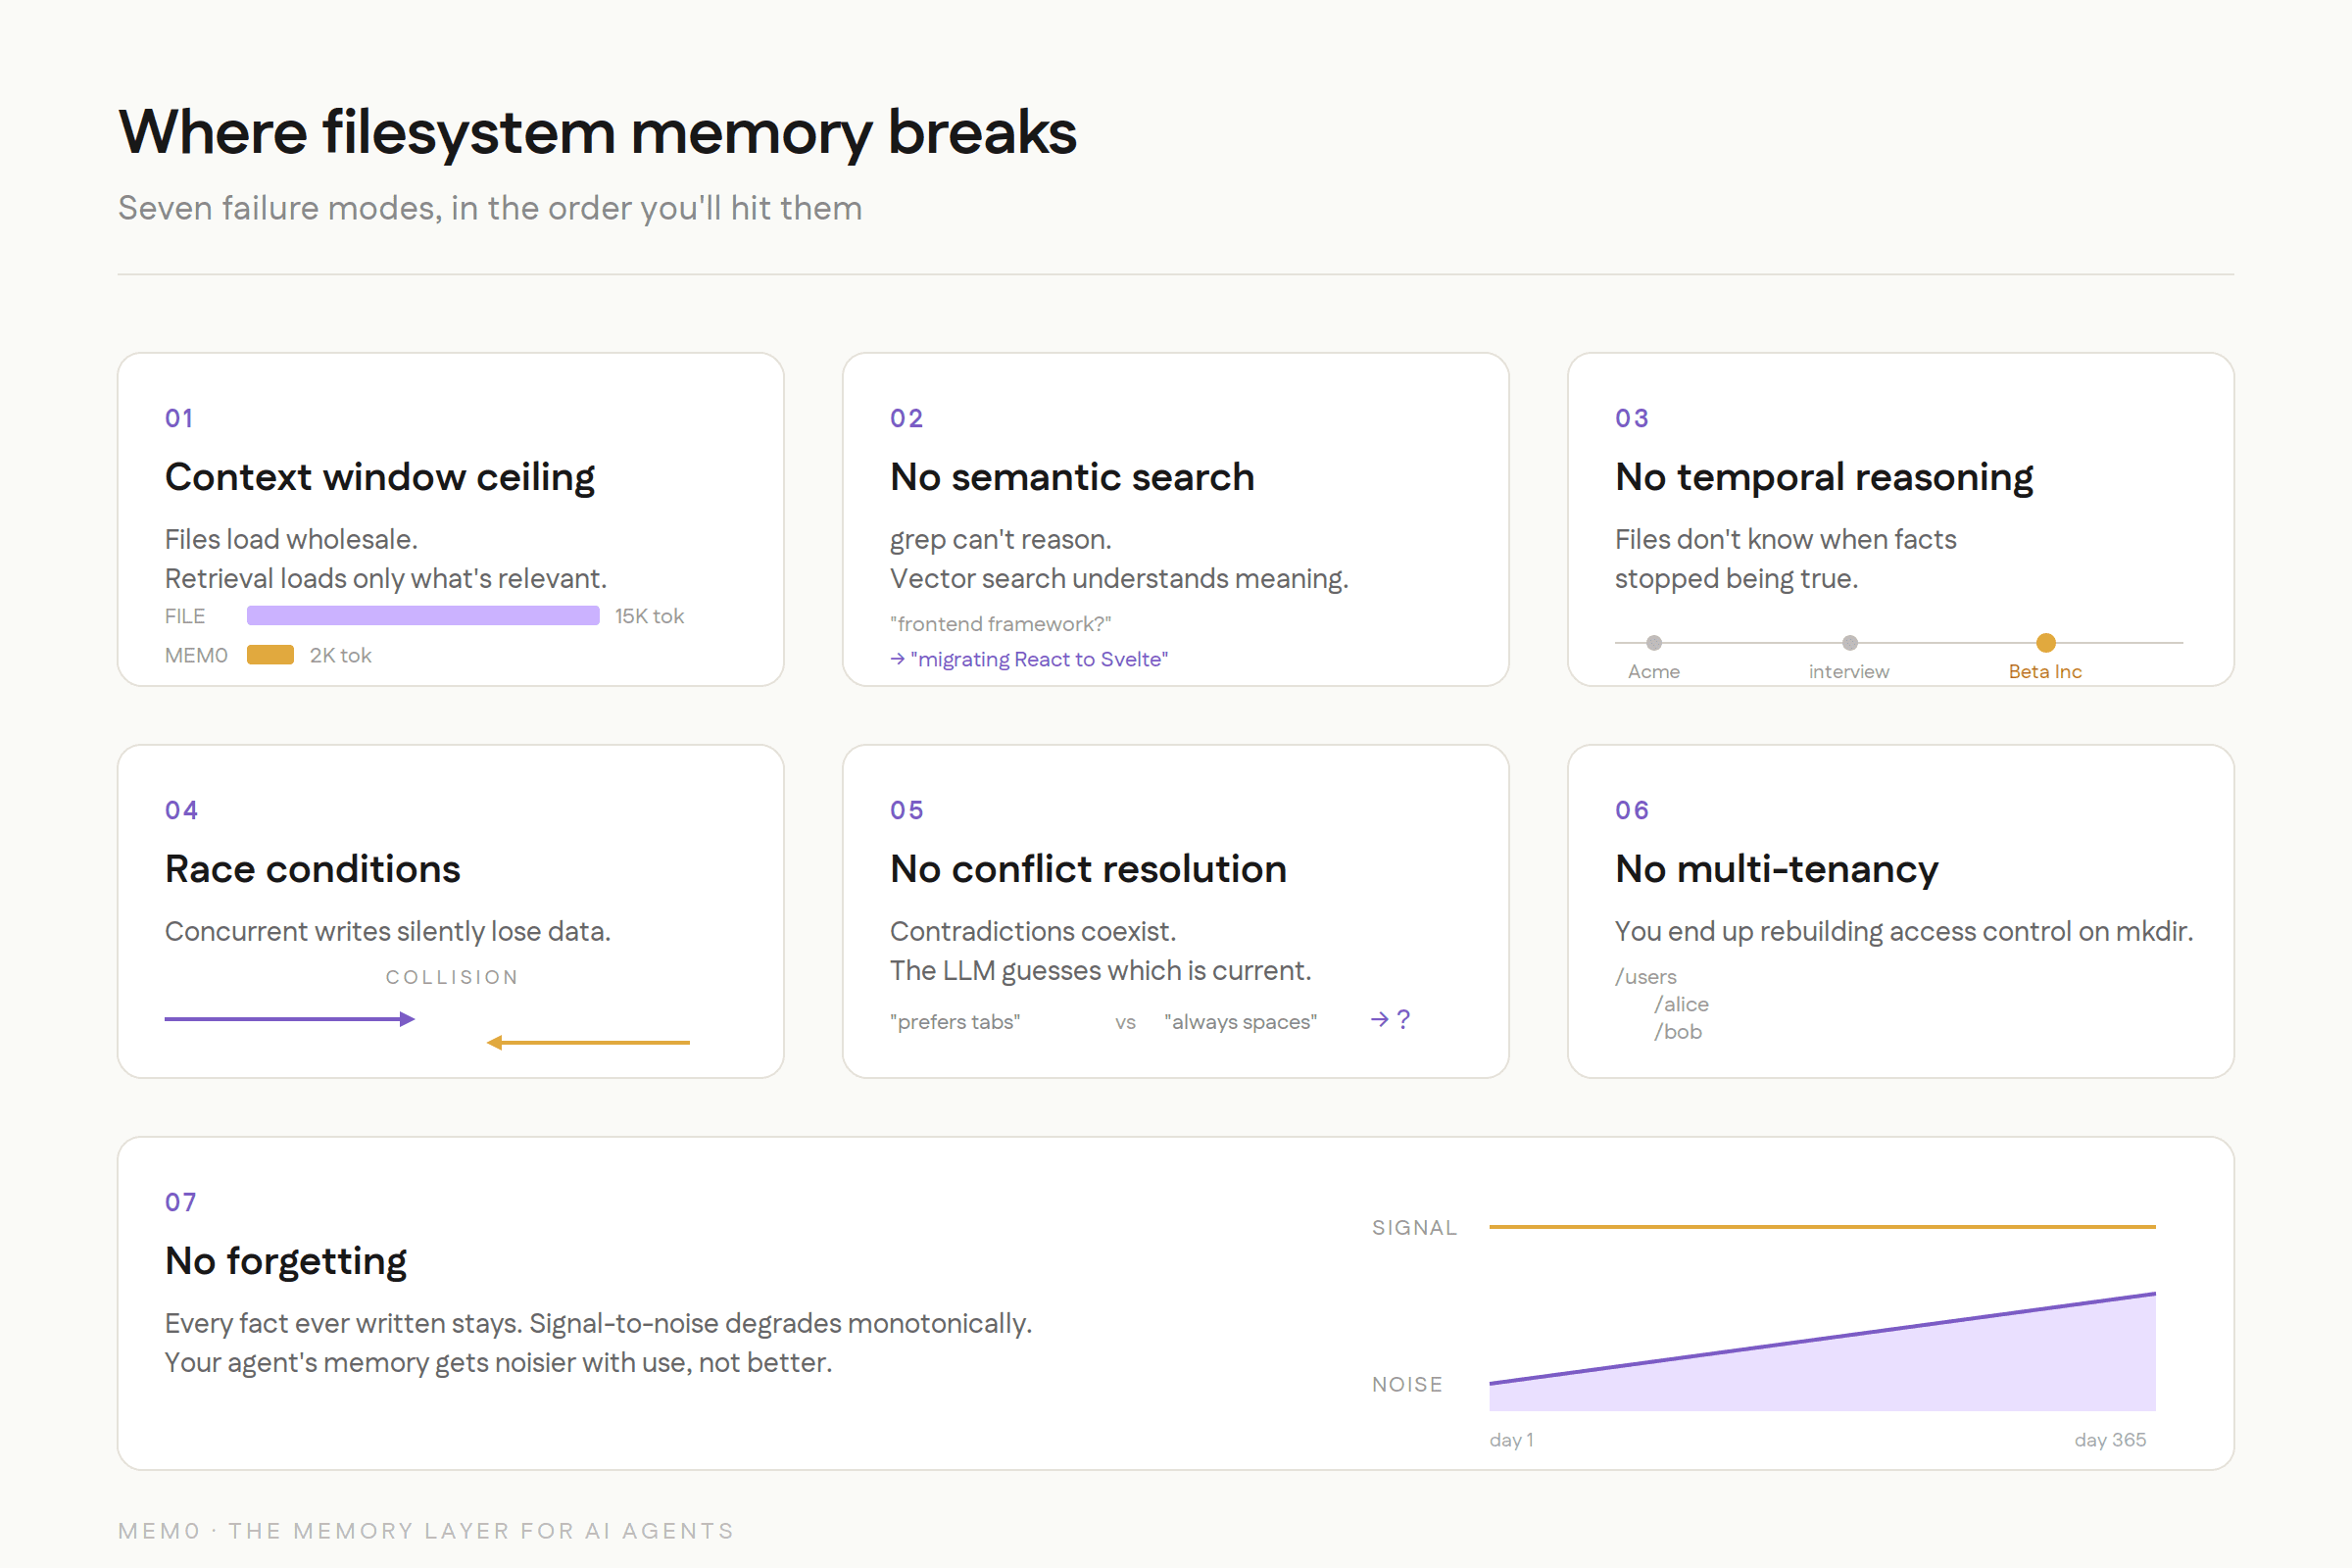
두 번째는 검색입니다. 파일은 의미를 이해하지 못합니다. grep은 키워드를 찾을 수 있지만, “프론트엔드 프레임워크”라는 질문과 “React에서 Svelte로 이전 중”이라는 기억을 자연스럽게 연결하지 못합니다. 그래서 결국 벡터 검색, 인덱싱, 동기화 로직을 따로 붙이게 됩니다. 그 순간부터는 사실상 작은 데이터베이스를 직접 만들고 있는 겁니다.
시간, 충돌, 동시성도 파일에는 어렵다
기억은 시간이 지나며 바뀝니다. 사용자는 회사를 옮기고, 프로젝트는 DB를 바꾸고, 선호도도 달라집니다. 파일에 “예전에는 PostgreSQL을 썼다”와 “이제 CockroachDB로 이전했다”가 함께 있으면, 모델은 어느 쪽이 현재 사실인지 추측해야 합니다.
동시성도 문제입니다. 두 에이전트가 같은 파일을 동시에 읽고 쓰면 한쪽 변경이 조용히 사라질 수 있습니다. 데이터베이스가 트랜잭션과 락, MVCC로 해결한 문제를 파일 위에서 다시 겪는 셈입니다.
실무자가 볼 포인트
파일 메모리는 나쁜 선택이 아닙니다. 다만 맞는 범위가 있습니다. 개인용, 소규모, 정적 규칙, 단일 작성자라면 파일이 가장 빠릅니다. 반대로 다중 사용자, 권한 분리, 의미 검색, 오래된 기억 정리, 충돌 해결, 감사 로그가 필요하면 전용 메모리 시스템을 검토해야 합니다.
중요한 기준은 간단합니다. “이 기억을 전부 매번 읽어도 되는가?” “누가 썼고 언제까지 유효한지 알아야 하는가?” “서로 모순되는 기억을 자동으로 정리해야 하는가?” 이 질문에 하나라도 그렇다고 답하면 파일 하나로 버티기 어렵습니다.
정리
파일 기반 메모리는 AI 에이전트 메모리의 hello world입니다. 시작점으로는 훌륭하지만, 제품이 커지면 데이터베이스가 필요했던 역사와 같은 길을 걷습니다. 에이전트가 오래 일하고 많은 사용자를 상대하려면, 기억도 단순 파일이 아니라 검색·시간·권한·충돌·망각을 다루는 인프라가 되어야 합니다.
원문 : Your AI Agent’s Memory Is Just a File? That’s the Problem