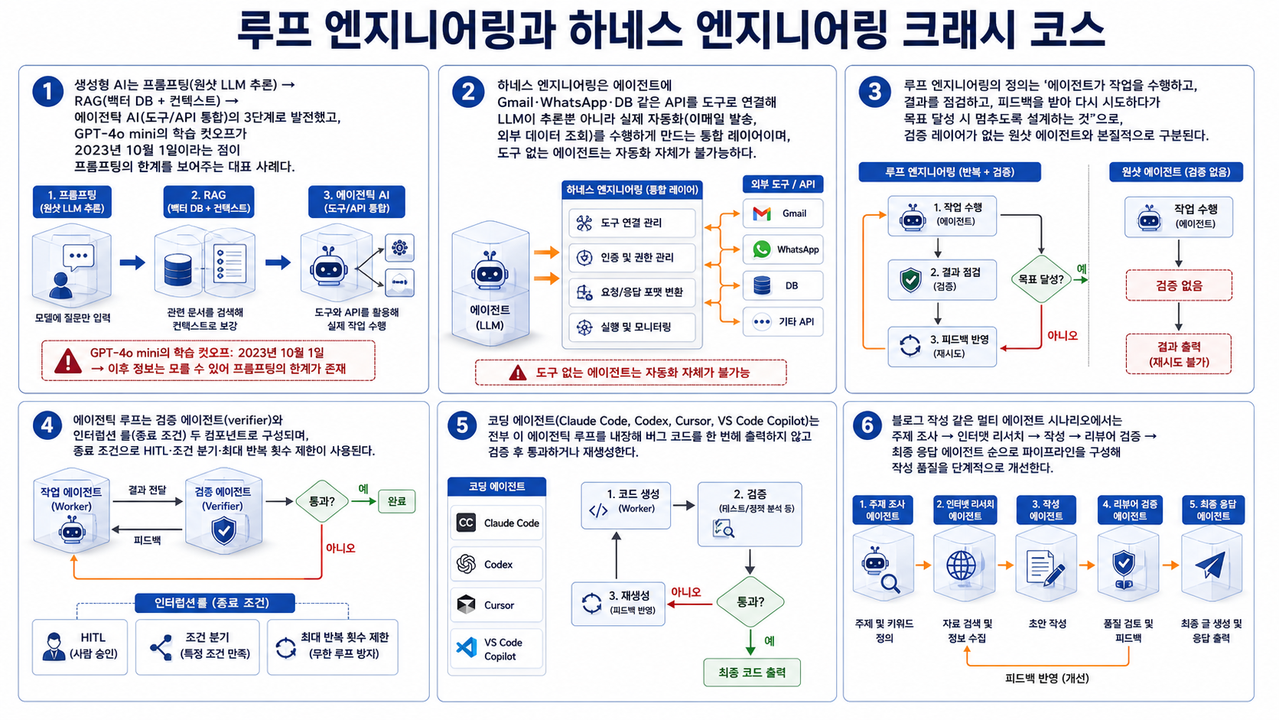
생성 에이전트와 검증 에이전트를 분리하고 멈출 조건을 붙이는 순간, 같은 모델을 써도 결과물의 신뢰도가 달라진다.
크래시 코스가 정의한 두 용어
Krish Naik 채널에 3.5시간 분량의 크래시 코스 ‘Loop Engineering And Harness Engineering Crash Course’가 공개됐다. 진행은 Krishna Academy 강사 Bappy가 맡았고, 도입부 전체를 두 용어의 정의와 경계 긋기에 쓴다. 강의가 처음부터 끝까지 붙들고 가는 주장은 하나다 — 에이전트의 신뢰성은 모델 크기가 아니라 도구 통합과 자기 수정 루프의 결합에서 나온다.
강의는 생성형 AI 애플리케이션을 세 단계로 나눠 놓고 출발한다. 첫째는 프롬프팅이다. 질문 하나를 던지고 답 하나를 받는 원샷 추론이다. 둘째는 RAG(Retrieval Augmented Generation, 외부 문서를 검색해 답변 근거로 붙여 주는 방식)다. 셋째가 에이전틱 AI, 즉 모델에 도구와 API를 연결해 실제 작업까지 수행하게 만드는 단계다.
프롬프팅의 한계를 설명하면서 강의가 든 사례는 학습 컷오프다. GPT-4o mini의 학습 데이터는 2023년 10월 1일에서 끊긴다. 그 이후에 벌어진 일은 모델 안에 없다. 질문을 아무리 정교하게 다듬어도 존재하지 않는 지식이 생겨나지는 않는다. 게다가 프롬프팅은 답을 문장으로 뱉을 뿐, 그 답에 따라 무언가를 실행하지는 못한다.
RAG는 이 중 앞쪽 문제를 푼다. 벡터 데이터베이스(문서를 숫자 벡터로 바꿔 의미가 가까운 것끼리 찾아 주는 저장소)에 최신 자료를 넣어 두고, 질문이 들어올 때 관련 조각을 꺼내 컨텍스트로 함께 밀어 넣는다. 모델이 몰랐던 사실을 답변 시점에 공급하는 구조다. 다만 RAG가 채워 주는 것은 어디까지나 읽을 거리다. 메일을 보내거나, 사내 DB를 조회하거나, 결과를 어딘가에 기록하는 일은 여전히 사람 몫으로 남는다.
하네스 엔지니어링은 바로 이 남은 절반을 담당한다. 에이전트에 Gmail, WhatsApp, 데이터베이스 같은 API를 도구로 물려 주는 통합 레이어를 가리키는 이름이다. 도구가 붙는 순간 에이전트는 추론기에서 실행기로 바뀐다. 반대로 도구가 하나도 없는 에이전트는 아무리 좋은 모델을 써도 자동화를 시작할 수 없다. 강의는 이 지점을 분명히 한다 — 자동화의 가능 여부를 가르는 것은 모델이 아니라 하네스다.
그리고 하네스만으로는 품질이 보장되지 않는다는 데서 두 번째 용어가 나온다. 도구를 다 붙여 놓아도 에이전트가 처음 내놓은 결과가 맞는지는 아무도 확인하지 않았다. 여기서 필요한 것이 결과를 점검하고 다시 고치게 만드는 설계, 곧 루프 엔지니어링이다.
에이전틱 루프의 구성 요소
강의가 내놓은 루프 엔지니어링의 정의는 짧다. 에이전트가 작업을 수행하고, 결과를 점검하고, 피드백을 받아 다시 시도하다가, 목표에 도달하면 멈추도록 설계하는 것. 문장으로 옮기면 generate → check → improve → repeat 네 박스가 돌아가는 구조다. 검증 레이어가 없는 원샷 에이전트와 갈라지는 지점이 정확히 여기다.
Bappy는 이 구조를 교실에 비유한다. 학생이 답안을 제출하고, 교사가 틀린 곳을 짚어 돌려주고, 학생이 그걸 반영해 다시 낸다. 통과하면 끝난다. 강의는 여기에 Claude Code 공식 문서의 루프 다이어그램을 겹쳐 놓으며, 상용 코딩 에이전트가 실제로 이 모양으로 돈다는 점을 보여 준다.
- 루프는 생성 에이전트와 검증 에이전트(verifier)를 분리하는 데서 시작한다. 같은 에이전트가 자기 답을 채점하면 통과 판정만 반복되기 쉽다.
- 검증 결과가 기준에 못 미치면 그 피드백이 다시 생성 에이전트의 입력으로 들어간다. 한 번 더 부르는 게 아니라, 무엇이 틀렸는지를 붙여서 부른다.
- 루프에는 반드시 종료 조건(인터럽션 룰)이 있어야 한다. 강의가 든 방법은 세 가지다 — 사람 승인(HITL, Human In The Loop), 명시적 조건 분기, 최대 반복 횟수 제한.
- Claude Code·Codex·Cursor·VS Code Copilot 등 코딩 에이전트는 전부 이 패턴을 내장한다. 버그가 있는 코드를 한 번에 내놓고 끝내는 대신, 검증을 통과할 때까지 다시 만든다.
- 반복 한 번마다 LLM 토큰이 추가로 소비된다. 코딩 에이전트 서비스가 대부분 유료인 구조적 이유가 여기 있다는 것이 강의의 설명이다.
세 번째 항목은 실무에서 가장 자주 빠뜨리는 부분이다. 검증 에이전트만 붙이고 종료 조건을 안 정하면, 기준을 영원히 못 넘기는 입력이 들어왔을 때 루프가 스스로 멈추지 못한다. 그 상태로 밤새 돌면 청구서가 남는다. 강의가 검증 에이전트와 인터럽션 룰을 늘 한 쌍으로 묶어 말하는 이유다.
다섯 번째 항목은 방향을 뒤집어 읽어야 한다. 루프가 비싸다는 사실은 루프를 쓰지 말라는 뜻이 아니라, 아무 데나 쓰지 말라는 뜻이다. 강의는 검증이 필요 없는 작업을 명시적으로 골라낸다. 여행 일정을 짜 달라는 요청이나 단순 질의응답에는 루프가 필요 없다. 틀렸을 때 사용자가 즉시 알아채고, 고치는 비용도 거의 0이기 때문이다.
반대로 코드 생성과 콘텐츠 작성은 오류가 조용히 통과한다. 컴파일은 되는데 논리가 틀린 코드, 문장은 매끄러운데 사실이 틀린 원고 — 사람이 검토하기 전까지 드러나지 않는다. 이런 작업이 루프에 토큰을 더 쓸 가치가 있는 영역이다.
3단계로 만드는 최소 루프
개념만 이해하고 넘어가면 코드로 옮길 때 막힌다. 강의가 제시한 요소들을 실행 가능한 순서로 재구성하면 다음 세 단계가 된다. 셋 다 프레임워크를 새로 배우지 않아도 반나절이면 돌려 볼 수 있는 크기다.
1단계 — 3노드 그래프로 뼈대를 세운다
LangGraph, CrewAI, AutoGen 가운데 익숙한 것을 하나 고른다. 노드는 세 개만 만든다. 생성 노드, 검증 노드, 조건 분기 노드다. 생성 노드는 작업 결과물을 만들고, 검증 노드는 그 결과물을 받아 합격 여부와 사유를 함께 돌려주고, 분기 노드는 합격이면 종료로, 불합격이면 다시 생성 노드로 흐름을 보낸다.
이때 검증 노드의 반환값을 불리언 하나로 만들지 않는 편이 낫다. 통과 여부와 함께 ‘무엇이 왜 부족한지’를 문자열로 받아야 다음 생성 호출의 프롬프트에 그대로 붙일 수 있다. 피드백 없이 재시도만 하면 같은 결과가 다시 나온다.
2단계 — 합격 기준을 코드로 못 박는다
검증 에이전트에 ‘잘 썼는지 봐 줘’ 같은 지시를 주면 판정이 호출마다 흔들린다. 기준을 숫자로 적어야 루프가 수렴한다. 강의가 블로그 자동화 예시로 든 기준은 출처 3개 이상, 길이 1,000자 이상 같은 형태다. 도메인에 맞춰 바꾸되, 사람이 눈으로 세어 확인할 수 있는 항목으로 정하는 게 핵심이다.
코드 생성이라면 판정 기준을 모델 판단에 맡기지 말고 실제 실행 결과로 대체할 수 있다. 테스트 통과 여부, 린터 오류 개수, 타입 체크 결과처럼 이미 이진 판정을 내려 주는 도구가 있다면 그쪽이 검증 에이전트보다 싸고 정확하다.
3단계 — 종료 조건을 두 겹으로 건다
최대 반복 횟수를 먼저 정한다. max_iterations=5처럼 상수로 박아 두면 최악의 경우에도 비용 상한이 계산된다. 그 위에 사람 승인(HITL)을 한 겹 더 얹는다. 반복이 상한에 닿았는데도 기준을 못 넘겼다면, 조용히 실패하거나 마지막 결과를 그냥 내보내는 대신 사람에게 넘긴다.
두 겹으로 거는 이유는 각각이 막는 사고가 다르기 때문이다. 반복 상한은 토큰 폭증을 막고, 사람 승인은 기준 미달 결과물이 그대로 발행되는 사고를 막는다. 어느 한쪽만 있으면 나머지 한 종류의 사고는 그대로 남는다.
세 단계가 돌아가면 여기서 멀티 에이전트로 확장하는 길이 열린다. 강의가 든 블로그 작성 파이프라인은 주제 조사 → 인터넷 리서치 → 작성 → 리뷰어 검증 → 최종 응답 순서다. 리서치 단계에는 tavily나 serp 같은 검색 도구를 붙이고, 리뷰어 에이전트를 verifier 자리에 놓는다. 역할을 쪼갠 뒤 검증만 따로 세우는 이 배치가 실전에서 가장 자주 쓰이는 형태다.
원샷 에이전트와 루프 에이전트
두 방식의 차이를 항목별로 놓고 보면 어디에 무엇을 쓸지가 선명해진다.
| 비교 항목 | 원샷 에이전트 | 루프 에이전트 |
|---|---|---|
| 실행 구조 | 생성 1회 후 종료 | generate → check → improve → repeat |
| 검증 주체 | 없음(사용자가 사후 확인) | 별도 검증 에이전트(verifier) |
| 종료 조건 | 불필요 | 필수(HITL·조건 분기·최대 반복) |
| 토큰 비용 | 호출 1회분 | 반복 횟수에 비례해 증가 |
| 적합한 작업 | 여행 일정, 단순 질의응답 | 코드 생성, 블로그·리포트 작성 |
| 실패가 드러나는 시점 | 사람이 읽을 때 | 루프 안에서 |
종료 조건 세 가지도 성격이 서로 다르다. 하나만 골라 쓰기보다 조합하는 쪽이 안전한 이유가 표에 드러난다.
| 종료 조건 | 멈추는 시점 | 막아 주는 문제 | 사람 개입 |
|---|---|---|---|
| HITL(사람 승인) | 사람이 통과 판정할 때 | 기준 미달 결과물 발행 | 필요 |
| 명시적 조건 분기 | 검증 기준 충족 시 | 불필요한 추가 반복 | 불필요 |
| 최대 반복 횟수 | 상한 도달 시 | 무한 루프, 토큰 폭증 | 불필요 |
표의 마지막 열을 보면 조합 방식이 정해진다. 조건 분기와 반복 상한은 자동으로 돌아가니 기본값으로 깔아 두고, HITL은 결과물이 외부로 나가는 지점 — 발행, 배포, 발송 직전 — 에만 붙이면 된다. 모든 반복마다 사람을 부르면 자동화의 의미가 사라진다.
비용 쪽도 표에 있는 대로다. 루프 에이전트의 비용은 반복 횟수에 비례한다. 상한을 5로 잡으면 최악의 경우 원샷의 다섯 배가 아니라, 검증 호출까지 더해 그보다 크다. 자체 에이전트를 설계할 때 이 곱셈을 미리 해 두지 않으면 프로토타입에서는 싸 보이던 구조가 운영에서 감당이 안 된다.
검증을 외부에 맡기는 실험
강의 도입부에는 스폰서 세그먼트로 ApoDex라는 딥 리서치 시스템이 소개된다. 광고 구간이므로 성능 수치는 제조사 발표값으로 읽어야 하지만, 구조 자체는 루프 엔지니어링의 확장판으로 볼 만하다.
ApoDex는 최대 150개의 전문 서브 에이전트와 독립 검증 에이전트를 동시에 운영하고, 딥 리서치·딥 솔브·딥 디스커버 3단 구조로 동작한다고 소개됐다. 발표된 데모는 NVIDIA AI GPU 시장 점유율 예측이었고, 35분 동안 432개 주장과 961개 증거를 검증했다는 수치가 함께 제시됐다. 디스커버 모드의 벤치마크 값으로는 BrowseComp 90.3, Frontier Science Olympiad 87.4가 언급됐다.
여기서 주목할 대목은 점수가 아니라 배치다. 생성 에이전트를 잔뜩 늘리면서 검증 에이전트를 그 바깥에 독립적으로 세웠다는 점 — 앞서 본 최소 루프의 ‘생성과 검증 분리’ 원칙을 규모만 키워 그대로 적용한 형태다. 주장 432개에 증거 961개를 붙였다는 비율도 주장 하나당 증거 두 개 남짓을 요구했다는 뜻으로 읽힌다.
이 구조를 자체 파이프라인에 적용해 볼 여지도 있다. 외부 딥 리서치 시스템의 산출물을 내부 루프의 verifier 입력으로 넣어 검증 근거로 쓰는 하이브리드 배치다. 다만 강의에서 실제로 시연된 방식은 아니고 여기서 파생시킨 응용안이므로, 효과는 직접 재 봐야 하는 추정에 해당한다.
지금 할 두 가지
첫째, 이미 쓰고 있는 코딩 에이전트의 종료 조건을 확인하고 손댄다. Claude Code든 Cursor든 Codex든 내부에 루프가 돌고 있으므로, 최대 반복 횟수와 사람 승인 지점이 어떻게 설정돼 있는지 설정 화면에서 찾아본다. 기본값이 무제한에 가깝다면 상한을 걸고, 파일 쓰기나 커밋처럼 되돌리기 번거로운 동작 앞에 승인 단계를 둔다. 이 작업은 새로 만드는 게 없어 몇 분이면 끝난다.
둘째, 반복 작업 하나를 골라 3노드 그래프로 옮겨 본다. 매주 쓰는 리포트든 정기 리서치든, 결과를 사람이 검토해 되돌려 보내고 있는 작업이면 후보가 된다. 생성 노드와 검증 노드를 나누고, 합격 기준을 숫자로 적고, max_iterations=5와 마지막 사람 승인을 건다. 첫 판에서 노릴 것은 품질 향상이 아니라 루프가 제대로 멈추는지 확인하는 일이다.
적용 대상을 고를 때 기준은 하나로 충분하다. 틀렸을 때 즉시 드러나는 작업이면 원샷으로 두고, 조용히 통과해 나중에 문제가 되는 작업이면 루프를 붙인다. 여행 일정과 코드 생성을 갈라놓은 강의의 기준이 그대로 쓰인다.
세 줄 정리
하네스 엔지니어링은 에이전트에 도구를 붙여 자동화를 가능하게 만들고, 루프 엔지니어링은 그 결과를 검증해 신뢰할 수 있게 만든다. 루프의 최소 부품은 생성과 분리된 검증 에이전트, 그리고 사람 승인·조건 분기·최대 반복 횟수로 구성되는 종료 조건 두 가지다. 반복마다 토큰이 더 드는 만큼, 오류가 조용히 통과하는 작업에만 골라서 적용하는 것이 비용 대비 효과가 가장 크다.
원문 출처
원문: 영상 원문 보기 — “Loop Engineering And Harness Engineering Crash Course”, Krish Naik