구글이 LiteRT-LM을 전면에 내세웠다. 핵심은 단순하다. LLM을 서버로 보내지 않고, Android·iOS·브라우저 안에서 빠르게 돌리겠다는 것이다. 원문이 제시한 숫자는 꽤 공격적이다. Gemma 4 E2B 기준 Android GPU 52 tokens/sec, iOS Metal 56 tokens/sec, WebGPU에서는 최대 76 tokens/sec까지 언급한다.
LiteRT-LM 공식 메인 이미지. Source: Google Developers Blog
목차
- 핵심 요약
- 온디바이스 LLM의 병목은 모델만이 아니다
- 속도의 핵심: LiteRT와 MTP
- 세션 복원과 메모리 최적화
- 에이전트까지 기기 안으로
- iOS와 웹으로 넓어지는 LiteRT-LM
- 실무자가 볼 핵심 포인트
- 원문 출처
핵심 요약
- LiteRT-LM은 Gemma 4를 Android, iOS, 웹에서 빠르게 실행하기 위한 Google AI Edge의 온디바이스 LLM 런타임이다.
- Android GPU 52 tokens/sec, iOS Metal 56 tokens/sec, WebGPU 최대 76 tokens/sec decode 성능을 제시했다.
- Multi-Token Prediction(MTP)을 통합해 최대 2.2배 디코딩 가속을 제공한다.
- 세션 저장·복원, 메모리 절감, Thinking Mode, constrained decoding, function calling까지 에이전트 실행에 필요한 기능을 런타임 레벨에서 다룬다.
온디바이스 LLM의 병목은 모델만이 아니다
온디바이스 AI의 어려움은 모델 크기 하나로 끝나지 않는다. 모바일 기기는 메모리가 제한적이고, CPU·GPU·NPU 조합이 기기마다 다르며, 긴 대화에서는 KV cache가 빠르게 커진다. 모델이 좋아도 런타임이 데이터를 자주 옮기고, prefill을 반복하고, 백엔드별 최적화를 못 하면 사용자는 느리다고 느낀다.
LiteRT-LM은 이 문제를 런타임 스택 전체로 푼다. 아래에는 LiteRT 기반 실행, XNNPACK과 MLDrift 커널, CPU·GPU·NPU 백엔드 최적화, 그 위에는 MTP와 세션 관리가 올라간다. Google은 이 조합이 Gemma 모델을 위한 고성능 실행 환경이라고 설명한다.
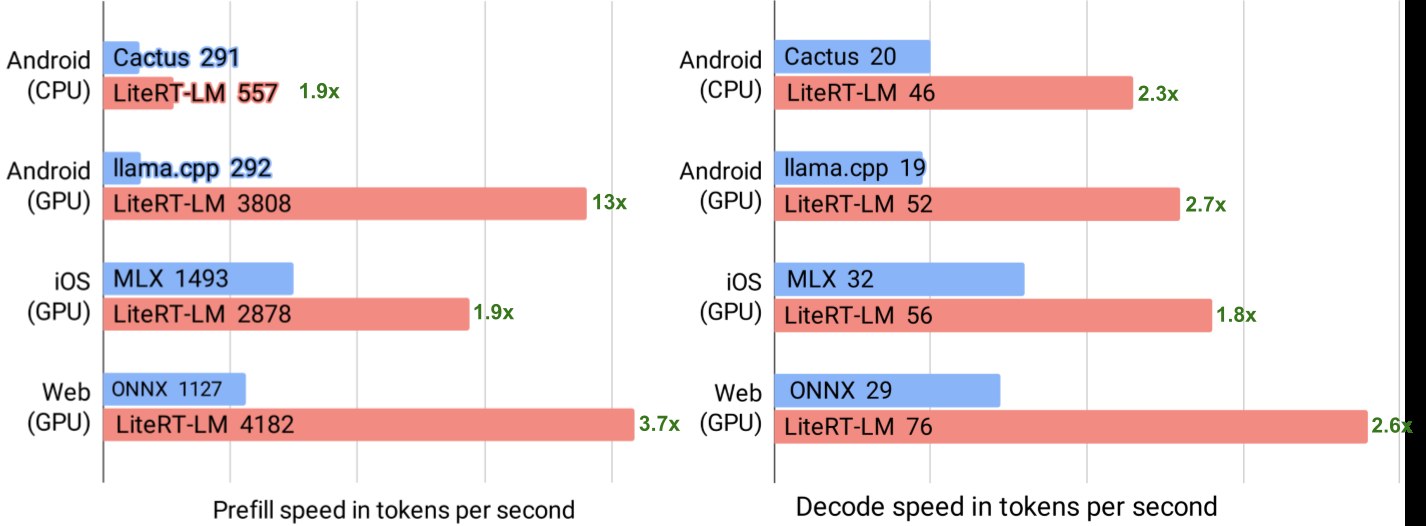
Gemma 4 E2B의 LiteRT-LM prefill/decode 성능. Source: Google Developers Blog
속도의 핵심: LiteRT와 MTP
원문에서 가장 눈에 띄는 숫자는 decode 속도다. Gemma 4 E2B를 MTP 없이 실행했을 때 Android GPU(OpenCL)에서 52 tokens/sec, iOS Metal에서 56 tokens/sec, MacBook Pro의 Chrome WebGPU에서 최대 76 tokens/sec를 제시했다. 서버가 아니라 사용자의 기기에서 이 정도 속도를 목표로 한다는 점이 중요하다.
MTP는 여기에 한 번 더 가속을 붙인다. 일반적인 LLM 추론은 한 토큰을 만들 때마다 큰 가중치를 메모리에서 계산 장치로 옮겨야 하므로 메모리 대역폭에 묶인다. LiteRT-LM은 가벼운 MTP drafter와 기본 Gemma 4 모델을 같은 하드웨어 IP, 예를 들면 GPU 위에서 실행해 메모리 지역성을 유지한다. 공유 KV cache와 activation을 로컬 메모리 안에서 관리해 불필요한 데이터 이동을 줄이는 방식이다.
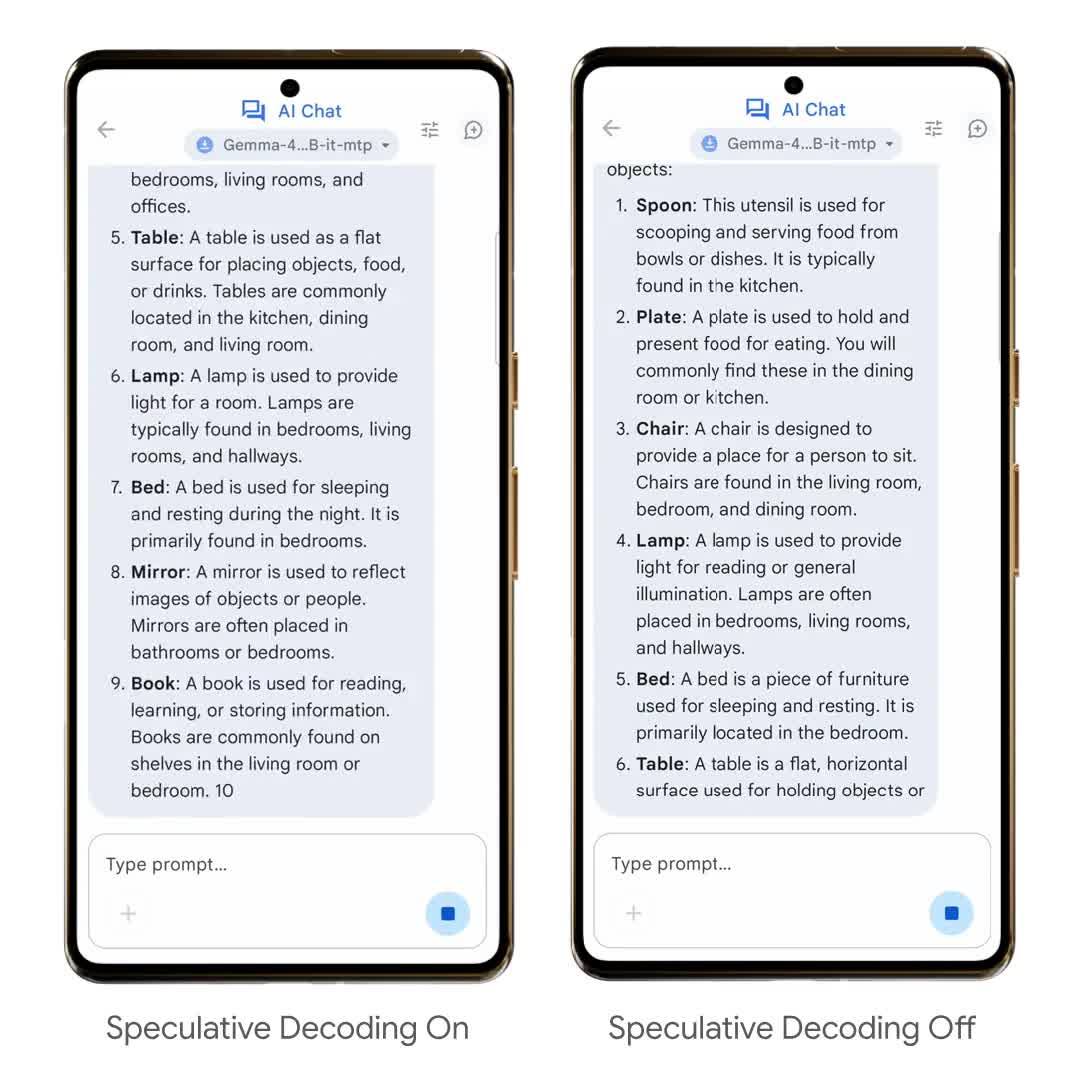
LiteRT-LM MTP 데모. Source: Google Developers Blog

MTP 활성화 시 최대 2.2배 decode speedup. Source: Google Developers Blog
세션 복원과 메모리 최적화
모바일 앱에서 긴 대화가 이어질수록 중요한 것은 세션 관리다. LiteRT-LM은 큰 KV cache 상태를 저장하고 복원할 수 있다. 사용자가 앱을 다시 열었을 때 이전 대화 맥락을 이어가면서도 무거운 prefill을 반복하지 않아도 된다. 사용자 경험뿐 아니라 계산량 절감에도 직접 연결된다.
메모리 최적화도 핵심이다. LiteRT-LM은 텍스트만 쓰는 작업에서는 이미지·오디오 인코더를 굳이 올리지 않고, 필요한 순간에만 동적으로 로드한다. per-layer embedding도 메모리 밖에 두는 방식으로 footprint를 줄인다. 원문은 약 2.58GB Gemma 4 E2B 모델을 Apple 모바일 CPU에서 607MB physical memory footprint로 실행한 사례도 제시했다.
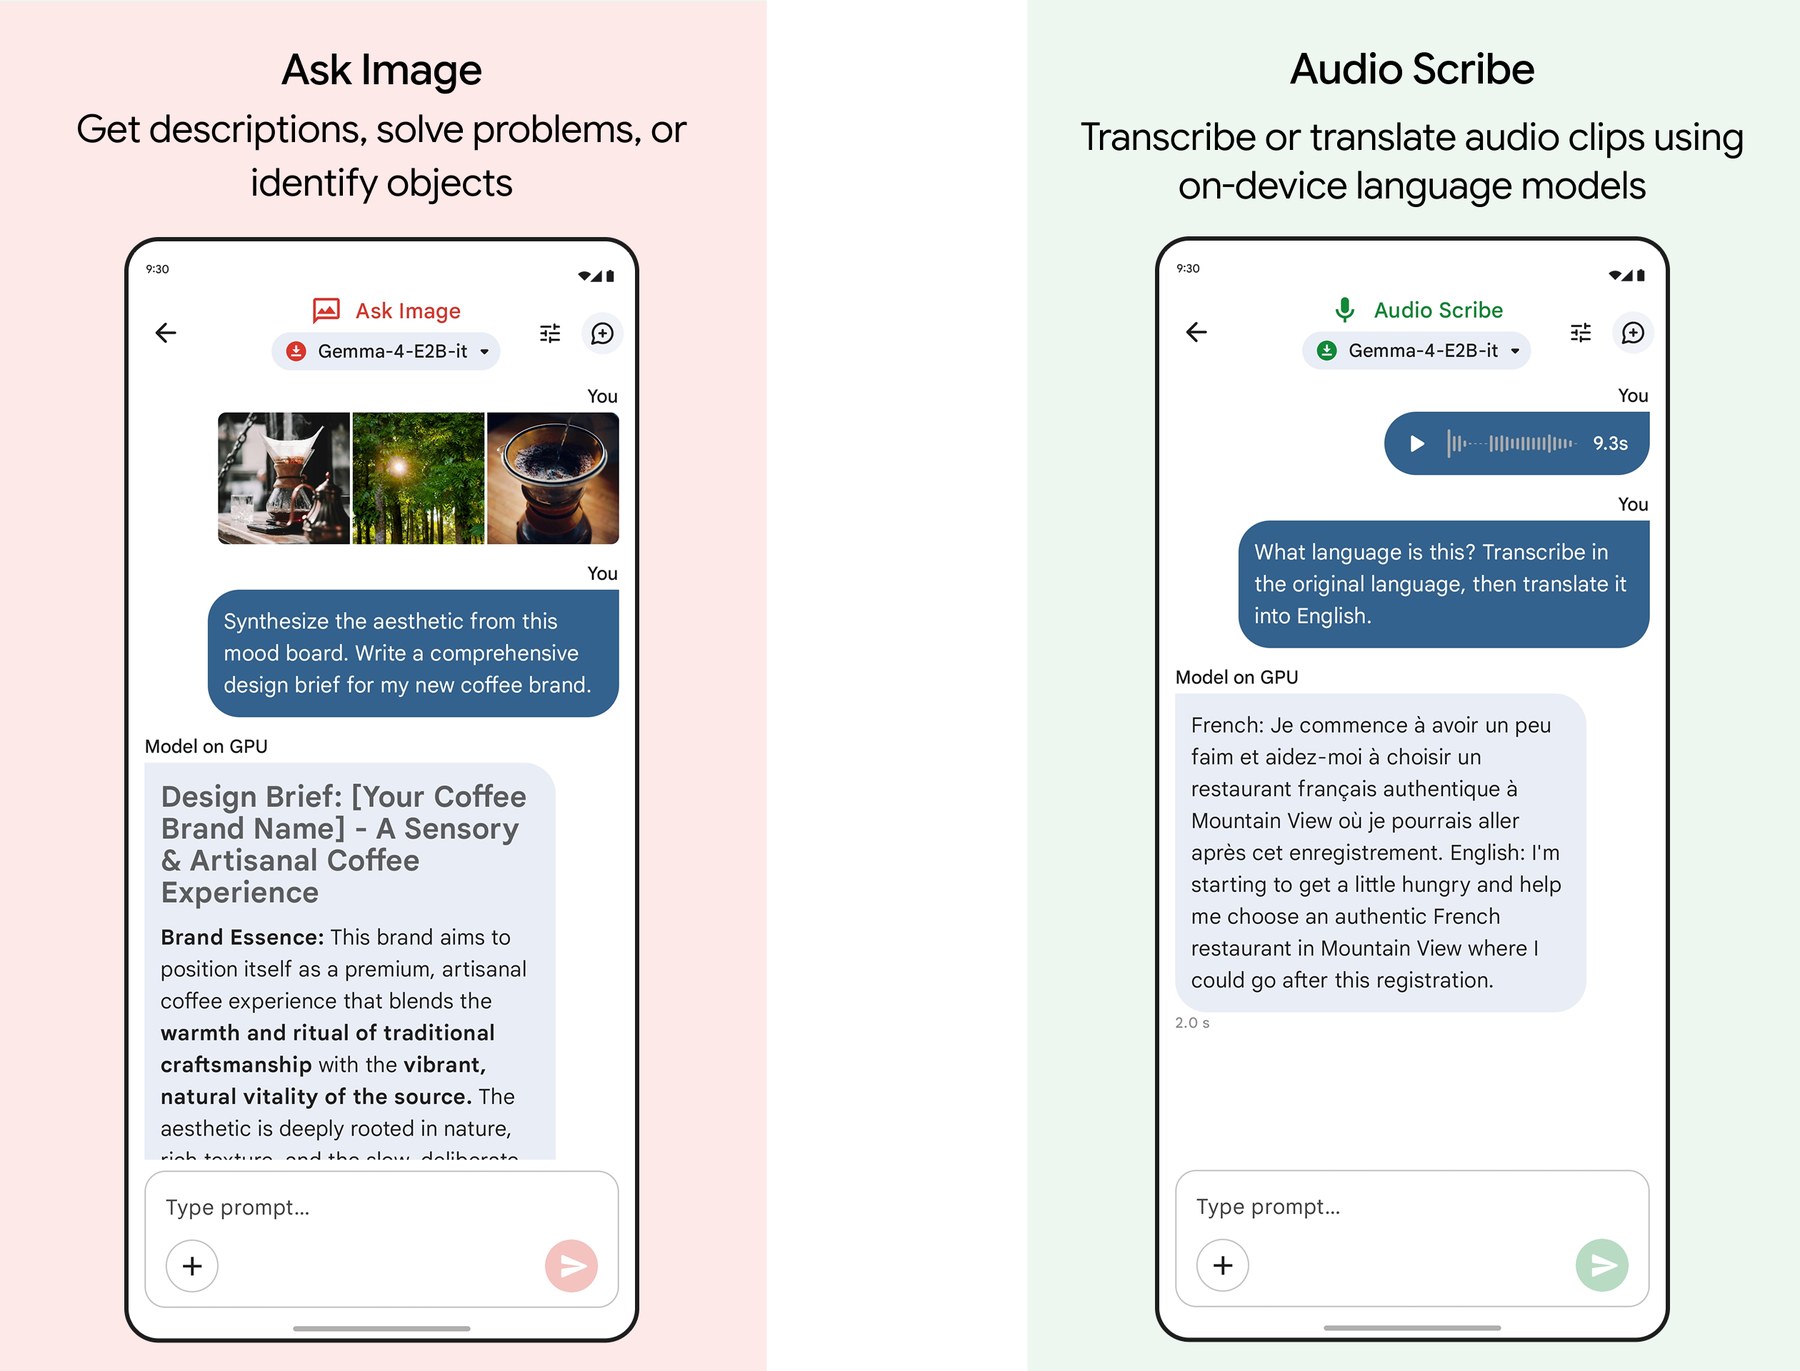
Google AI Edge Gallery 앱에서의 Gemma 4 멀티모달 지원. Source: Google Developers Blog
에이전트까지 기기 안으로
LiteRT-LM의 방향은 단순 채팅보다 넓다. Gemma 4의 Thinking Mode를 지원해 모델이 외부 행동을 실행하기 전에 단계별 reasoning을 수행할 수 있고, 개발자는 이 reasoning을 UI에 스트리밍하거나 KV cache 절약을 위해 제거할 수 있다.
구조화 출력도 중요하다. constrained decoding을 함께 쓰면 JSON schema나 특정 문법을 강제해 parser-breaking을 줄일 수 있다. 여기에 FunctionGemma와 Gemma 4에서 발전한 function calling이 붙으면, 모델이 도구 호출 요청을 앱으로 넘기고, 앱이 결과를 돌려주면 다시 이어서 실행하는 흐름을 만들 수 있다. 온디바이스에서도 에이전트형 앱을 만들 수 있는 기반이 되는 셈이다.

Thinking Mode 데모 영상 썸네일. Source: Google Developers Blog
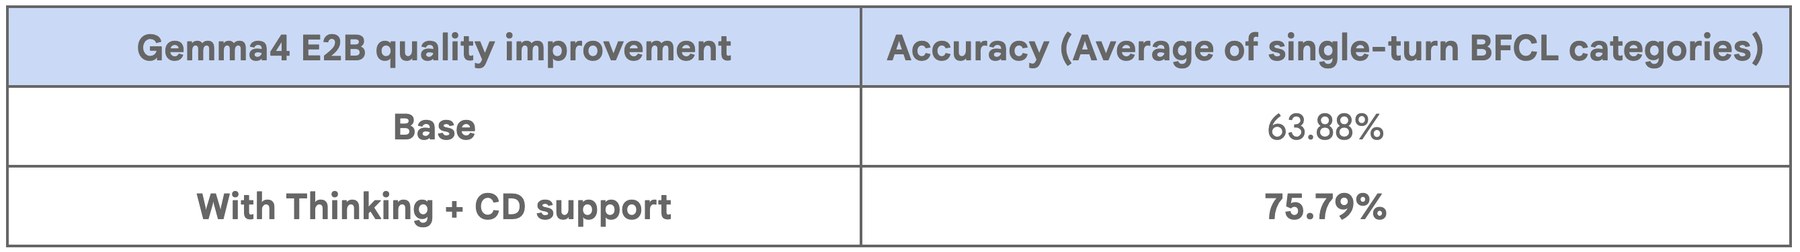
Thinking + constrained decoding 품질 개선. Source: Google Developers Blog
iOS와 웹으로 넓어지는 LiteRT-LM
LiteRT-LM은 Android Kotlin/C++을 넘어 iOS Swift API와 Web JavaScript API로 확장되고 있다. iOS에서는 Swift API로 Gemma 모델을 네이티브 앱에 넣을 수 있고, 웹에서는 WASM과 WebGPU를 통해 브라우저 안에서 LLM 실행을 목표로 한다.
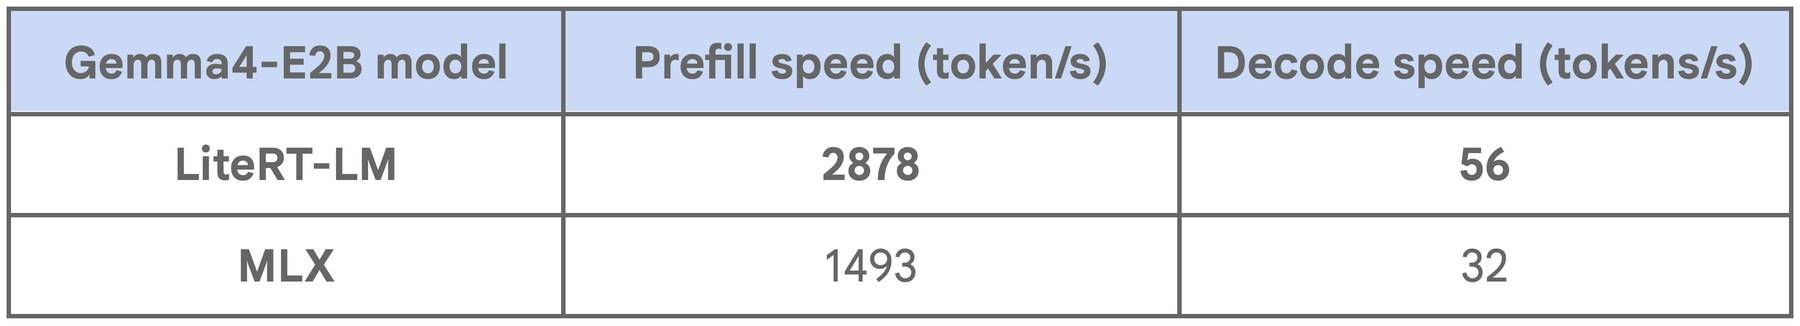
LiteRT-LM iOS Swift와 MLX 성능 비교. Source: Google Developers Blog

LiteRT-LM WebGPU 데모 영상 썸네일. Source: Google Developers Blog
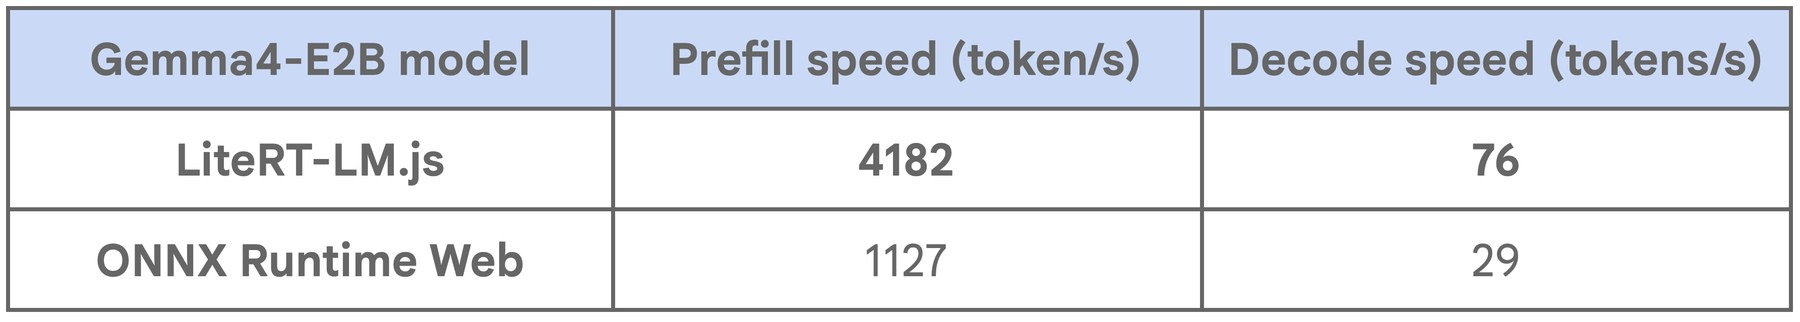
LiteRT-LM.js와 ONNX Runtime Web 성능 비교. Source: Google Developers Blog
웹에서의 의미는 특히 크다. 서버를 거치지 않는 비공개 처리, 빠른 반응성, 오프라인에 가까운 사용자 경험을 브라우저 앱에서도 설계할 수 있기 때문이다. 물론 모델 크기와 기기 성능의 제약은 남아 있지만, LLM 실행 위치가 클라우드에서 클라이언트로 내려오는 흐름은 점점 선명해지고 있다.
실무자가 볼 핵심 포인트
LiteRT-LM은 “작은 모델 하나를 빠르게 돌리는 라이브러리”라기보다, 온디바이스 GenAI 앱을 위한 실행 스택에 가깝다. 앱 개발자라면 세 가지를 봐야 한다. 첫째, 어떤 기기와 백엔드에서 목표 latency를 만족하는가. 둘째, MTP와 session restore가 실제 UX에서 얼마나 차이를 만드는가. 셋째, constrained decoding과 function calling으로 로컬 에이전트 기능을 얼마나 안정적으로 만들 수 있는가.
다만 원문 성능은 특정 기기와 조건에서 측정된 값이다. Samsung S26 Ultra, iPhone 17 Pro, MacBook Pro WebGPU 같은 환경이 기준이므로, 실제 제품에서는 타깃 기기군에서 별도 측정이 필요하다. 그래도 방향은 명확하다. 온디바이스 AI의 경쟁은 이제 모델 압축만이 아니라 런타임, 메모리, 세션, 도구 호출까지 포함한 전체 스택 싸움으로 가고 있다.