출처: Letta Blog
문서유형: 원문 해설
#AIAgent #AgentMemory #ContextEngineering #MemGPT #Letta
핵심 요약
Letta의 글 **“Agent Memory: How to Build Agents that Learn and Remember”**는 에이전트 메모리를 “대화를 저장하는 기능”보다 훨씬 넓게 설명합니다. 핵심은 이겁니다. 에이전트가 기억한다는 것은, 결국 지금 이 순간 컨텍스트 윈도우 안에 어떤 토큰을 넣을지 설계하는 일입니다.
전통적인 LLM은 stateless 방식으로 동작합니다. 매 대화가 독립적이고, 이전 경험은 다음 응답에 자연스럽게 이어지지 않습니다. 짧은 질의응답에는 충분하지만, 사용자를 오래 상대하거나 업무를 계속 이어가는 에이전트에는 한계가 있습니다. 그래서 Letta는 Agent Memory를 Context Engineering의 문제로 봅니다.
메모리는 저장소가 아니라 컨텍스트 관리다
글에서 가장 중요한 문장은 “에이전트가 기억하는 것은 결국 컨텍스트 윈도우에 들어 있는 것”이라는 관점입니다. 아무리 많은 데이터를 저장해도, 모델이 추론하는 순간 그 정보가 적절한 형태로 들어오지 않으면 기억으로 작동하지 않습니다.
그래서 메모리 설계는 다음 질문으로 바뀝니다.
- 최근 대화는 얼마나 유지할 것인가?
- 사용자 선호나 목표는 어떤 블록으로 고정할 것인가?
- 오래된 대화는 어떻게 요약하고 검색할 것인가?
- 외부 DB에서 가져온 정보는 언제 다시 컨텍스트에 넣을 것인가?
즉, 메모리는 “어딘가에 저장해두는 기능”이 아니라 필요한 정보를 적절한 시점에 다시 모델 앞으로 가져오는 구조입니다.
네 가지 메모리 구성 요소
Letta는 에이전트 메모리를 몇 가지 층으로 나눠 설명합니다.
첫째, Message Buffer는 최근 대화를 담습니다. 대화의 흐름을 유지하는 짧은 작업 기억입니다.
둘째, Core Memory는 컨텍스트 안에 고정되는 메모리 블록입니다. 사용자 선호, 조직 정보, 현재 목표, 에이전트 페르소나처럼 자주 필요한 정보를 구조화해 둡니다.
셋째, Recall Memory는 전체 대화 이력을 저장하고, 필요할 때 검색해서 가져오는 영역입니다. 지금 컨텍스트에 없더라도 과거 대화를 다시 불러올 수 있게 합니다.
넷째, Archival Memory는 명시적으로 정리된 지식 저장소입니다. 벡터 DB나 그래프 DB처럼 외부 저장소를 활용해 지식을 검색하고 다시 컨텍스트로 넣습니다.
이 구분이 중요한 이유는 각 메모리가 맡는 일이 다르기 때문입니다. 최근 대화, 고정된 사용자 정보, 전체 이력, 외부 지식을 같은 방식으로 다루면 컨텍스트가 금방 지저분해집니다.
MemGPT와 운영체제식 메모리
Letta의 뿌리인 MemGPT는 LLM의 제한된 컨텍스트 윈도우를 운영체제의 메모리 계층처럼 다룹니다. RAM에 해당하는 in-context memory와 디스크에 해당하는 archival/recall memory 사이에서 정보를 옮기며, 제한된 창 안에서 더 긴 기억을 다루게 만드는 방식입니다.
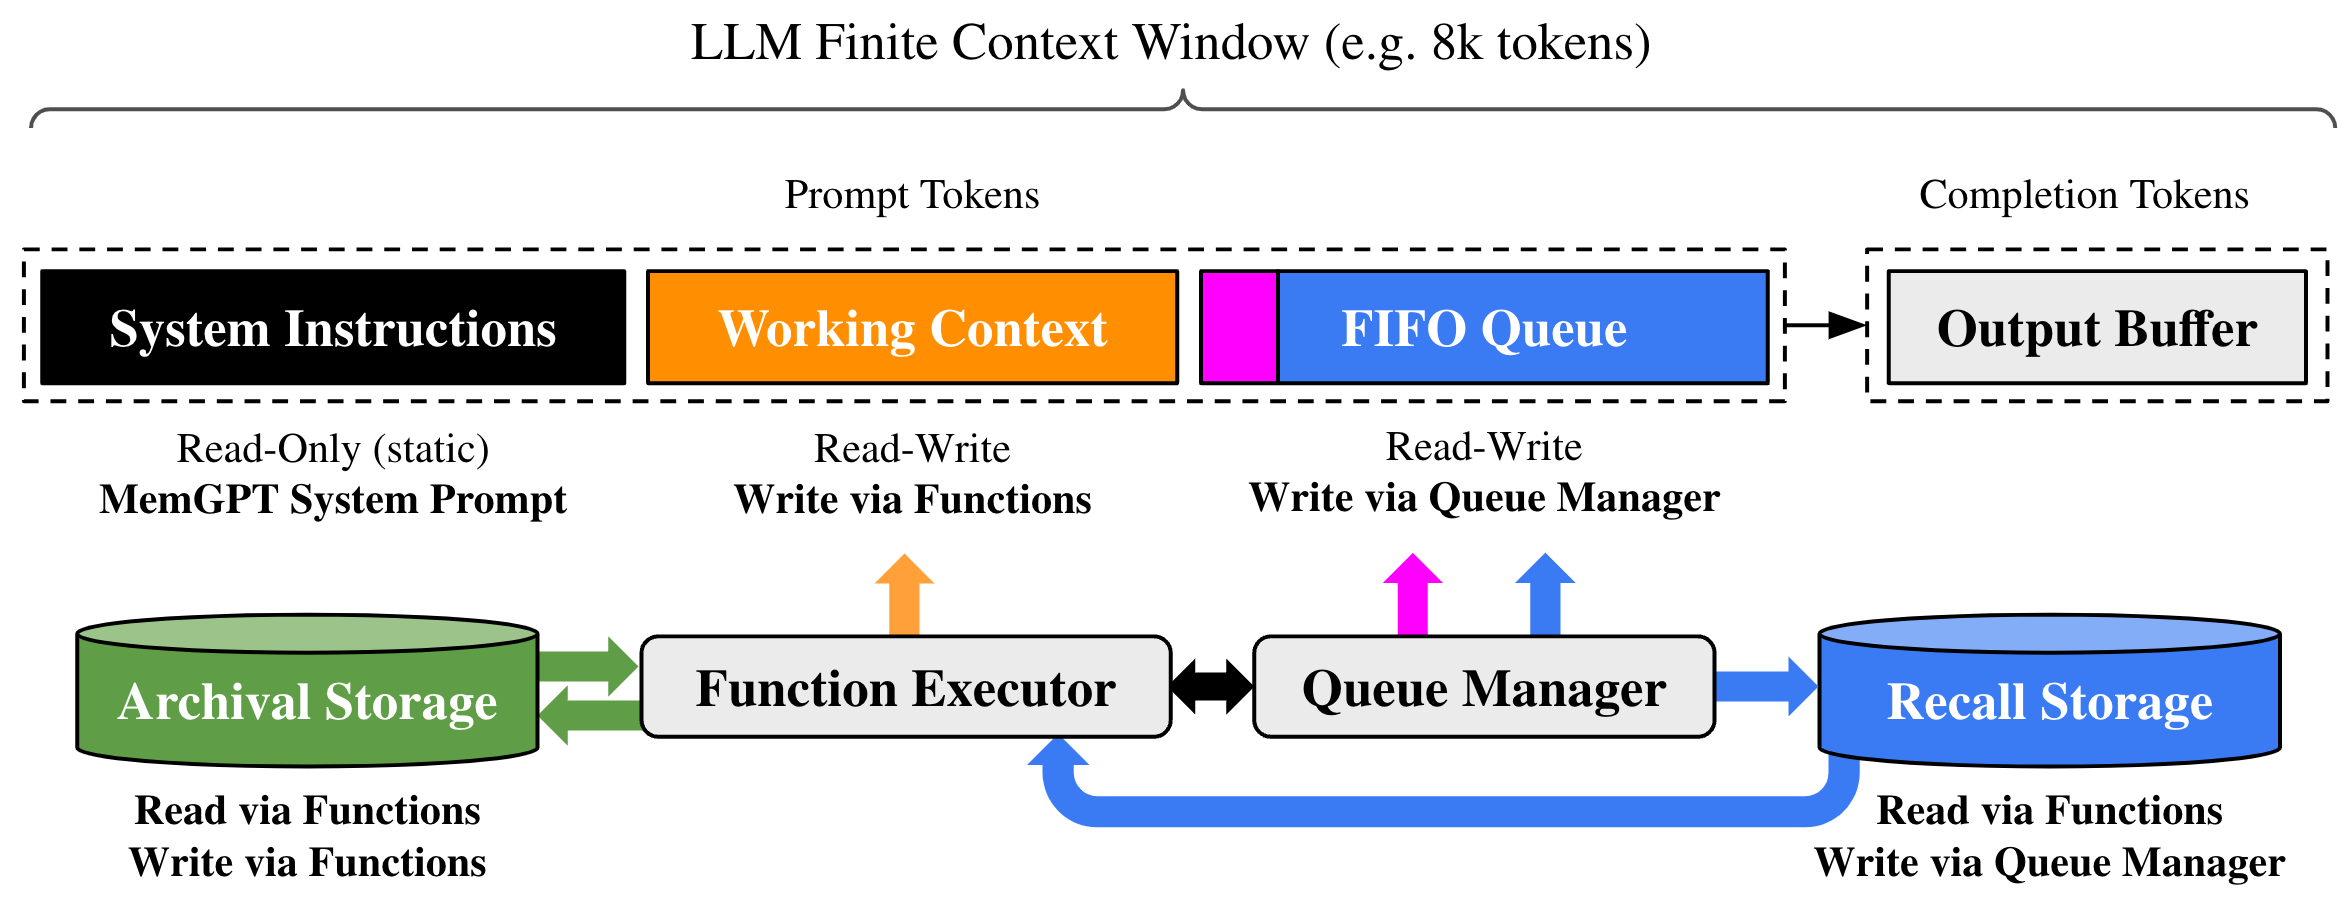
이 비유는 꽤 실용적입니다. 모델의 컨텍스트는 무한하지 않습니다. 그래서 좋은 에이전트는 모든 것을 한 번에 넣으려 하지 않고, 지금 필요한 것만 올리고, 오래된 것은 요약하거나 외부 저장소로 내보냅니다.
RAG는 메모리의 일부일 뿐이다
글에서 짚는 중요한 포인트는 RAG가 곧 메모리는 아니라는 점입니다. RAG는 외부 정보를 검색해 컨텍스트로 가져오는 기술입니다. 하지만 에이전트 메모리는 그것보다 넓습니다.
메모리에는 최근 대화 유지, 메모리 블록 관리, 요약, 삭제, 검색, 외부 저장소 호출, 컨텍스트 재작성까지 포함됩니다. RAG는 이 중 “외부 저장소에서 다시 가져오기”에 해당하는 한 조각입니다.
Sleep-time Compute의 의미
Letta는 memory block을 대화 중에만 수정하는 방식보다, 유휴 시간에 별도 에이전트가 메모리를 정리하는 방식을 제안합니다. 이를 sleep-time compute라고 부릅니다.
대화 응답과 메모리 정리를 한 에이전트가 동시에 처리하면 응답이 느려지고 품질도 흔들릴 수 있습니다. 반대로 대화가 없는 시간에 메모리를 정리하면, 다음 대화에서는 더 정제된 맥락을 사용할 수 있습니다.
이 관점은 장기 에이전트 설계에서 중요합니다. 좋은 에이전트는 대화 중에만 똑똑한 것이 아니라, 대화가 끝난 뒤에도 자신의 맥락을 정리하고 다음 작업을 준비해야 합니다.
개발자가 가져갈 점
에이전트 메모리를 설계할 때 “어디에 저장할까?”보다 먼저 물어야 할 것은 “언제, 어떤 형태로, 왜 다시 컨텍스트에 넣을까?”입니다.
실무적으로는 다음 원칙이 유용합니다.
- 최근 대화와 장기 지식을 분리한다.
- 사용자 선호와 현재 목표는 memory block으로 구조화한다.
- 오래된 대화는 전부 보존하기보다 요약과 검색을 병행한다.
- RAG를 메모리 전체로 착각하지 않는다.
- 메모리 정리는 응답 경로와 분리해 비동기로 처리한다.
- 최종 목표는 인간 기억 흉내가 아니라, 모델 추론 시점에 좋은 컨텍스트를 제공하는 것이다.
정리
Agent Memory의 본질은 “에이전트가 무엇을 저장했는가”가 아닙니다. 모델이 판단하는 순간 어떤 정보가 컨텍스트에 들어와 있는가입니다.
따라서 오래 기억하는 에이전트를 만들려면 벡터 DB 하나를 붙이는 것으로는 부족합니다. 메시지 버퍼, 코어 메모리, 리콜 메모리, 아카이벌 메모리, 요약, 검색, 컨텍스트 재작성, 비동기 메모리 정리를 함께 설계해야 합니다.
Letta의 글은 Agent Memory를 기능이 아니라 시스템 설계 문제로 보게 만듭니다. 에이전트가 진짜로 배워가며 일하려면, 기억은 저장이 아니라 컨텍스트를 운영하는 기술이어야 합니다.
원문 : Agent Memory: How to Build Agents that Learn and Remember