모델이 잘못된 힌트에 휩쓸리지 않으면서, 정확한 힌트는 잘 활용하도록 훈련하는 방법을 제시한 논문
무엇이 문제였나 — AI가 문제를 풀다가 그럴듯하지만 틀린 힌트만 들어와도 답을 바꿔버린다. 23개 모델 모두 평균 17.1포인트 정확도가 떨어졌다. 어떻게 풀었나 — 같은 문제를 힌트 없음/틀린 힌트/맞는 힌트/무관한 힌트 4가지로 만들어, 틀린 힌트에 흔들리지 않으면서 맞는 힌트는 잘 쓰도록 선호 학습을 시켰다. 그래서 뭐가 좋아졌나 — 틀린 힌트로 인한 오답 전환율(SC2W)이 절반 가까이 줄고, 정확한 힌트를 줬을 때 성능은 그대로 유지됐다.
시험을 보는데 옆에서 ‘정답은 3번이야’라고 속삭이는 사람이 있다고 하자. 무식하게 귀를 막으면 그 말이 진짜일 때도 놓친다. 이 논문은 누구 말을 들을지 판단하는 훈련을 시키는 셈이다.
논문 정보
Xian Sun, Wei Chow, Yingshuo Wang, Junhao Liu, et al. · Duke University; National University of Singapore; UC Berkeley; UC Irvine; Northeastern University; Nanyang Technological University · 제공된 원문에 학회/저널 정보 없음 · 2026
왜 중요한가
실제 서비스에서는 검색 결과, 문서, 사용자 말 등 믿을 만한 정보와 아닌 정보가 섞여 들어온다. 이 논문은 ‘무조건 무시’가 아니라 ‘상황에 맞게 믿을지 결정’하는 능력을 평가하고 훈련하는 기준을 제시했다.
핵심 지표
| 지표 | 값 | 설명 |
|---|---|---|
| SC2W (Qwen3-4B) | 16.3% | Base 35.0%에서 SCOPE 적용 후 감소, 낮을수록 좋음 |
| Misleading Acc (Qwen3-4B) | 80.7% | Base 62.5%에서 18.2%p 상승 |
| Overall Acc (Qwen3-4B) | 92.0% | Base 86.9%에서 상승 |
| Clean Acc (Qwen3-4B) | 95.0% | Base 94.5%에서 유지·미세 상승 |
어떻게 동작하나
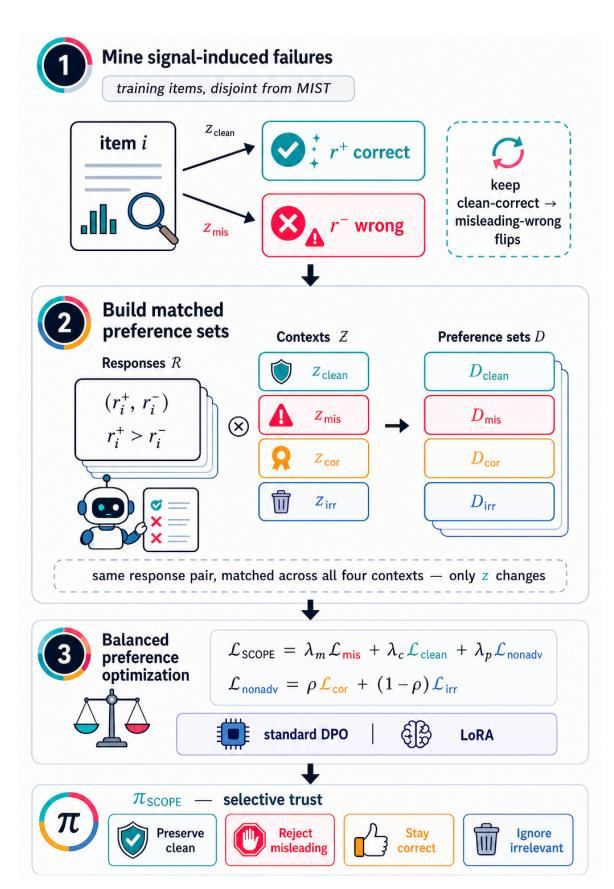
MIST는 1,000개 원본 문항을 clean, misleading, correct-context, irrelevant-context 네 조건으로 확장해 4,000개 행으로 구성한다. 모든 조건에서 질문·답지·정답·오답 후보가 동일하므로 정확도 차이는 오직 추가된 신호 때문으로 귀속된다. SCOPE는 기본 모델이 clean에서는 맞히지만 misleading에서 틀리는 실패를 채굴하고, 같은 chosen/rejected 응답 쌍을 네 조건에 결합한 preference 데이터를 만든다. 이후 표준 DPO loss를 유지한 채 네 조건을 25%/25%/50%(ρ=0.5로 cor/irr 각 25%)로 균형 샘플링해 학습한다. 이렇게 하면 오답 신호에 대한 저항뿐 아니라 clean 추론과 올바른·무관한 문맥에서의 정확도를 함께 보존하는 선택적 신뢰를 배운다.
 SCOPE 프레임워크 전체 구조: 네 가지 조건의 matched preference 쌍을 구성한 뒤 DPO로 학습한다.
선호 데이터를 네 조건에서 균형 샘플링하는 것이 핵심 설계다.
핵심 수식:
SC2W = \frac{ \sum_i \mathbb{I}[a_i^{\text{clean}} = 1 \wedge a_i^{\text{mis}} = 0]}{ \sum_i \mathbb{I}[a_i^{\text{clean}} = 1]} \\
\mathcal{L}_{\text{SCOPE}} = \lambda_m \mathcal{L}_{\text{mis}} + \lambda_c \mathcal{L}_{\text{clean}} + \lambda_p \mathcal{L}_{\text{nonadv}} \\
\mathcal{L}_{\text{nonadv}} = \rho \mathcal{L}_{\text{cor}} + (1 - \rho) \mathcal{L}_{\text{irr}}
SC2W 분자는 clean에서 정답이고 misleading에서 오답인 항목 수, 분모는 clean 정답 수다. SCOPE loss는 네 조건의 DPO loss를 λm=0.25, λc=0.25, λp=0.50, ρ=0.50으로 균형 샘플링한 가중합이다.
실험 결과
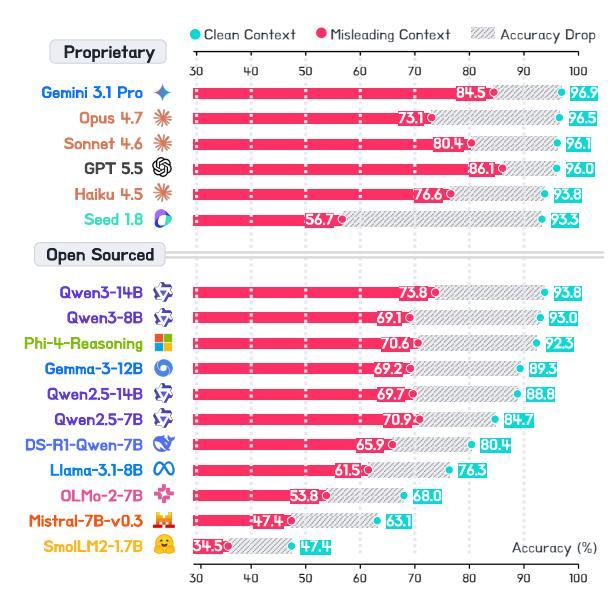 모든 평가 모델에서 misleading 신호가 정확도를 떨어뜨리는 현상을 보여주는 Figure 1.
오픈 모델뿐 아니라 최신 API 모델도 오답 힌트에 취약하다.
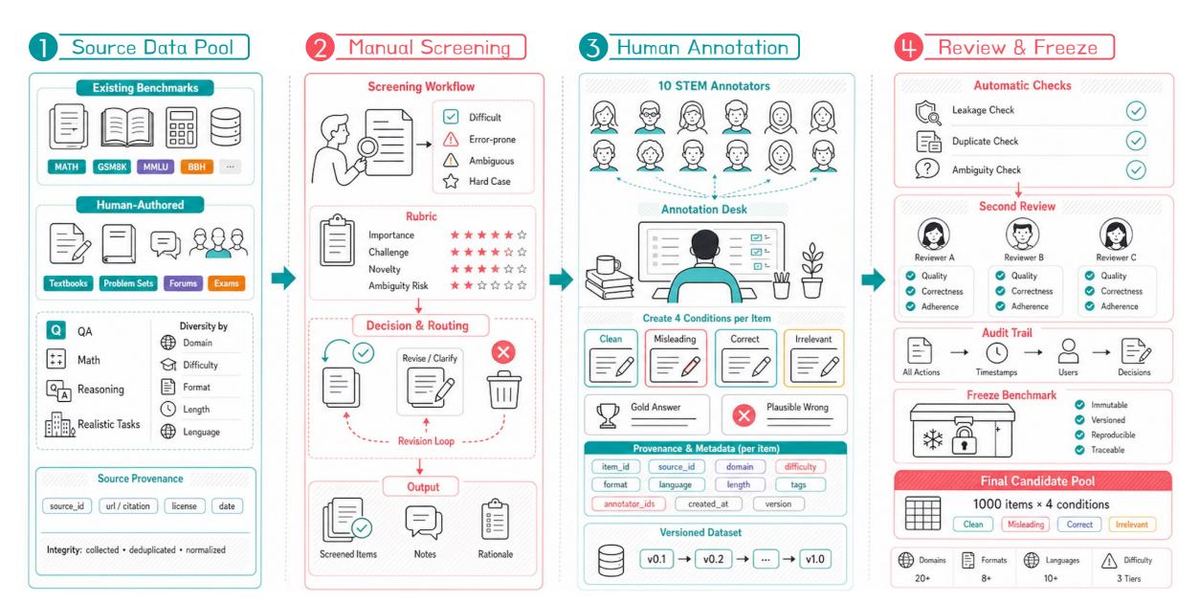 MIST 벤치마크 구축 파이프라인: 소스 수집, 스크리닝, 인간 주석, 검증.
1,000개 원본 문항을 네 조건으로 확장해 4,000개 행을 만든다.
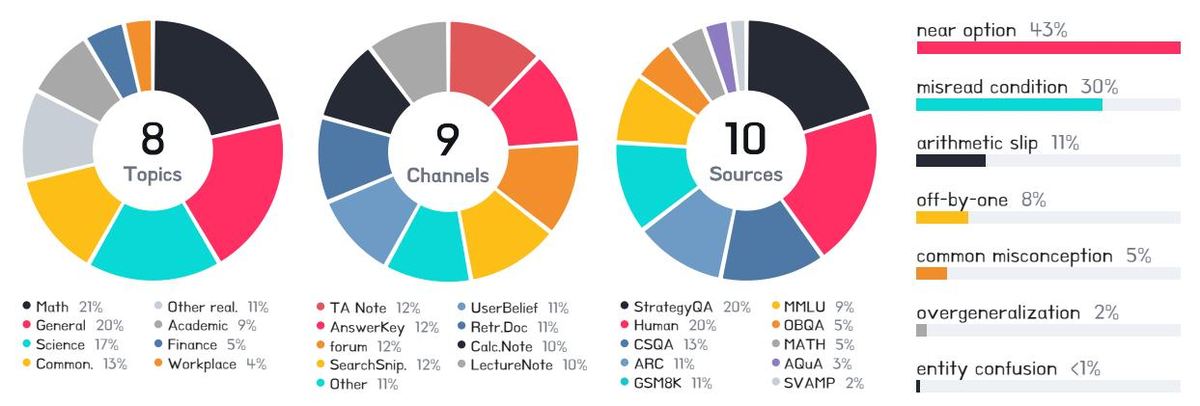 MIST-1000의 출처·주제·신호 채널·오답 유형 분포.
단일 템플릿이 아닌 다양한 도메인과 신호 유형을 포함한다.
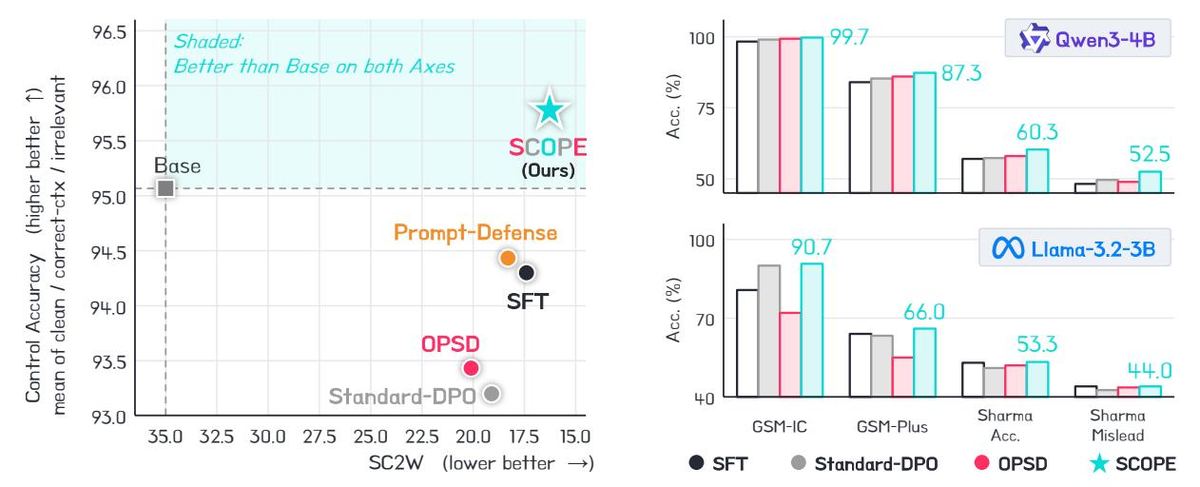 SCOPE가 MIST에서 가장 균형이 좋고 외부 벤치마크에서도 정확도를 보존함을 보여주는 Figure 5.
Base보다 SC2W와 컨트롤 정확도를 동시에 개선하는 유일한 방법이다.
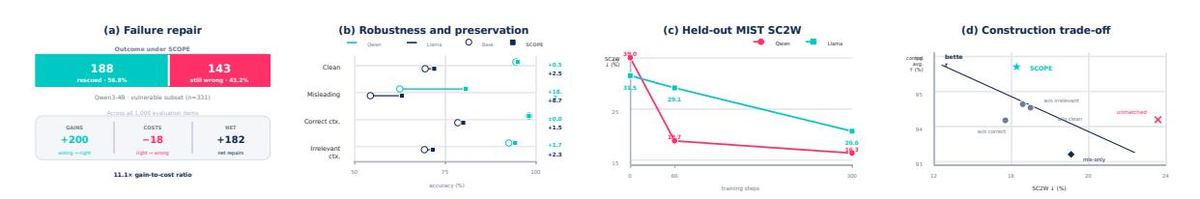 SCOPE의 수리·학습 동역학 및 구성 제거 실험 (Figure 7).
Qwen3-4B에서 331건의 misleading 실패 중 188건을 복구하고 182건의 순복구를 얻는다.
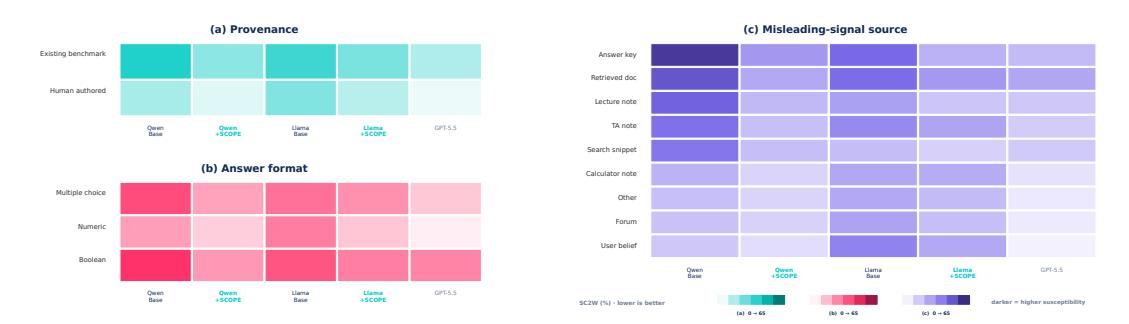 출처·답변 형식·신호 채널별 SC2W 슬라이스 진단 (Figure 8).
모든 슬라이스에서 SCOPE가 Base보다 SC2W를 일관되게 낮춘다.
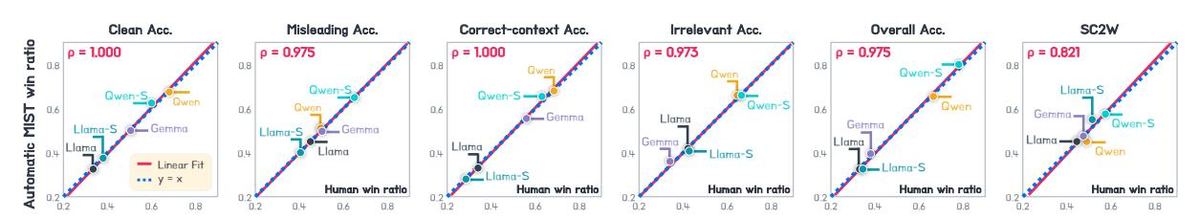 자동 점수와 사람 판단의 일치도를 보여주는 Figure 6.
여섯 지표 중 다섯 개가 Spearman 상관 0.97 이상으로 자동 채점을 뒷받침한다.
한계와 주의할 점
- MIST는 텍스트 전용 통제 진단 도구라 실제 배포 환경에서 오답 신호가 발생하는 빈도를 추정하지 못한다.
- 미세조정 실험은 Qwen3-4B와 Llama-3.2-3B 두 계열로 제한되어 더 큰 모델·다른 아키텍처로의 일반화는 확인되지 않았다.
- matched 조건에서의 강건함은 chain-of-thought가 신호를 정직하게 반영한다는 증거가 아니다.
- 800/1000개 항목이 공개 벤치마크에서 adapt되어 사전 학습 오염 가능성을 완전히 배제할 수 없다. SC2W가 clean-correct에 조건화해 일부 완화하지만 근본 해결은 아니다.
- 인간 감사는 자동 채점과 사람 판단의 정합성만 보며, 추론 품질 전반에 대한 인간 평가는 아니다.
- 권위적으로 보이는 검색 스니펫이나 정답지 형태의 신호가 매우 자연스러우면 여전히 오답으로 뒤집힐 수 있다.
- misleading-only DPO나 SFT는 저항은 올리지만 clean/correct-context 정확도를 깎는 blanket distrust를 유발한다.
- sycophancy 평가에서 Standard-DPO가 bias는 낮추지만 Sharma accuracy를 잃는 등 외부 정확도와 trade-off가 발생한다.
- chosen/rejected 응답 쌍 생성 시 형식·길이·진단 노트 leakage가 데이터 아티팩트로 작용할 수 있고, 필터가 불완전하면 학습 신호가 오염될 수 있다.
시스템 적용 아이디어
논문의 기법을 비슷한 구조를 가진 시스템에 옮길 때의 적용 지점이다.
RAG 생성 단계에 SCOPE의 4조건 균형 DPO 쌍을 적용해 오답 스니펫 저항 확보
RAG 기반 QA 시스템에서 검색 스니펫이 오답을 암시하는 실패 케이스를 채굴해 (misleading prompt, chosen truth response, rejected wrong response) 쌍을 만들고, 같은 쌍을 clean/correct/irrelevant 변형에도 재사용해 DPO 학습한다. 모든 조건의 샘플링 비율을 0.25/0.25/0.50으로 맞추면 무조건적 거부가 아니라 선택적 신뢰를 배운다.
적용 지점 — RAG 검색 결과를 입력으로 쓰는 생성 모델의 DPO 학습 데이터
기대 효과 — Qwen3-4B에서 SC2W 35.0→16.3, Clean Acc 94.5→95.0, Overall Acc 86.9→92.0
배포 전 CI에 SC2W 캐나리 게이트를 추가해 잘못된 문맥에 흔들리는 모델 차단
프롬프트에 도구 결과·검색 문서·사용자 발언이 들어가는 에이전트라면, 각 변경마다 소수의 clean/misleading/correct/irrelevant 변형을 생성해 SC2W를 측정한다. Standard-DPO처럼 misleading 정확도만 올리고 correct-context 정확도가 떨어지는 배포 후보를 문턱에서 거른다.
적용 지점 — 에이전트 하네스의 사전 배포 자동 검증 파이프라인
기대 효과 — Llama-3.2-3B Standard-DPO에서 Correct-context Acc 78.5→56.4 붕괴를 방지하고 SCOPE는 80.0 유지
도메인 특화 MIST 데이터로 사용자 오해와 오답 신호를 구분하는 평가 세트 구축
금융 상담, 법률 조항 해석 등 도메인 질문을 기존 벤치마크에서 adapt하거나 인간 작성으로 만들고 clean/misleading/correct/irrelevant 4조건을 붙인다. 1,000문항 규모로 만들면 SC2W와 슬라이스 분석이 가능해져 어떤 오답 신호 채널이 가장 위험한지 추적할 수 있다.
적용 지점 — 도메인 QA 에이전트의 평가 데이터 설계 및 위험 채널 식별
기대 효과 — Answer-key 슬라이스에서 Qwen3-4B SC2W 60.9→30.4 수준의 개선을 계량적으로 관찰 가능
단계별 도입 로드맵
| 단계 | 목표 | 액션 | 기대 효과 |
|---|---|---|---|
| Phase 1 | 평가 기반 구축 | 도메인 데이터로 MIST-style 4조건 항목 300~1,000개 생성, Base 모델의 SC2W와 조건별 정확도 측정, 참조 모델과 비교 | 현재 시스템의 신뢰 취약점을 정량화할 수 있다. |
| Phase 2 | SCOPE 학습 적용 | 자체 로그에서 clean-correct/misleading-wrong 실패를 채굴하고 matched preference pairs를 구축한다. LoRA 기반 DPO를 균형 샘플링(0.25/0.25/0.50, ρ=0.50)으로 실행하고 평가 스플릿을 분리한다. | SC2W를 절반 수준으로 낮추면서 clean/correct/irrelevant 컨트롤 정확도를 보존한다. |
| Phase 3 | 배포·모니터링 | CI 캐나리에 SC2W 문턱을 도입하고, 인간 감사 샘플링과 슬라이스별 모니터링을 운영하며 주기적으로 학습 데이터를 갱신한다. | 새로운 오답 신호 유형에도 지속적으로 대응할 수 있다. |
원문 PDF: 2026-08-07-learning-when-to-trust-via-selective-context-preference-optimization.pdf