강의 개요
| 항목 | 내용 |
|---|---|
| 채널 | Bloom AI |
| 강의자 | J |
| 영상 길이 | 약 9시간 |
| 업로드 | 2026년 2월 |
| 목표 | LangGraph V1 완벽 분석 + GPT-5·Gemini 연동 고급 AI Agent 실무 개발 |
| 소스코드 | Google Drive (Colab 노트북) |
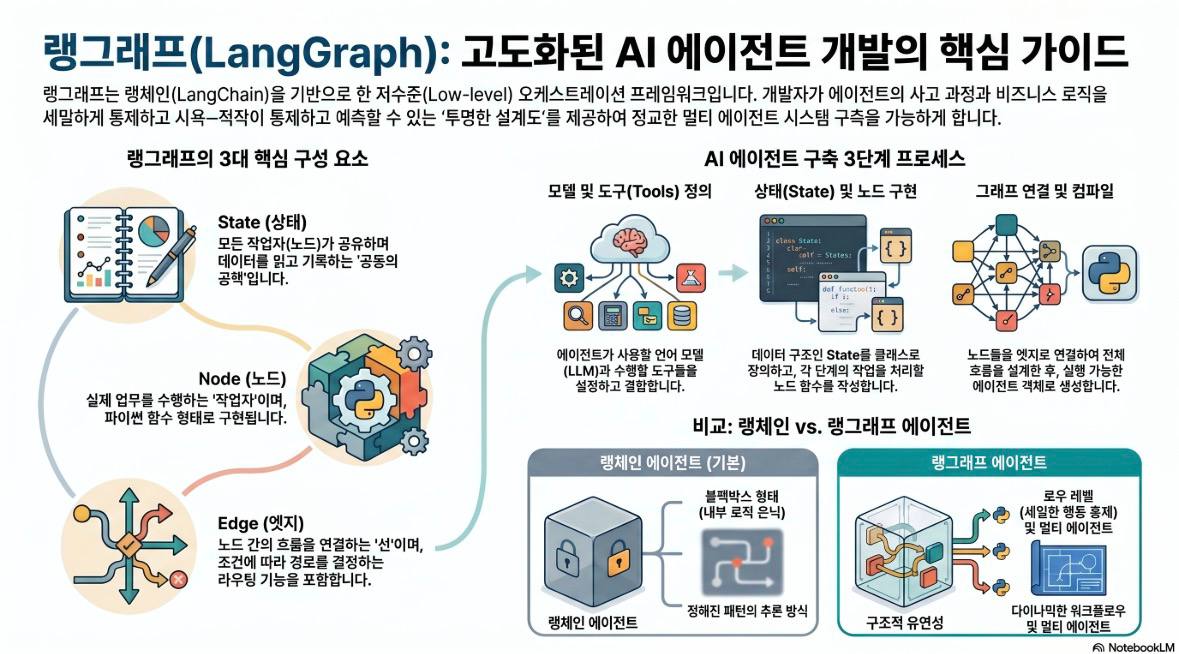
이 강의는 LangChain 풀강의의 후속편이다. LangChain이 “무엇을 할 수 있는가"를 가르쳐줬다면, LangGraph는 “어떻게 정밀하게 제어하는가"를 다룬다. 9시간이라는 분량이 부담스러울 수 있지만, 섹션 구조가 명확하고 각 파트가 독립적으로 실습 가능하게 설계되어 있어 단계별 학습이 가능하다.
전체 목차
| 섹션 | 시간대 | 주제 |
|---|---|---|
| 1 | 0:00 ~ 11:30 | Intro — LangGraph 개요 및 환경 세팅 |
| 2 | 11:30 ~ 2:47:32 | LangGraph 기초 — Node, Edge, State |
| 3 | 2:47:32 ~ 5:00:00 | LangGraph 응용 — 아키텍처 패턴 |
| 4 | 5:00:00 ~ 6:23:08 | Memory — 장기 기억과 Human-in-the-Loop |
| 5 | 6:23:08 ~ 끝 | Multi-Agent — 협업 시스템 구축 |
1. Intro (0:00 ~ 11:30)
LangChain vs LangGraph — 왜 LangGraph인가
LangChain은 LLM 애플리케이션을 빠르게 만들 수 있는 고수준 추상화 레이어다. Chain, Retriever, Agent 같은 개념이 내부 동작을 블랙박스로 감싸고 있어 빠른 프로토타이핑에는 강하지만, 복잡한 흐름 제어가 필요한 실무 Agent에서는 한계가 명확하다.
LangGraph는 이 문제를 그래프 기반 상태 관리로 해결한다. 강의에서는 “지휘자가 오케스트라를 지휘하듯 AI Agent의 흐름을 완벽 제어한다"는 비유를 쓰는데, 핵심은 다음 두 가지다:
- 투명성: 각 단계의 상태(State)가 명시적으로 정의되어 있어 디버깅이 쉽다
- 제어성: 조건부 분기, 루프, 인터럽트를 세밀하게 설계할 수 있다
실무에서는 단순한 챗봇을 넘어 “이메일 수신 → 의도 분류 → 매뉴얼 검색 → 사람 에스컬레이션 판단 → 답변 생성"처럼 여러 단계를 거치는 워크플로우가 필요하다. LangGraph는 이 흐름을 코드로 명확하게 표현할 수 있는 도구다.
개발 환경 세팅
강의에서 사용하는 환경:
pip install langgraph langchain google-generativeai langchain-google-genai
- 플랫폼: Google Colab (로컬 설치 없이 시작 가능)
- LLM: Google Gemini API (무료 티어로 실습 가능) + GPT-5 (선택)
- 소스코드: 전 섹션 Colab 노트북 제공 → 복붙 후 바로 실행 가능
2. LangGraph 기초 (11:30 ~ 2:47:32)
이 섹션은 강의에서 가장 중요한 부분이다. LangGraph의 세 가지 핵심 개념인 State, Node, Edge를 제대로 이해하면 나머지는 이 위에 쌓이는 패턴이다.
State — 그래프의 공유 메모리
State는 그래프 전체에서 공유되는 딕셔너리다. 모든 노드는 State를 읽고 쓰면서 작업을 이어간다.
from typing import TypedDict, Annotated
from langgraph.graph import StateGraph
import operator

class AgentState(TypedDict):
    messages: Annotated[list, operator.add]  # 메시지 누적
    intent: str                               # 분류된 의도
    manual_result: str                        # 매뉴얼 검색 결과
    need_escalation: bool                     # 에스컬레이션 필요 여부
State 설계 원칙 (강의에서 가장 강조하는 부분):
- 다음 노드에서 꼭 필요한 필드만 저장한다
- 사람이 읽기 좋은 텍스트가 아닌, 컴퓨터가 처리하기 좋은 형태로 저장한다 (예:
"긍정적인 답변을 원함"대신intent: "positive_request") - 불필요한 데이터는 절대 State에 넣지 않는다 → State가 커질수록 디버깅이 어렵고 LLM 토큰 낭비가 생긴다
실무 팁: State 설계가 전체 Agent 품질의 80%를 결정한다. 개발 초기에 State 스키마를 팀과 합의한 뒤 코딩을 시작하는 것이 좋다.
Node — 작업 단위 함수
Node는 State를 입력으로 받아 변경된 State를 반환하는 함수다. 각 Node는 단 하나의 책임만 가져야 한다.
from langchain_google_genai import ChatGoogleGenerativeAI

llm = ChatGoogleGenerativeAI(model="gemini-2.0-flash")

def classify_intent(state: AgentState) -> AgentState:
    """이메일 의도를 분류하는 노드"""
    email = state["messages"][-1].content
    response = llm.invoke(f"다음 이메일의 의도를 분류해: {email}\n반환형식: refund/technical/shipping/general")
    return {"intent": response.content.strip()}

def search_manual(state: AgentState) -> AgentState:
    """매뉴얼에서 관련 내용을 검색하는 노드"""
    # 실제로는 벡터 DB나 키워드 검색 연동
    intent = state["intent"]
    manual = MANUALS.get(intent, "해당 내용 없음")
    return {"manual_result": manual}

def generate_response(state: AgentState) -> AgentState:
    """최종 답변을 생성하는 노드"""
    prompt = f"""
    이메일 의도: {state['intent']}
    매뉴얼 내용: {state['manual_result']}
    고객 이메일을 바탕으로 친절하고 정확한 답변을 작성해주세요.
    """
    response = llm.invoke(prompt)
    return {"messages": [response]}
Edge — 노드 연결과 조건부 분기
Edge는 노드 간 실행 순서를 정의한다. 두 종류가 있다:
일반 Edge: 항상 같은 다음 노드로 이동
graph.add_edge("classify_intent", "search_manual")
graph.add_edge("search_manual", "generate_response")
Conditional Edge: 조건에 따라 다른 노드로 분기
def should_escalate(state: AgentState) -> str:
    """에스컬레이션 필요 여부 판단"""
    if state["need_escalation"]:
        return "human_escalation"
    return "generate_response"

graph.add_conditional_edges(
    "check_complexity",
    should_escalate,
    {
        "human_escalation": "human_escalation",
        "generate_response": "generate_response"
    }
)
그래프 구축 전체 순서
from langgraph.graph import StateGraph, END

# 1. StateGraph 생성
graph = StateGraph(AgentState)

# 2. Node 추가
graph.add_node("classify_intent", classify_intent)
graph.add_node("search_manual", search_manual)
graph.add_node("check_complexity", check_complexity)
graph.add_node("generate_response", generate_response)
graph.add_node("human_escalation", human_escalation)

# 3. 시작점 설정
graph.set_entry_point("classify_intent")

# 4. Edge 연결
graph.add_edge("classify_intent", "search_manual")
graph.add_edge("search_manual", "check_complexity")
graph.add_conditional_edges("check_complexity", should_escalate, {...})
graph.add_edge("generate_response", END)
graph.add_edge("human_escalation", END)

# 5. Compile
app = graph.compile()
실습: 고객 서비스 이메일 응답 Agent
섹션 2 후반부의 핵심 실습이다. 흐름은 다음과 같다:
이메일 수신
    ↓
의도 분류 (refund / technical / shipping / general)
    ↓
매뉴얼 검색
    ↓
복잡도 판단
    ↓ (복잡)          ↓ (단순)
사람 에스컬레이션    답변 자동 생성
이 예제가 중요한 이유는 실제 고객센터 자동화에 LangGraph를 그대로 적용할 수 있기 때문이다. 의도 분류 결과를 State에 저장하고, 이후 노드들이 이를 참조하는 패턴이 실무의 기본 구조다.
3. LangGraph 응용 (2:47:32 ~ 5:00:00)
기초 문법을 익혔다면, 이 섹션에서는 실제 서비스 수준의 Agent 아키텍처 패턴을 배운다.
패턴 1: Chaining (체이닝)
가장 단순한 패턴이다. 노드를 순서대로 연결해 단계적으로 처리한다.
입력 → 농담 주제 생성 → 농담 초안 작성 → 농담 다듬기 → 출력
def generate_topic(state):
    topic = llm.invoke("재미있는 농담 주제를 하나 골라줘")
    return {"topic": topic.content}

def write_joke(state):
    joke = llm.invoke(f"{state['topic']}에 대한 짧은 농담 써줘")
    return {"draft": joke.content}

def refine_joke(state):
    refined = llm.invoke(f"이 농담을 더 재미있게 다듬어줘: {state['draft']}")
    return {"final": refined.content}
언제 쓰나: LLM 호출 결과를 다음 LLM 호출의 입력으로 써야 할 때. 프롬프트가 길어질수록 중간 결과를 State로 저장하고 다음 노드에 전달하는 구조가 필요하다.
패턴 2: Parallelization (병렬 처리)
독립적인 작업을 동시에 실행한다. LangGraph에서 같은 노드에서 여러 노드로 Edge를 연결하면 자동으로 병렬 실행된다.
# 농담, 시, 소설 첫 문장을 동시에 생성
graph.add_edge("start", "write_joke")
graph.add_edge("start", "write_poem")
graph.add_edge("start", "write_story")

# 세 결과를 합치는 노드
graph.add_edge("write_joke", "combine_results")
graph.add_edge("write_poem", "combine_results")
graph.add_edge("write_story", "combine_results")
언제 쓰나: 각 작업이 서로 독립적이고 순서가 상관없을 때. 예를 들어 여러 문서를 동시에 요약하거나, 다국어 번역을 병렬로 처리할 때 응답 시간을 크게 줄일 수 있다.
패턴 3: Routing (라우팅)
입력의 특성에 따라 다른 전문가 노드로 보낸다.
def route_customer_query(state) -> str:
    intent = state["intent"]
    routing_map = {
        "payment": "payment_specialist",
        "technical": "tech_specialist",
        "shipping": "shipping_specialist",
    }
    return routing_map.get(intent, "general_support")

graph.add_conditional_edges(
    "classify",
    route_customer_query,
    {
        "payment_specialist": "payment_specialist",
        "tech_specialist": "tech_specialist",
        "shipping_specialist": "shipping_specialist",
        "general_support": "general_support",
    }
)
언제 쓰나: 도메인이 나뉘는 서비스. 결제·기술·배송 문의를 각각 다른 프롬프트(또는 파인튜닝된 모델)로 처리하면 품질이 크게 올라간다.
고급 기법: Worker + Evaluator + Optimizer
섹션 3 후반부에서 다루는 패턴이다. 단순히 출력을 생성하는 것에 그치지 않고, 그 출력을 평가하고 개선하는 루프를 만든다.
Worker (초안 생성)
    ↓
Evaluator (품질 평가)
    ↓ (기준 미달)    ↓ (기준 충족)
Optimizer →         출력
(재시도 지시)
이 패턴을 쓰면 단순 LLM 호출보다 훨씬 일관된 품질을 유지할 수 있다. 실무에서는 Evaluator가 특정 기준(길이, 톤, 정확성 등)을 체크하고 최대 N회까지 재시도하게 설계한다.
Dynamic Interrupt (동적 중단)
특정 조건이 되면 그래프 실행을 멈추고 사람의 확인을 기다리는 기법이다. 섹션 4의 Human-in-the-Loop와 연결된다.
from langgraph.graph import interrupt

def check_before_send(state):
    if state["is_sensitive"]:
        # 여기서 그래프가 일시 중단되고 사람 확인 대기
        interrupt("민감한 내용이 감지되었습니다. 검토 후 승인해주세요.")
    return state
4. Memory (5:00:00 ~ 6:23:08)
단발성 API 호출로 끝나는 Agent와, 대화 맥락을 기억하고 과거로 돌아갈 수 있는 Agent는 실용성 면에서 차원이 다르다. 이 섹션에서 그 차이를 만든다.
Conversation Memory — 대화 기록 유지
LangGraph는 MemorySaver를 통해 체크포인트를 자동으로 저장한다.
from langgraph.checkpoint.memory import MemorySaver

memory = MemorySaver()
app = graph.compile(checkpointer=memory)

# thread_id로 대화 세션을 구분
config = {"configurable": {"thread_id": "user_123_session_1"}}

# 첫 번째 메시지
result = app.invoke({"messages": [HumanMessage("안녕, 나는 서울에 살아")]}, config)

# 두 번째 메시지 — 이전 맥락을 기억함
result = app.invoke({"messages": [HumanMessage("내 도시가 어디라고?")]}, config)
# → "서울이라고 하셨습니다"
thread_id만 동일하게 유지하면 같은 사용자의 대화가 이어진다. 실무에서는 사용자 ID + 세션 ID를 조합해 사용한다.
Time Travel — 과거 상태로 되돌아가기
LangGraph의 가장 강력한 기능 중 하나다. 체크포인트가 저장되어 있기 때문에 그래프 실행 중 어느 시점으로도 돌아갈 수 있다.
# 현재까지의 모든 체크포인트 조회
history = list(app.get_state_history(config))
for checkpoint in history:
    print(checkpoint.config, checkpoint.values)

# 특정 과거 체크포인트로 이동
past_config = history[3].config  # 4번째 체크포인트
app.invoke(None, past_config)     # 그 시점부터 재실행
실무 활용: 잘못된 분기에 들어갔을 때 롤백, A/B 테스트용 분기 실험, 사용자가 “이전 답변으로 돌아가줘"를 요청할 때.
State Snapshot & Checkpoint
# 현재 State 확인
state = app.get_state(config)
print(state.values)  # 현재 State 전체 내용
print(state.next)    # 다음에 실행될 노드

# State 직접 수정 후 재실행 (과거 메시지 수정)
app.update_state(config, {"messages": [HumanMessage("수정된 질문")]})
app.invoke(None, config)  # 수정된 상태에서 재실행
Human-in-the-Loop (사람 승인 루프)
AI가 실행 전 사람의 확인을 받아야 하는 민감한 작업(이메일 발송, 결제 처리, DB 수정 등)에 필수다.
# 컴파일 시 interrupt_before 설정
app = graph.compile(
    checkpointer=memory,
    interrupt_before=["send_email"]  # 이 노드 실행 전 중단
)

# 실행 → "send_email" 직전에 자동으로 멈춤
app.invoke(state, config)

# 사람이 확인 후 승인
print(app.get_state(config).values)  # 현재 State 확인
# → 승인 시
app.invoke(None, config)  # None을 넣으면 멈춘 지점부터 재개
Branching & Merging
체크포인트 기능을 이용해 같은 시작점에서 여러 방향으로 분기 실험을 할 수 있다.
# 체크포인트 A에서 두 가지 접근 방식 비교
branch_config_1 = app.update_state(config, {"strategy": "conservative"})
branch_config_2 = app.update_state(config, {"strategy": "aggressive"})

result_1 = app.invoke(None, branch_config_1)
result_2 = app.invoke(None, branch_config_2)

# 더 좋은 결과를 선택
5. Multi-Agent (6:23:08 ~ 끝)
단일 Agent로 처리할 수 없는 복잡한 문제를 여러 Agent가 협업해 해결한다. 이 섹션은 강의의 클라이맥스이자 실무에서 가장 많이 쓰이는 패턴을 다룬다.
Single Agent의 한계
단일 LLM Agent에 너무 많은 Tool과 책임을 주면 세 가지 문제가 생긴다:
- 컨텍스트 과부하: Tool 설명이 많아질수록 LLM이 올바른 Tool을 선택하지 못함
- 전문성 부족: “뭐든 다 할 수 있는” Agent는 특정 도메인에서 전문 Agent보다 품질이 낮음
- 디버깅 어려움: 어느 단계에서 문제가 생겼는지 추적하기 어려움
Supervisor + Specialist 구조
사용자 요청
    ↓
Supervisor Agent (오케스트레이터)
    ↓
어떤 전문가에게 맡길지 결정
    ↓           ↓           ↓
Research    Writing     Analysis
Agent       Agent       Agent
    ↓           ↓           ↓
        결과 수집
            ↓
    Supervisor가 취합 후 최종 응답
from langgraph.graph import StateGraph, END
from langchain_core.messages import HumanMessage, SystemMessage

# Supervisor가 어떤 에이전트에게 일을 넘길지 결정
def supervisor_node(state):
    system_prompt = """당신은 팀 슈퍼바이저입니다.
    다음 팀원 중 적합한 사람에게 작업을 위임하세요:
    - researcher: 정보 조사 및 수집
    - writer: 글 작성 및 편집
    - analyst: 데이터 분석
    작업이 완료되면 FINISH를 반환하세요."""

    response = llm.invoke([SystemMessage(system_prompt)] + state["messages"])
    return {"next": response.content}  # "researcher" | "writer" | "analyst" | "FINISH"

def should_continue(state):
    return state["next"] if state["next"] != "FINISH" else END
Shared State vs Message Passing
Multi-Agent 시스템에서 Agent 간 통신 방식을 결정해야 한다:
Shared State 방식: 모든 Agent가 같은 State를 읽고 쓴다
- 장점: 구현이 단순, 모든 Agent가 전체 맥락을 볼 수 있음
- 단점: State가 커질수록 관리가 어렵고 충돌 가능성
Message Passing 방식: Agent 간 메시지로 소통
- 장점: 각 Agent의 독립성 보장, 역할 분리 명확
- 단점: 필요한 정보를 메시지에 명시적으로 포함해야 함
실무에서는 두 방식을 혼합하는 경우가 많다. 전체 컨텍스트(대화 기록)는 Shared State로, Agent 간 작업 지시는 Message Passing으로 처리한다.
부록: 실무 적용 가이드
추천 학습 로드맵
| 단계 | 내용 | 기간 |
|---|---|---|
| 1단계 | Lecture 2 완독 → Node·Edge·State 완전 정복 | 1~2일 |
| 2단계 | Lecture 3 실습 3회 반복 → 아키텍처 패턴 체득 | 2~3일 |
| 3단계 | Lecture 4 → Memory + Human-in-the-Loop 구현 | 1~2일 |
| 4단계 | Lecture 5 → 본인 프로젝트에 Multi-Agent 적용 | 1주 |
자주 쓰는 디버깅 기법
그래프 시각화: 노드 연결이 의도한 대로 되었는지 Mermaid 다이어그램으로 확인
print(app.get_graph().draw_mermaid())
# → Mermaid 코드 출력 → https://mermaid.live에서 시각화
State 중간 확인: 특정 노드 실행 후 State가 어떻게 변했는지 확인
for event in app.stream(initial_state, config):
    for key, value in event.items():
        print(f"노드 '{key}' 실행 후 State:", value)
체크포인트 활용: 긴 파이프라인에서 중간 체크포인트를 두어 처음부터 다시 실행하지 않아도 되게 설계
핵심 포인트 요약
- State 설계가 80%: 어떤 데이터를 어떤 형태로 저장할지 먼저 정하고 코딩을 시작한다
- Conditional Edge가 핵심: 단순한 순차 실행을 넘어서려면 조건부 분기를 자유자재로 다뤄야 한다
- 노드는 단일 책임: 하나의 노드에 여러 역할을 주면 디버깅이 어려워진다. 역할당 하나의 노드가 원칙
- Memory는 처음부터: 대화 기억이 필요한 서비스라면 Memory 설계를 처음부터 포함시킨다. 나중에 추가하면 State 구조를 전면 수정해야 한다
- Multi-Agent는 필요할 때만: 단일 Agent로 충분한 문제에 Multi-Agent를 도입하면 오히려 복잡도만 늘어난다
참고 자료
출처: Bloom AI 유튜브 채널 — LangGraph V1 마스터클래스 (2026년 2월) 강의를 보면서 이 글을 함께 참고하면 핵심을 빠르게 파악하는 데 도움이 된다. 각 섹션의 Colab 노트북을 직접 실행하며 코드를 수정해보는 것이 가장 효과적인 학습법이다.