발표 개요
| 항목 | 내용 |
|---|---|
| 발표자 | 테디노트 (TeddyNote) |
| 행사 | 에이전틱 AI 밋업 2025 Q1 (2025년 3월 4일) |
| 발표자료 | linktr.ee/teddynote |
| 핸즈온 튜토리얼 | link.teddynote.com/MEETUP |
| 랭체인 한국어 튜토리얼 | wikidocs.net/book/14314 |
| GitHub | github.com/teddylee777/langchain-kr |
테디노트가 이전 영상(“RAG를 절대 쉽게 결과물을 얻을 수 없는 이유”, “LangGraph 경험하기 전과 후”)에서 이미 다룬 내용을 제외하고, 이번 발표에서만 다루는 LangGraph 유용한 기능과 멀티에이전트 설계 패턴에 집중한다.
1. Advanced RAG의 한계 — 왜 LangGraph가 필요한가
리니어 스트럭처(Linear Structure)의 문제
기존의 Advanced RAG 파이프라인은 단방향이다.
질문 → 벡터 검색 → 문서 조회 → 답변 생성 → 출력
이 구조의 치명적 한계: 중간에 잘못돼도 되돌아갈 수 없다.
- 벡터 검색 결과가 별로여도 그대로 생성 단계로 진행
- 각 단계의 오류가 나비 효과처럼 이후 단계로 전파
- 마지막에 할루시네이션 또는 부정확한 답변으로 귀결
프로덕션 레벨로 가면 이 문제가 더 커진다. 고객 요구치가 높아지고, 다양한 데이터 통합이 필요하며, 최신 모델이 등장할 때마다 파이프라인을 교체해야 한다. 의존성이 강하게 연결된 설계에서는 중간 모듈 하나 바꾸기도 쉽지 않다.
LangGraph가 이를 해결하는 방식
LangGraph는 그래프 기반 동적 파이프라인으로 이 문제를 푼다.
질문 → 벡터 검색 → [문서 평가]
                        ↓ (불충분)    ↓ (충분)
                  쿼리 재작성    답변 생성 → [답변 평가]
                        ↓                      ↓ (불충분)
                    다시 검색              웹 검색 보강
                                               ↓
                                          최종 답변
- 사이클(Cycle): 결과가 마음에 안 들면 이전 단계로 되돌아갈 수 있다
- 브랜칭(Branching): 조건에 따라 다른 경로를 선택한다
- 퍼시스턴스(Persistence): 체크포인트로 각 노드 간 상태를 추적한다
- 로우 레벨 컨트롤: 추상화 레이어를 걷어내고 밑단에서 원하는 수준으로 제어한다
2. 모듈 독립적 개발 — 조립 가능한 노드 설계
독립성이 핵심이다
LangGraph의 노드는 독립적이어야 한다. 노드 간 의존성이 없어야 자유롭게 교체하고 순서를 바꿀 수 있다.
의존성이 있을 때의 문제:
# 나쁜 예: grade_documents가 query_rewrite에 강하게 의존
def grade_documents(state, query_rewrite_result):  # 직접 참조
    ...
의존성이 없을 때:
# 좋은 예: 모든 노드는 State만 읽는다
def grade_documents(state: AgentState) -> dict:
    docs = state["documents"]  # State에서 읽기만
    ...
    return {"grade": "relevant"}  # State에 쓰기만
베이스 템플릿으로 협업하기
모듈이 독립적이면 도메인 전문가 + 흐름 엔지니어가 분리해서 일할 수 있다.
- 중앙에서 베이스 템플릿을 정의한다 (입력/출력 규약, 필수 구현 메서드)
- 도메인 전문가는 이 템플릿에 맞춰 자신의 도메인 로직을 구현한다
- 흐름 엔지니어는 완성된 노드들을 가져다 파이프라인을 구성한다
이렇게 하면 RAG를 모르는 의료 도메인 전문가도 “이 함수 안에 여러분의 로직을 넣으세요"라는 지시만으로 기여할 수 있다.
모델 교체가 몇 초면 된다
# LLM 노드에서 모델만 바꾸면 끝
def generate_response(state: AgentState) -> dict:
    # llm = ChatGoogleGenerativeAI(model="gemini-2.0-flash")
    # llm = ChatOpenAI(model="gpt-5")
    llm = ChatAnthropic(model="claude-opus-4-7")  # 한 줄만 바꾸면 됨
    response = llm.invoke(state["messages"])
    return {"response": response.content}
노드가 독립적이기 때문에 Gemini, GPT-5, DeepSeek, Claude를 번갈아 테스트하는 게 실제로 몇 초면 된다. 유지보수 관점에서도 큰 장점이다.
3. 라우팅 — 두 가지 방식의 차이와 선택 기준
라우팅이 필요한 이유
동일한 “요약해줘"라도 처리 방식이 달라야 한다:
| 질문 | 필요한 처리 |
|---|---|
| “에이전트 개념 요약해줘” | LLM이 이미 알고 있음 → 바로 생성 |
| “오늘 뉴스 요약해줘” | 학습 데이터에 없음 → 웹 검색 선행 |
| “지난 회의록 요약해줘” | 내부 DB에 있음 → DB 검색 선행 |
방식 1: 에이전틱 라우팅 (Tool Calling 기반)
에이전트가 Tool 목록을 보고 스스로 선택한다.
tools = [web_search_tool, document_search_tool]
llm_with_tools = llm.bind_tools(tools)

def agent_node(state):
    response = llm_with_tools.invoke(state["messages"])
    return {"messages": [response]}
장점:
- 어떤 Tool도 선택 안 하는 옵션이 있다 (이미 아는 질문은 바로 답변)
- Tool 추가가 매우 쉽다 (목록에 넣기만 하면 됨)
단점: 각 Tool의 description을 매우 상세하게 작성해야 한다. Tool이 “저를 선택해주세요"라고 어필하듯 설명이 명확해야 에이전트가 올바르게 선택한다.
방식 2: Function Calling 라우팅 (Structured Output 기반)
LLM이 구조화된 출력으로 라우팅 결과를 반환한다.
from pydantic import BaseModel
from typing import Literal

class RouteQuery(BaseModel):
    destination: Literal["web_search", "document_search"]

structured_llm = llm.with_structured_output(RouteQuery)

def route_query(state):
    result = structured_llm.invoke(state["messages"])
    return result.destination  # "web_search" 또는 "document_search"
장점: 예측 가능한 범위 안에서 결과가 나온다. 시스템 프롬프트를 매우 구체적으로 작성해서 라우팅 품질을 높일 수 있다.
단점: 정의한 옵션 중 하나를 무조건 선택해야 한다. “아무것도 안 해도 되는” 케이스가 있으면 별도 옵션(general)을 추가해야 한다.
결론: 에이전틱 라우팅은 유연하고 추가/제거가 쉽다. Function Calling 라우팅은 예측 가능하고 세밀한 제어가 가능하다. 실무에서는 후자가 더 자주 쓰인다 — 결과가 예상 범위를 벗어나는 상황을 줄일 수 있기 때문이다.
4. 병렬 처리 — Fan-out / Fan-in
독립적인 작업을 순차가 아닌 동시에 처리한다.
# 문서 검색과 웹 검색을 동시에
graph.add_edge("start", "document_search")
graph.add_edge("start", "web_search")

# 두 결과를 합치는 노드
graph.add_edge("document_search", "merge_results")
graph.add_edge("web_search", "merge_results")
효과: 순차 처리 대비 시간을 약 1/N으로 줄일 수 있다.
응용:
- 여러 검색 소스를 동시에 조회 (벡터 DB + 웹 + 내부 DB)
- 같은 검색 결과를 여러 모델로 동시에 생성 후 결과 퓨전
- 부분 집합 Fan-out: 조건에 따라 3개 노드 중 2개만 실행
def selective_fanout(state) -> list[str]:
    if state["needs_web"]:
        return ["document_search", "web_search"]
    return ["document_search"]  # 웹 검색 건너뜀
5. 메모리 — 단기/장기/타임 트래블
단기 메모리 (Short-term Memory)
from langgraph.checkpoint.memory import MemorySaver

memory = MemorySaver()
app = graph.compile(checkpointer=memory)

# thread_id로 대화 세션 구분
config = {"configurable": {"thread_id": "user_123_session_A"}}

app.invoke({"messages": [HumanMessage("내 이름은 테디야")]}, config)
app.invoke({"messages": [HumanMessage("내 이름이 뭐라고?")]}, config)
# → "당신의 이름은 테디입니다."

# thread_id 변경하면 이전 대화 기억 없음
config2 = {"configurable": {"thread_id": "user_123_session_B"}}
app.invoke({"messages": [HumanMessage("내 이름이 뭐라고?")]}, config2)
# → "이름을 알 수 없습니다."
핵심: thread_id가 같으면 대화가 이어지고, 달라지면 독립적인 새 대화가 된다.
타임 트래블 (Time Travel)
긴 파이프라인에서 중간 단계로 롤백하는 기능이다.
# 4번 노드까지 실행됐는데 2번 결과가 잘못됨
history = list(app.get_state_history(config))

# 2번 노드 시점으로 롤백
past_state = history[2]
# State를 직접 수정 (잘못된 쿼리 → 올바른 쿼리)
app.update_state(past_state.config, {"query": "개선된 검색어"})
# 2번 시점부터 재실행 (1번은 다시 안 함)
app.invoke(None, past_state.config)
전체를 처음부터 다시 실행하지 않아도 된다. 개발 중 디버깅과 실험에 매우 유용하다.
장기 메모리 (Long-term Memory)
MemoryStore를 사용하면 thread를 넘어 공유되는 메모리를 만들 수 있다.
from langgraph.store.memory import InMemoryStore

store = InMemoryStore()
app = graph.compile(checkpointer=memory, store=store)

# user_id로 장기 메모리 구분 (thread가 달라도 공유됨)
config = {
    "configurable": {
        "thread_id": "session_new",
        "user_id": "teddy"
    }
}
저장 전략: 모든 대화 내용을 저장하는 것은 효율적이지 않다. **장기적으로 기억해야 할 정보(이름, 직업, 취향, 위치)**만 추출해서 저장한다.
# LLM이 대화에서 개인 정보를 자동 추출해 저장
class PersonalEntity(BaseModel):
    name: Optional[str] = None
    job: Optional[str] = None
    location: Optional[str] = None
    hobby: Optional[str] = None

def extract_and_save_memory(state, store, config):
    user_id = config["configurable"]["user_id"]

    # 대화에서 개인 정보 추출
    extractor = llm.with_structured_output(PersonalEntity)
    entity = extractor.invoke(state["messages"])

    # 장기 메모리에 저장
    store.put(("user_profile", user_id), "profile", entity.dict())
이렇게 저장된 정보를 시스템 프롬프트에 주입하면, 새로운 세션에서도 사용자의 이름과 취향을 기억하는 AI를 만들 수 있다.
6. Human-in-the-Loop — 사람이 중간에 개입하기
언제 필요한가
- 민감한 작업 전 승인 (이메일 발송, 결제, DB 수정)
- 긴 리서치 파이프라인 중간에 방향 수정
- 고객 상담 중 상담사 연결이 필요할 때
구현 방법
from langgraph.types import interrupt

def review_content(state):
    # 여기서 실행이 멈추고 사람의 입력을 기다림
    user_feedback = interrupt({
        "content": state["draft"],
        "question": "이 내용으로 진행할까요? (승인/수정 내용)"
    })
    return {"feedback": user_feedback}

# interrupt_before로 특정 노드 실행 전 중단
app = graph.compile(
    checkpointer=memory,
    interrupt_before=["send_email"]
)
# 실행 → send_email 직전에 멈춤
app.invoke(state, config)

# 사람이 State 확인 후 승인
print(app.get_state(config).values)
app.invoke(None, config)  # 멈춘 지점부터 재개
딥 리서치 스타일 파이프라인에서 단계별로 “이 방향으로 계속 진행할까요?“라고 물어보는 인터랙티브 워크플로우를 만들 수 있다.
7. 멀티에이전트 협업 — Swarm에서 Supervisor까지
왜 멀티에이전트가 필요한가
단일 에이전트에 글쓰기, 코딩, 마케팅, 리서치를 모두 맡기면 전문성이 떨어진다. 특화된 에이전트 여러 개가 협업하는 구조가 더 나은 결과를 낸다.
Swarm 패턴 (초기 방식)
OpenAI Swarm에서 제안한 방식이다. 에이전트들이 handoff로 서로 작업을 위임한다.
사용자 → 플라이트 에이전트 → (handoff) → 호텔 에이전트 → 사용자
문제점:
- 에이전트가 늘어날수록 라우팅 경우의 수가 폭발적으로 증가
- 각 에이전트의 프롬프트에 “누구에게 위임할 것인가"를 모두 명시해야 함
- 사람이 계속 모니터링하고 개입해야 함
Supervisor 패턴 (현재 대세)
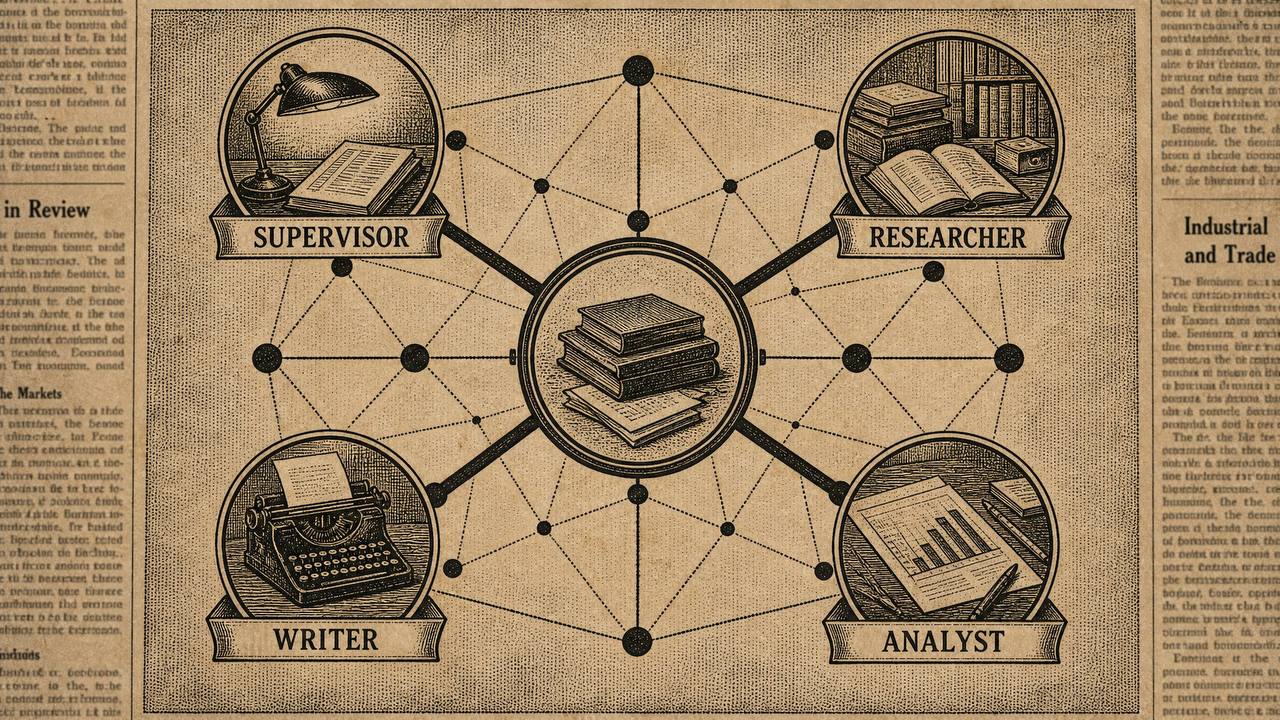
팀장 역할의 Supervisor 에이전트 하나가 모든 조율을 담당한다.
사용자 → Supervisor
              ↓ (task 분배)
    ┌─────────┼─────────┐
Researcher  Writer  Analyst
    └─────────┼─────────┘
              ↓ (결과 반환)
         Supervisor
              ↓ (최종 검토/재지시)
           사용자
def supervisor_node(state):
    system_prompt = """당신은 팀 슈퍼바이저입니다.
    팀원: researcher(정보 수집), writer(글 작성), analyst(데이터 분석)
    작업을 완료할 팀원을 선택하거나, 완료시 FINISH를 반환하세요."""

    response = llm.with_structured_output(NextAction).invoke(
        [SystemMessage(system_prompt)] + state["messages"]
    )
    return {"next": response.next_agent}
Supervisor 패턴의 장점:
- 모든 에이전트가 Supervisor에게 결과를 반환 → 라우팅이 단순해짐
- 새 에이전트 추가 시 Supervisor 라우팅만 수정하면 됨
- Supervisor가 자동으로 피드백을 처리 → 사람 개입 최소화
LangGraph는 이 패턴을 위한 공식 라이브러리를 별도로 출시했다.
서브그래프를 노드로 사용하기
복잡한 그래프를 다른 그래프의 노드로 재사용할 수 있다.
# 복잡한 "페이퍼 작성 팀" 그래프
paper_writing_team = StateGraph(...)
# ... (리서처, 라이터, 에디터 노드 복잡하게 구성)
paper_writing_app = paper_writing_team.compile()

# 상위 그래프에서 하나의 노드로 사용
outer_graph = StateGraph(OuterState)
outer_graph.add_node("paper_writing_team", paper_writing_app)
팀을 조립 블록처럼 사용할 수 있어 대규모 에이전트 시스템을 모듈식으로 구성할 수 있다.
기타 멀티에이전트 패턴
| 패턴 | 특징 |
|---|---|
| Plan-and-Execute | 질문을 단계로 분해 → 계획 수립 → 순서대로 실행 → 결과 종합 |
| Hierarchical Agent Teams | Supervisor 아래 Sub-Supervisor가 있는 계층 구조 |
| STORM Research | 가상 페르소나 애널리스트를 만들어 병렬 인터뷰 → 논문 작성 |
STORM은 특히 흥미롭다. “제프리 힌튼 교수"와 “일론 머스크"라는 가상 페르소나를 만들고, 각각의 관점에서 특정 주제를 인터뷰한 뒤 웹/논문 검색으로 보강해 리서치 페이퍼를 자동 생성한다.
실무 적용 핵심 요약
리니어 RAG의 한계를 느꼈다면: LangGraph의 사이클·분기 기능으로 검색-평가-재시도 루프를 구현하라
노드는 반드시 독립적으로: State만 읽고 쓰게 설계하면 모델 교체, 노드 교체, 순서 변경이 자유로워진다
라우팅은 두 가지 중 선택: 유연성이 중요하면 에이전틱, 예측 가능성이 중요하면 Function Calling
Memory는 처음부터 설계에 포함: 단기(thread)와 장기(user) 메모리를 구분해 설계한다
멀티에이전트는 Supervisor 패턴으로: 현재 가장 안착된 패턴이며 확장이 쉽다
원본 영상: LangGraph를 활용한 Agentic AI 시스템 구축 — 에이전틱AI 밋업 2025 Q1 (테디노트, 2025년 3월)