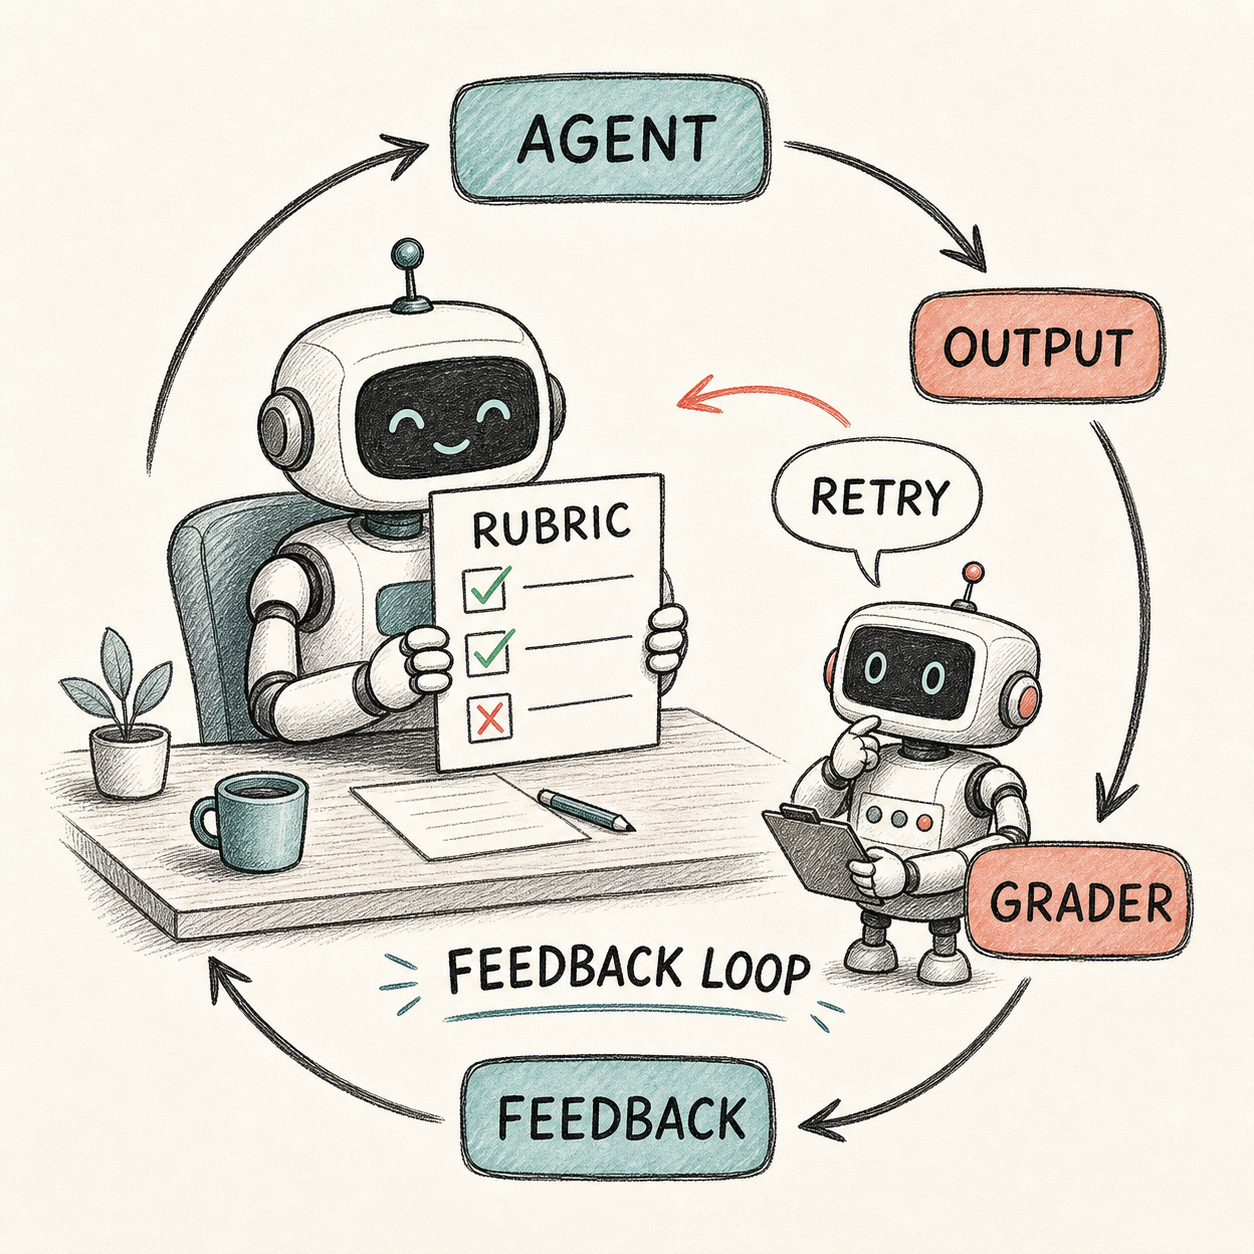
LangChain이 6월 2일에 Deep Agents 쪽에 RubricMiddleware를 추가했습니다. 한 줄로 요약하면, “이 에이전트의 결과가 합격인지 아닌지"를 채점하는 서브에이전트를 끼워 넣고, 기준 미달이면 피드백을 다시 주입해 재실행시키는 루프입니다. Claude Code나 Codex의 /goal 패턴과 비슷하지만, 채점 단계를 별도 서브에이전트로 분리하고 채점자가 도구까지 호출할 수 있다는 점이 다릅니다.
핵심 요약
- 무엇을 푸나 — 에이전트는 방향은 맞게 잡지만 한 번에 결승선까지 못 가는 경우가 많습니다. 모호한 지시·도구 오용·비결정적 오류가 쌓이면 결과 품질이 떨어지고, 개발자가 직접 진단하고 다시 돌려야 했습니다.
- 무엇을 더하나 —
RubricMiddleware는 본 에이전트가 끝나기 직전에 별도 채점 서브에이전트를 호출합니다. 항목별 통과 여부를 따져 보고, 못 채운 항목이 있으면 그 피드백을 대화에 다시 끼워 넣고 에이전트를 한 번 더 돌립니다. - 언제 끝나나 — 루프 종료 조건은 네 가지입니다.
satisfied,max_iterations_reached,failed,grader_error. 무한 루프를 막기 위해 최대 반복 횟수를 반드시 지정합니다. - 어디에 잘 맞나 — “이게 끝났다"는 기준이 명확한 작업입니다. 테스트가 통과해야 하는 코드 리팩터, 금칙 패턴을 피해야 하는 출력, 필수 섹션이 다 들어가야 하는 보고서 같은 경우입니다.
- 무엇이 다른가 — 채점자가 단순히 추론만 하지 않고, 테스트 러너·린터·검증 함수 같은 도구를 호출할 수 있습니다. 증거 기반으로 합격/불합격을 매기는 셈입니다.
왜 만들었나
에이전트가 다루는 작업이 점점 복잡해지고 있습니다. 컨텍스트가 길어지면 지시가 흐려지고, 도구 호출이 어긋나고, 모델의 비결정성까지 겹치면 출력 품질이 들쭉날쭉해집니다. 그렇게 되면 사람이 매번 결과를 확인하고, 안 되면 다시 돌리고, 어디가 틀렸는지 손으로 짚어 줘야 합니다.
LangChain이 깐 가설은 단순합니다. “끝났다"는 기준을 미리 글로 적어 두면 그 글을 보고 채점하는 일은 자동화할 수 있다는 거죠. 사람이 매번 검사하지 말고, 시스템이 직접 자기 결과물을 채점하고 부족하면 다시 시도하게 만들자는 발상입니다.
어떻게 동작하나
흐름은 이렇습니다. 본 에이전트가 한 번 답을 만들면, 채점용 서브에이전트가 그 결과를 루브릭과 대조합니다. 모든 항목을 통과하면 거기서 종료합니다. 한 항목이라도 미달이면, 채점자가 항목별로 무엇이 왜 부족했는지 적은 피드백을 대화에 다시 주입하고, 본 에이전트가 한 번 더 도전합니다.
핵심 디테일은 채점자에게도 도구를 쥐여 줄 수 있다는 점입니다. 예를 들어 코드 생성이라면 run_test_suite 같은 함수를 채점자 도구로 등록해 두면, 실제로 테스트를 돌려 보고 통과 여부를 판정합니다. 도구가 없으면 대화 내용만으로 추론해서 판정합니다.

가장 짧은 코드 예시
준비물은 세 가지입니다. 채점 미들웨어를 정의하고, 에이전트에 붙이고, 호출할 때 루브릭 문자열을 같이 넘기면 됩니다. 루브릭을 안 넘기면 미들웨어는 아무 일도 안 합니다.
1) 채점 미들웨어 정의
from deepagents import RubricMiddleware

rubric_middleware = RubricMiddleware(
    model="anthropic:claude-haiku-4-5",
    system_prompt="You are a code reviewer grading generated code against a rubric.",
    tools=[run_test_suite],
    max_iterations=5,
)
채점용 모델은 본 에이전트보다 가볍고 저렴한 쪽을 쓰는 게 보통입니다. tools에는 채점자가 호출할 수 있는 검증 함수를 넣고, max_iterations로 재시도 상한을 정합니다.
2) Deep Agent에 붙이기
from deepagents import create_deep_agent

agent = create_deep_agent(
    model="anthropic:claude-sonnet-4-6",
    system_prompt=(
        "You are a careful Python engineer. Write correct, readable code. "
        "Follow the user's instructions exactly."
    ),
    middleware=[rubric_middleware],
)
에이전트의 system_prompt는 어떻게 작업할지를 말해 주고, 루브릭은 어떻게 채점할지를 알려 줍니다. 역할이 깔끔하게 갈립니다.
3) 호출 시 루브릭 전달
from langchain.messages import HumanMessage

result = agent.invoke(
    {
        "messages": [
            HumanMessage(
                content=(
                    "Write a Python function `find_duplicates(lst)` that returns a list of "
                    "all elements that appear more than once in the input list, in the order "
                    "they first appear."
                )
            )
        ],
        "rubric": (
            "- All tests pass in run_test_suite\n"
            "- The function is named `find_duplicates` and accepts a single list argument\n"
        ),
    },
    config={"configurable": {"thread_id": "code-generation-session"}},
)
print(result["messages"][-1].text)
rubric은 그냥 줄바꿈으로 나눈 체크리스트입니다. “테스트가 다 통과해야 함”, “함수 이름은 이거여야 함” 같은 검증 가능한 항목으로 적는 게 핵심입니다.
실제로 어떻게 굴러갔나
위 예시를 돌렸을 때 첫 시도는 그럴듯해 보였지만 테스트 하나에서 막혔다고 합니다. 채점자의 답은 이랬습니다.
“한 테스트가 실패함: test_unhashable. 입력 리스트 안에 리스트처럼 해시 불가능한 타입이 들어오면 TypeError로 죽는다.”
“다시 해 봐"라는 막연한 지시가 아니라, 어디서 왜 막혔는지를 짚어 줍니다. 에이전트는 이걸 받고 두 번째 시도에서 구현을 고쳐 모든 테스트를 통과시켰습니다. 항목별로 합격/불합격이 따로 나오니까, 에이전트도 정확히 무엇을 고쳐야 하는지 알게 됩니다.
왜 의미가 있나
에이전트 출력은 본질적으로 확률적입니다. 같은 프롬프트를 두 번 돌려도 한 번은 통과하고 한 번은 모자랍니다. 지금까지는 그 편차를 사람이 받아 냈습니다. 결과를 보고, 다시 돌리고, 어디가 어긋났는지 직접 짚어야 했죠.
RubricMiddleware는 그 부담을 시스템 쪽으로 옮깁니다. “끝났다"는 정의를 한 번 적어 두면, 재시도 루프는 그 글을 보고 알아서 돕니다. 재시도가 무작정이 아니라, 채점자의 항목별 피드백을 보고 표적 수정으로 들어가는 점이 중요합니다.
실무자가 볼 핵심 포인트
- 검증 가능한 작업에 먼저 적용하세요. 테스트 통과, 정규식 통과, 필수 섹션 포함처럼 기계가 “되었다/안 되었다"를 명확히 답할 수 있는 작업에서 효과가 큽니다. 글의 톤이나 미적 판단 같은 모호한 기준은 효과가 떨어집니다.
- 채점자 모델은 본 모델보다 작아도 됩니다. 예시도 본 작업은 Sonnet, 채점은 Haiku로 나눠 비용을 줄였습니다. 채점은 “이 결과가 기준을 충족했는가"라는 분류 문제에 가까워서 무거운 모델이 꼭 필요하지 않습니다.
max_iterations는 반드시 정하세요. 무한 루프 방지선이자 비용 통제선입니다. 모델 호출이 매 반복마다 곱절로 늘기 때문에, 3~5회 정도로 시작해 데이터를 보며 조정하는 게 안전합니다.- 채점자에게도 도구를 주세요. 코드라면 테스트 러너, 문서라면 섹션 체크 함수, 외부 호출이라면 응답 검증 함수처럼, 채점자가 직접 증거를 모을 수 있게 만들면 판정이 훨씬 신뢰할 만해집니다.
- 루브릭은 측정 가능한 문장으로 적으세요. “좋은 코드를 작성” 같은 추상적 표현 대신 “모든 테스트 통과”, “함수명은 X”, “한 함수는 50줄 이하” 같은 식으로 검사 가능한 단위로 쪼개야 합니다.
- 베타 단계라는 점은 기억해 두세요. LangChain도 API가 바뀔 수 있다고 명시했습니다. 프로덕션에 넣을 때는 버전 고정과 회귀 테스트를 같이 챙기는 게 좋습니다.
원문 출처
원문 보기 — Shrikar Seshadri, Sydney Runkle, LangChain Blog, 2026-06-02