출처: LangChain Blog
문서유형: 원문 해설
#LangChain #LangSmith #AgentObservability #LLMEvaluation #AIAgent
핵심 요약
LangChain의 글 **“You don’t know what your agent will do until it’s in production”**은 프로덕션 AI 에이전트 운영에서 가장 중요한 문제를 짚습니다. 전통적인 소프트웨어는 입력 경로가 어느 정도 정해져 있지만, LLM 에이전트는 자연어를 입력으로 받고, 도구를 호출하고, 여러 단계의 추론을 거쳐 결과를 만듭니다. 그래서 단순히 latency, error rate, CPU 사용률만 봐서는 에이전트가 “잘 일하고 있는지” 알 수 없습니다.
핵심은 분명합니다. 에이전트 모니터링은 시스템 상태가 아니라 대화, 판단 과정, 도구 호출, 최종 품질을 함께 보는 일입니다. 프로덕션 trace는 장애 로그가 아니라, 에이전트를 계속 개선하기 위한 학습 데이터가 됩니다.

왜 기존 모니터링으로 부족한가
전통적인 웹 서비스는 사용자가 버튼을 누르고, 폼을 채우고, API가 정해진 형식으로 호출됩니다. 테스트도 비교적 명확합니다. checkout flow, login flow, payment flow처럼 가능한 경로를 어느 정도 나열할 수 있습니다.
하지만 에이전트는 다릅니다. 예를 들어 환불 요청 하나만 봐도 사용자는 이렇게 말할 수 있습니다.
- “환불하고 싶어요.”
- “지난주에 산 신발 돈 돌려받을 수 있나요?”
- “물건이 망가져서 왔는데 어떻게 해야 하죠?”
- “order #12345 refund please”
의도는 비슷하지만 표현은 모두 다릅니다. 에이전트는 이 자연어 표현을 이해하고, 필요한 정보를 추출하고, 적절한 도구를 선택해야 합니다. 즉 입력 공간이 사실상 무한합니다.
여기에 LLM 특유의 비결정성도 있습니다. 같은 요청이라도 문장 순서, 문맥, 프롬프트의 작은 차이에 따라 결과가 달라질 수 있습니다. 개발 환경에서 잘 되던 프롬프트가 실제 사용자 입력에서는 틀린 도구를 선택하거나, 애매한 답변을 낼 수 있습니다.
프로덕션에서 봐야 할 것
LangChain은 에이전트 관측성에서 가장 중요한 신호가 대화 자체와 중간 궤적에 있다고 봅니다. 단순히 “요청이 200으로 끝났다”가 아니라, 다음 정보를 봐야 합니다.
첫째, 완전한 prompt-response pair입니다. 사용자가 무엇을 물었고, 에이전트가 어떻게 답했는지를 저장해야 합니다.
둘째, multi-turn context입니다. 에이전트는 한 번의 요청보다 여러 턴의 대화 속에서 일하는 경우가 많습니다. 따라서 개별 로그가 아니라 하나의 conversation/session으로 묶어 봐야 합니다.
셋째, agent trajectory입니다. 어떤 reasoning step을 거쳤는지, 어떤 tool을 호출했는지, retrieval 결과가 적절했는지, 최종 답변이 그 과정과 맞는지를 봐야 합니다.
이 지점에서 전통적인 APM과 에이전트 observability가 갈라집니다. 웹 요청 로그는 POST /api/checkout 200 OK 342ms로 요약될 수 있지만, 에이전트 interaction은 자연어 대화와 수십 개의 중간 단계로 구성됩니다.
사람의 판단을 어떻게 확장할 것인가
에이전트 품질 평가는 결국 사람의 판단이 필요합니다. 답변이 도움이 됐는지, 의도를 제대로 이해했는지, 말투가 적절했는지, 검색 결과가 맞았는지는 숫자 하나로 끝나지 않습니다.
문제는 규모입니다. 사람이 시간당 50~100개 trace를 검토한다고 해도, 하루 1,000건만 넘어가면 모든 데이터를 직접 보는 방식은 바로 막힙니다. LangChain은 이 문제에 대해 두 가지 접근을 제안합니다.
1. Annotation queue
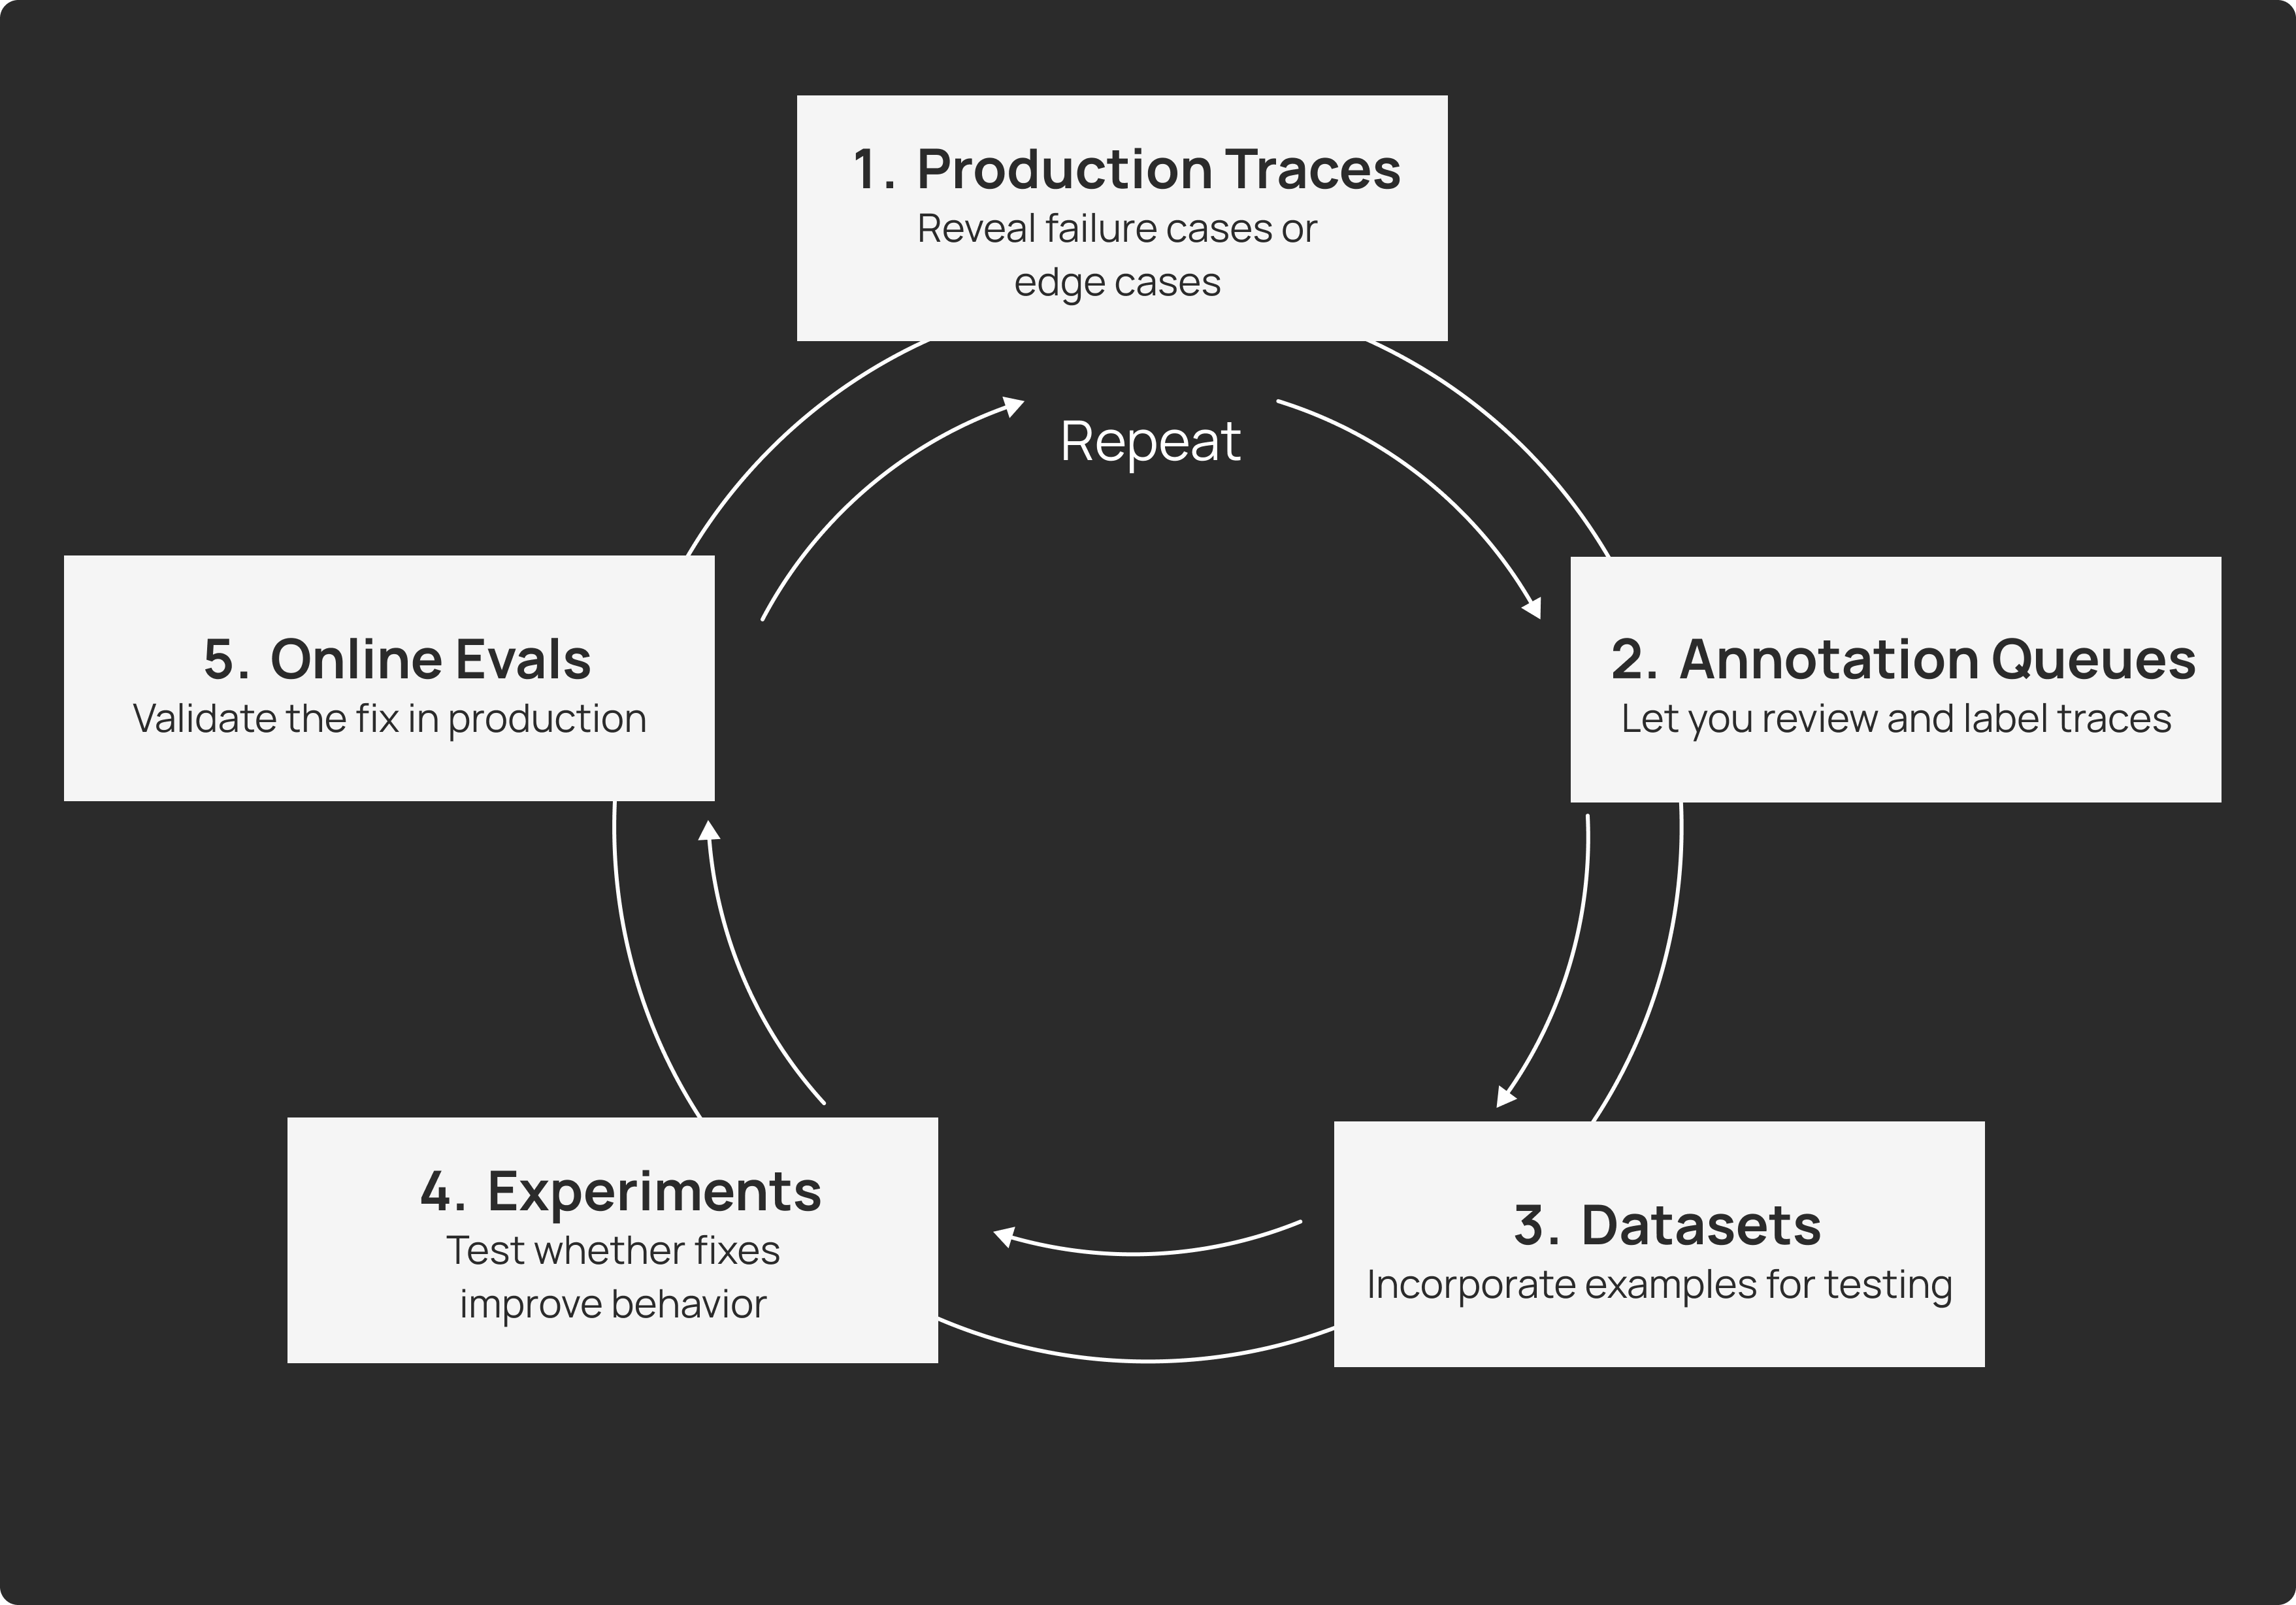
Annotation queue는 검토할 trace를 구조화된 큐로 보내는 방식입니다. 모든 로그를 뒤지는 대신, 부정적 피드백이 붙은 실행, 비용이 높은 실행, 특정 기간의 실행, 특정 기능 영역의 실행만 리뷰 대상으로 보냅니다.
리뷰어는 relevance, correctness, tone, safety 같은 기준으로 평가하고, 필요한 경우 수정 답변이나 라벨을 붙입니다. 이 데이터는 나중에 evaluation dataset이 됩니다.
즉 annotation queue는 단순 QA 도구가 아니라 실제 프로덕션 실패 사례를 평가 데이터로 바꾸는 장치입니다.
2. LLM-as-judge / Online evaluation
두 번째 방법은 LLM 자체를 평가자로 쓰는 것입니다. 자동 평가자는 coherence, tone, safety, format, topic classification 같은 항목을 대규모로 점검할 수 있습니다.
다만 LangChain은 자동 평가를 맹신하지 말라고 말합니다. 비용과 latency가 있고, evaluator 자체도 틀릴 수 있습니다. 특히 “좋은 답변”의 기준은 제품마다 다르기 때문에 custom evaluator를 만들고, 사람의 라벨과 얼마나 일치하는지 검증해야 합니다.
현실적인 권장 방식은 전체 트래픽을 다 평가하는 것이 아니라 10~20% 정도를 샘플링하고, 자동 평가와 사람 리뷰를 섞는 것입니다.
LangSmith가 제안하는 운영 도구들
LangChain은 이런 요구를 LangSmith에 반영했다고 설명합니다. 핵심 도구는 세 가지입니다.
첫째, Insights Agent입니다. 프로덕션 trace를 자동으로 클러스터링해 사용 패턴, 오류 패턴, edge case를 찾아줍니다. 제품 담당자는 “사용자들이 copilot으로 주로 무엇을 하려 하는가?”를 볼 수 있고, 엔지니어는 “어떤 상황에서 잘못된 tool을 선택하는가?”를 볼 수 있습니다.
둘째, Online Evaluations입니다. 프로덕션 trace 일부 또는 전체에 evaluator를 자동 실행해 품질, 안전성, 포맷, topic, trajectory를 지속적으로 평가합니다. 모델 변경, 프롬프트 변경, 사용자 패턴 변화로 품질이 떨어질 때 조기에 감지할 수 있습니다.
셋째, dashboards and alerts입니다. 중요한 것은 단순 시스템 지표가 아니라 업무 지표입니다. latency와 error rate도 봐야 하지만, task completion rate, user satisfaction, tool call failure rate, run count by tool, workflow별 비용과 품질 같은 지표가 더 중요해집니다.
왜 Datadog이나 New Relic만으로는 부족한가
기존 APM 도구도 latency, traffic, error는 잘 봅니다. 하지만 LangChain은 세 가지 한계를 지적합니다.
첫째, payload 문제입니다. 에이전트 관측성은 전체 대화, system prompt, few-shot example, tool call, retrieval context까지 저장하고 검색해야 합니다. 일반 로그 구조만으로는 자연어 payload를 의미 기반으로 분석하기 어렵습니다.
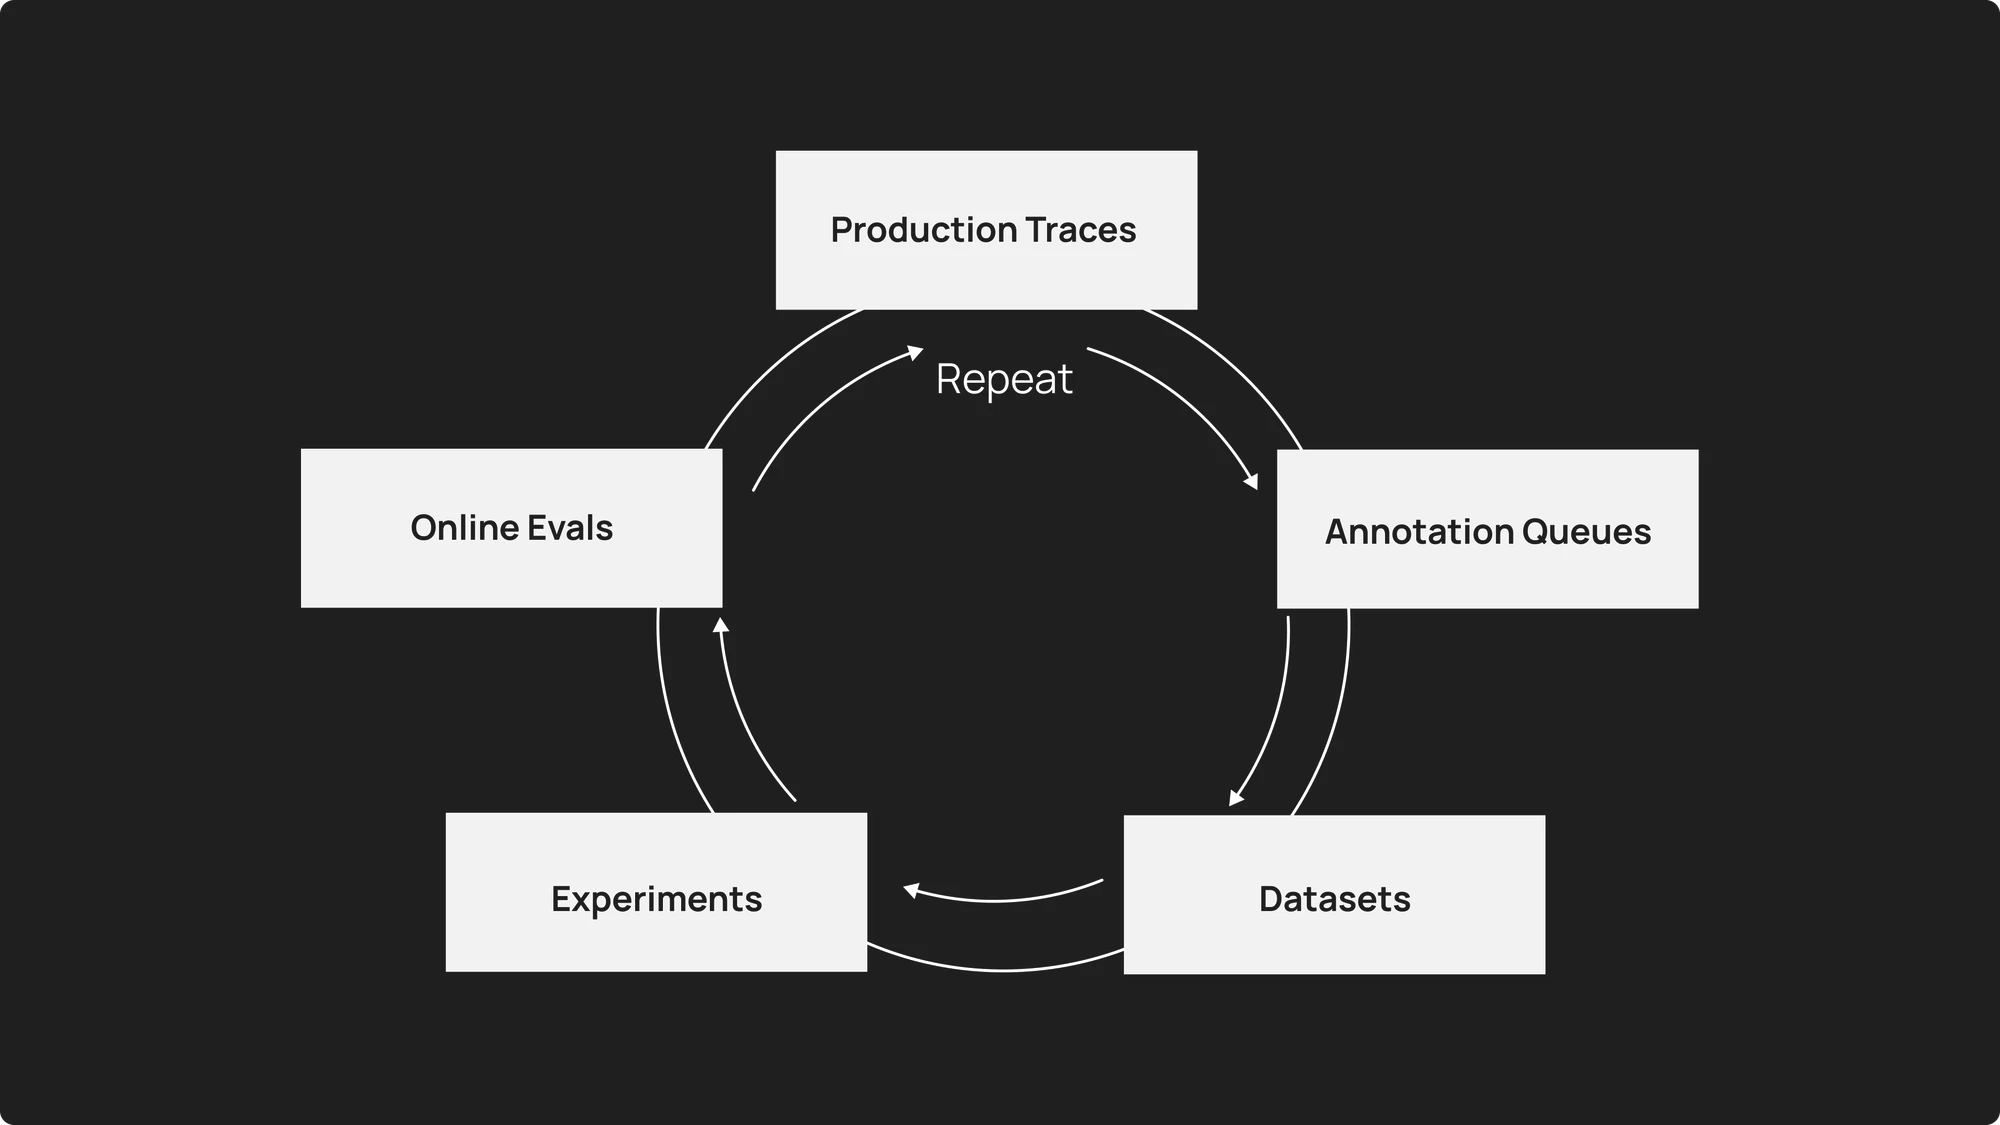
둘째, 개발 루프와의 연결성입니다. 좋은 에이전트 개선 흐름은 production trace → annotation queue → dataset → experiment → redeploy → online evaluation으로 이어져야 합니다. 관측성과 평가, 실험, 배포가 끊겨 있으면 같은 실패를 계속 반복하게 됩니다.
셋째, 사용자층이 다릅니다. 전통적 observability는 주로 SRE와 DevOps가 봅니다. 반면 에이전트 observability는 AI/ML 엔지니어, 제품 매니저, 도메인 전문가, 데이터 사이언티스트가 함께 봐야 합니다. 품질 문제는 인프라 문제가 아니라 제품 경험 문제이기도 하기 때문입니다.
실무자가 가져갈 점
프로덕션 에이전트를 운영한다면 최소한 다음 네 가지는 갖춰야 합니다.
- 대화와 tool call을 포함한 full trace 저장
- 실패/고비용/사용자 불만 trace를 annotation queue로 보내는 흐름
- 일부 트래픽에 대한 online evaluation과 topic classification
- trace를 evaluation dataset으로 전환해 배포 전 실험에 재사용하는 루프
여기에 개인정보와 민감정보 처리도 반드시 포함되어야 합니다. prompt-response를 그대로 저장하면 품질 개선에는 좋지만, privacy와 compliance 리스크가 커집니다. 따라서 masking, retention policy, 접근 권한, 데이터 샘플링 전략을 같이 설계해야 합니다.
정리
LLM 에이전트는 기존 소프트웨어처럼 “정해진 입력에 정해진 출력”을 내는 시스템이 아닙니다. 자연어 입력은 무한하고, LLM은 작은 표현 변화에도 흔들리며, 에이전트는 도구 호출과 추론 경로를 통해 결과를 만듭니다.
그래서 프로덕션 모니터링의 중심도 바뀝니다. 이제 중요한 것은 서버가 살아 있는지가 아니라, 에이전트가 어떤 판단을 했고, 왜 그렇게 행동했으며, 그 결과가 사용자에게 실제로 도움이 됐는가입니다.
LangChain의 글은 에이전트 운영의 현실적인 결론을 보여줍니다. 프로덕션 trace는 나중에 보는 로그가 아니라, 에이전트를 계속 개선하는 재료입니다. 좋은 관측성은 좋은 평가로 이어지고, 좋은 평가는 더 안전한 배포와 더 나은 사용자 경험으로 이어집니다.
원문 : You don’t know what your agent will do until it’s in production