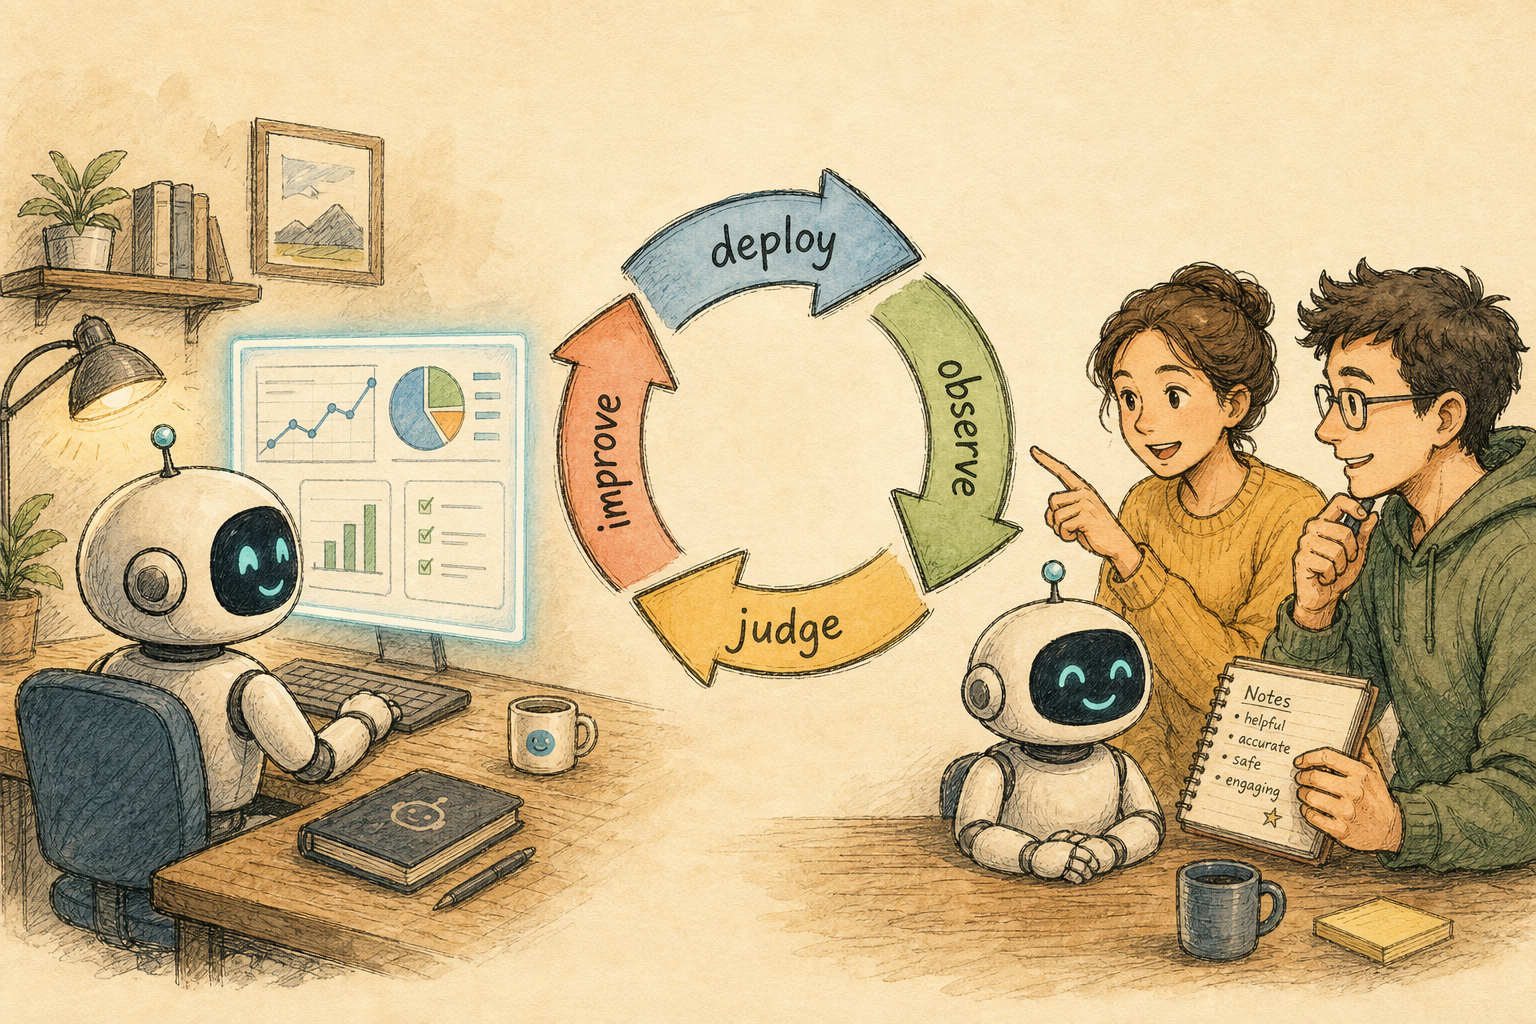
에이전트가 진짜 쓸 만해지는 순간은, 우리 팀이 오랫동안 쌓아 온 판단이 그 안에 녹아 들어갈 때입니다. 문서로 정리된 매뉴얼은 그대로 떠먹이면 됩니다. 진짜 어려운 건 시니어들의 머릿속에만 있는, 말로 잘 안 풀어 본 그 직관입니다.
LangChain이 4월 9일에 올린 글 ‘Human judgment in the agent improvement loop’는 이 문제를 정면으로 다룹니다. 에이전트 개발 어디에 사람의 판단을 끼워 넣어야 하는지, 그리고 그 판단을 어떻게 자동 평가로 옮겨서 운영 단계까지 굴리는지에 대한 이야기입니다.
핵심 요약
- 사람의 판단이 필요한 핵심 지점은 네 곳입니다 — 워크플로 설계, 도구 설계, 에이전트 컨텍스트, 그리고 평가 기준.
- 모든 출력을 사람이 일일이 보는 것보다, 사람이 평가자(evaluator) 를 보정해 두는 쪽이 훨씬 레버리지가 큽니다.
- LangSmith의 Align Evaluator는 사람의 라벨에 맞춰 LLM-as-a-judge 평가자를 캘리브레이션해 줍니다.
- 개발 단계에서는 작은 시나리오 세트와 기대 동작을 미리 정의해 두고, 그라운드 트루스 데이터셋으로 굳혀 갑니다.
- 배포 후에는 운영 데이터에서 온라인 평가·알람·어노테이션 큐를 돌려, 사람이 봐야 할 케이스만 큐레이션합니다.
- LangSmith Insights Agent는 트레이스 데이터에서 패턴을 끌어올려 다음 개선 항목의 단서를 만들어 줍니다.
- 운영 중 쌓이는 진짜 사용자 입력이 가장 좋은 테스트 케이스 원천입니다. ‘골든 데이터셋’으로 기준선을 잡고 회귀를 추적합니다.
본문
트레이더용 카피일럿 — 예시 하나로 풀어보기
글의 출발점은 금융사의 가상 사례입니다. 트레이더들이 시장 데이터를 요청하면, 지금은 데이터 사이언티스트가 매번 SQL을 손으로 짭니다. 여기에 카피일럿을 붙이려면 두 층의 맥락이 필요합니다. 금융 도메인 지식(이 트레이더가 정말 알고 싶은 게 무엇인가)과 기술적 DB 레이어 지식(스키마, 인덱스, 비용)이 동시에 필요합니다. 이 사례 하나가 글 전체를 관통합니다.
사람의 판단이 들어가야 하는 네 자리
워크플로 설계. 모든 단계를 LLM에 맡기는 게 항상 정답은 아닙니다. 결정론적 코드로 박아 두면 지연이 줄고, 토큰이 줄고, 중요한 단계가 반드시 실행됩니다. 어떤 검증을 코드로 박을지는 리스크·컴플라이언스 담당자가 가장 잘 압니다.
도구 설계. 카피일럿이라면 스키마 조회, 쿼리 실행, 문서 검색 도구가 필요합니다. 여기서 트레이드오프가 갈립니다. LLM이 만든 쿼리를 그대로 실행시킬 것인가, 화이트리스트 안에서만 움직이게 할 것인가. 자유도와 통제 사이에서 어디에 선을 그을지는 결국 도메인 전문가의 판단입니다.
에이전트 컨텍스트. 업계가 한 방향으로 움직이고 있습니다. 실행 시작 시점에 훨씬 풍부한 컨텍스트를 미리 넣어 주는 쪽입니다. 모든 정보를 시스템 프롬프트 하나에 욱여넣지 말고, 문서·예시·도메인 규칙을 미리 큐레이션해 두고 런타임에 필요한 것만 끌어 쓰게 하라는 이야기입니다. 에이전트에게 어떤 지식을 줄지, 그리고 그 지식을 어떻게 구조화할지는 결국 사람의 결정입니다.
평가 — 사람의 판단을 자동화로 옮기는 다리
여기서부터가 글의 진짜 본론입니다. 핵심 원칙은 단순합니다.
사람이 평가자를 설계하고 보정하게 만들어라. 사람이 출력 더미를 직접 뒤지지 말고.
수천 건의 트레이스를 매번 사람이 본다는 건 현실적이지 않습니다. 대신 LLM-as-a-judge를 쓰되, 그 심판이 우리 팀의 판단을 충실히 흉내 내도록 캘리브레이션해 두는 게 레버리지를 만듭니다. LangSmith의 Align Evaluator는 사람이 라벨링한 소수의 예시로 이 캘리브레이션을 자동화해 줍니다.
개발 단계 — 테스트 슈트와 평가자를 먼저
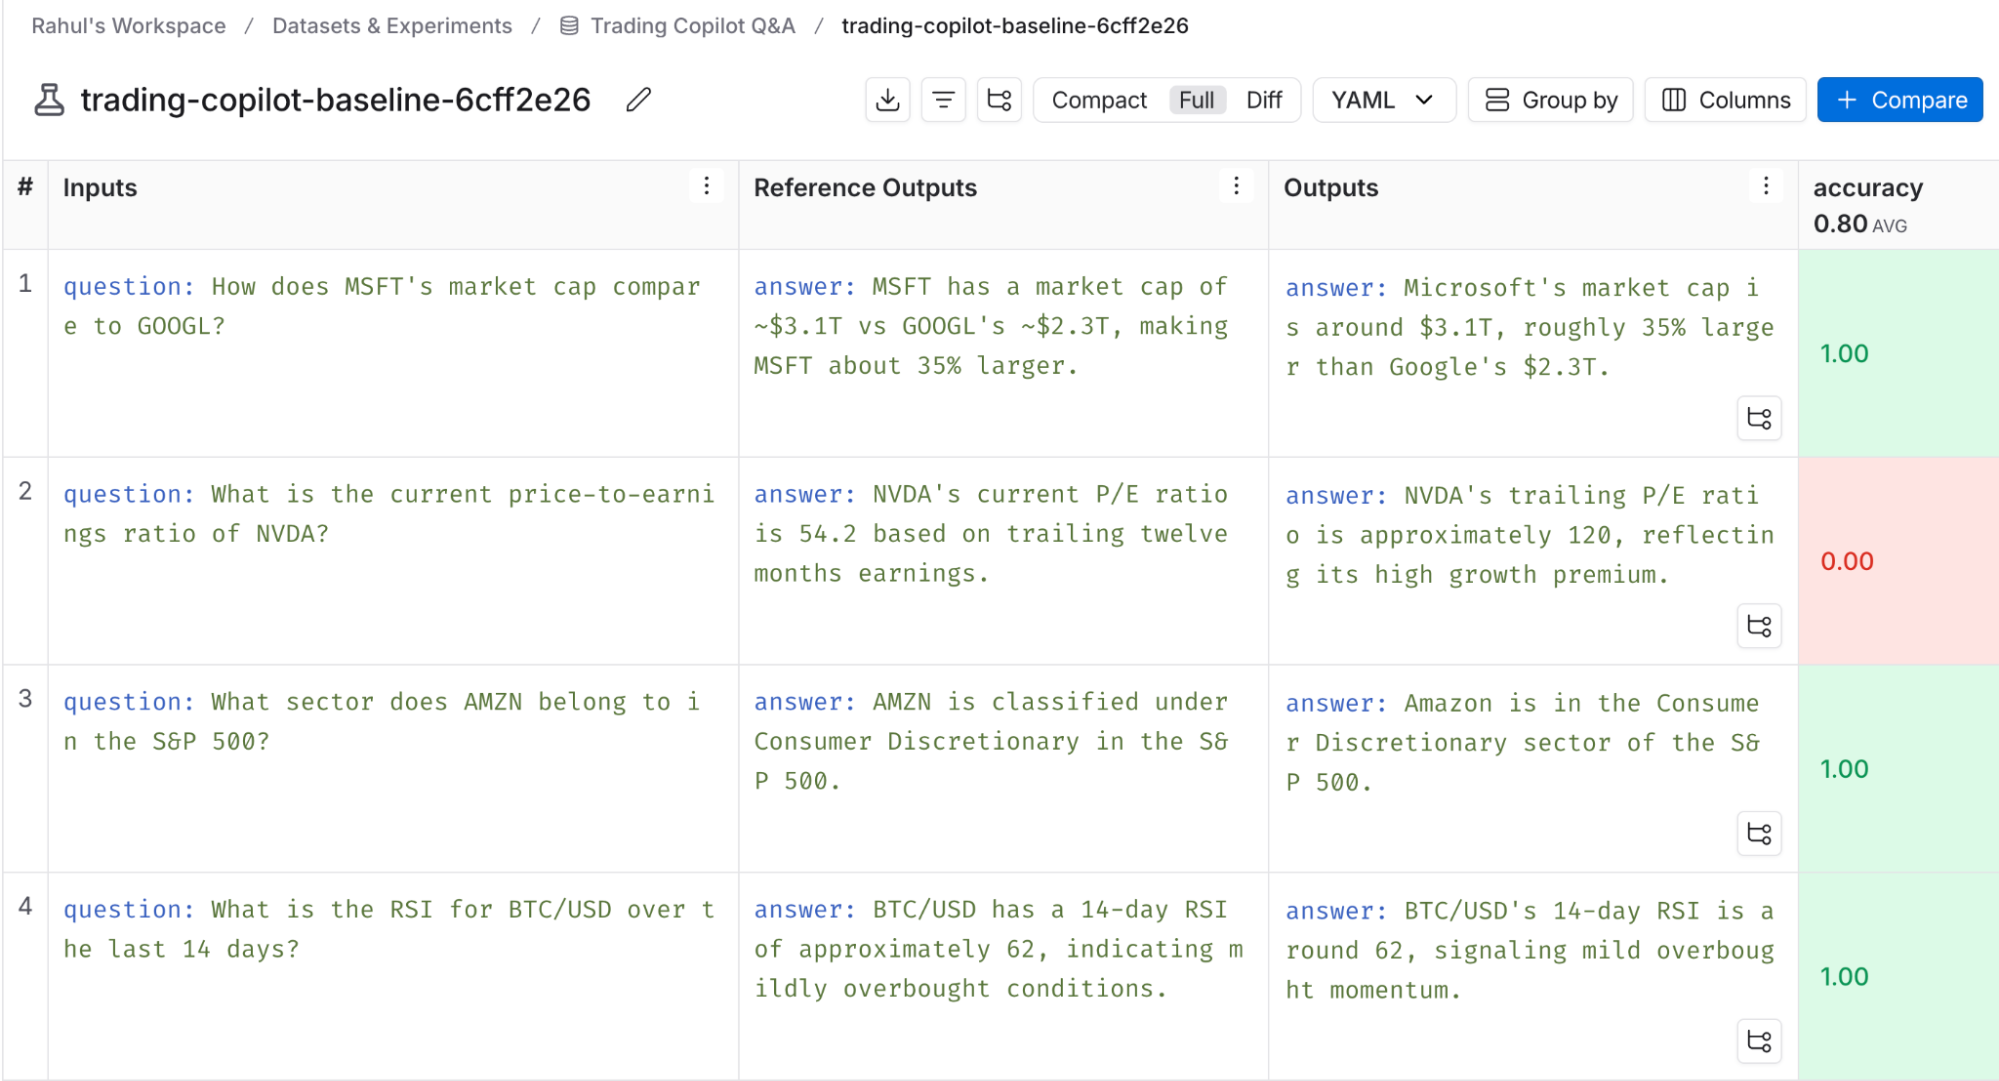
개발 시작 전에 적어도 작은 시나리오 세트와 기대 동작이 정의되어 있어야 한다는 게 글의 권고입니다. “이 입력이 들어오면 이 반응이 나와야 한다"는 시나리오 묶음이 곧 기준선이 됩니다. 이걸 데이터셋으로 만들고, 그 위에 평가를 붙입니다. 사양서가 곧 테스트가 되는 구조입니다.
배포 이후 — 운영 데이터를 자산으로
배포가 끝나면 진짜 게임이 시작됩니다. 자동 평가를 운영 트래픽 위에서 돌리되, 세 가지 장치를 같이 깔아 둡니다.
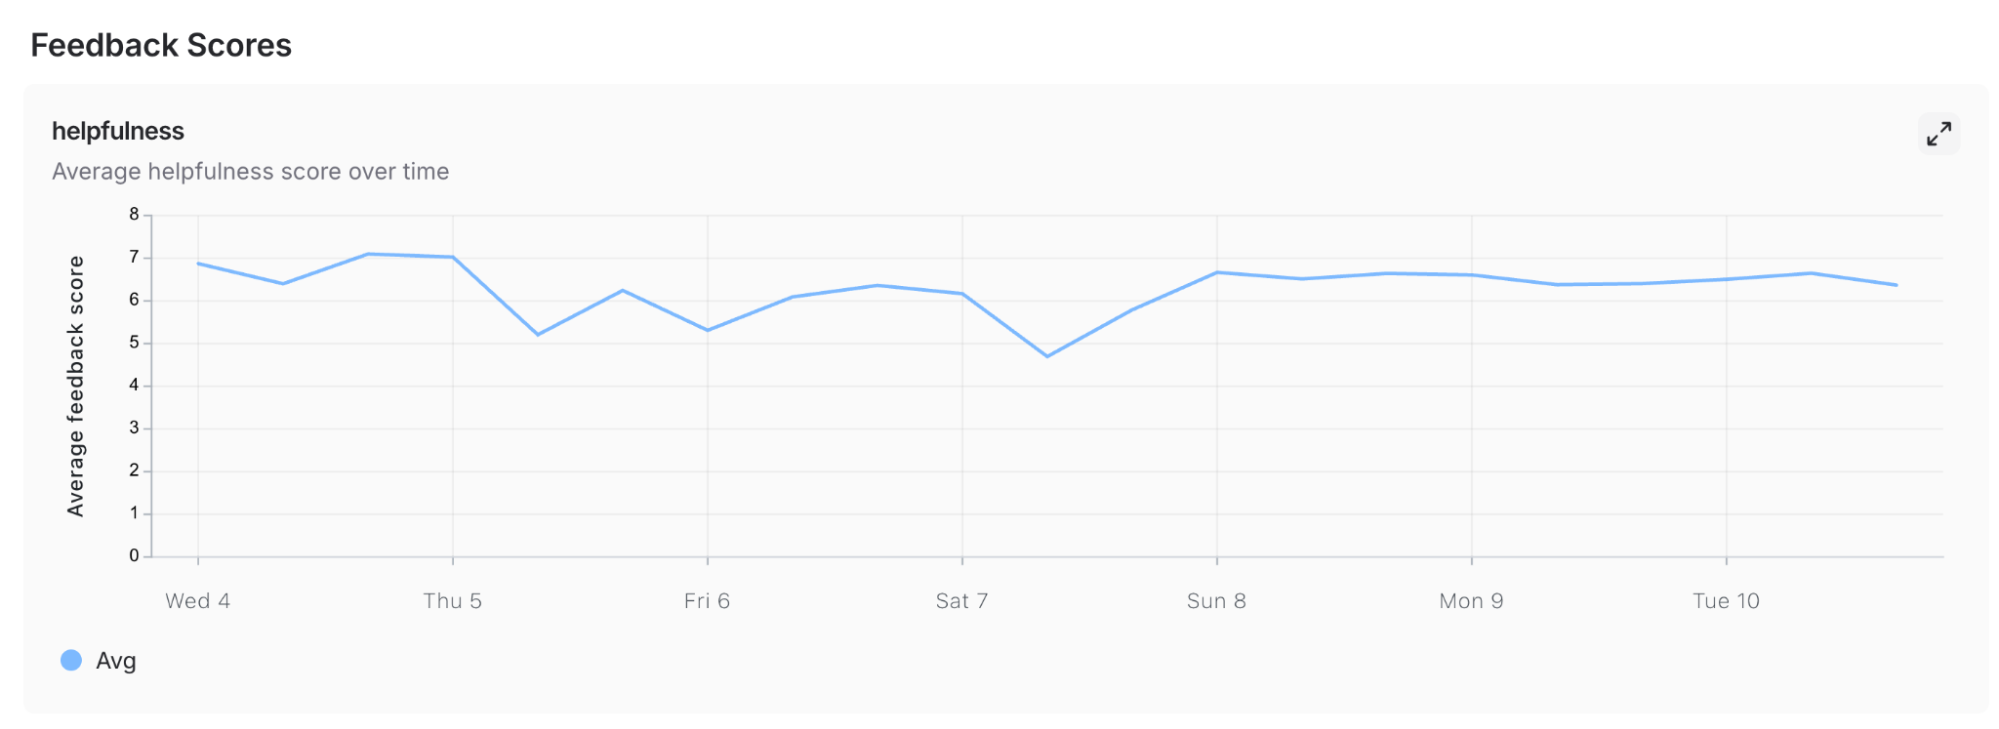
- 온라인 평가 — 매 트레이스마다 자동 평가자가 점수를 매깁니다.
- 알람 — 에러, 지연 급증, 부정 점수가 임계치를 넘으면 사람을 호출합니다.
- 어노테이션 큐 — 모호한 케이스를 도메인 전문가의 검토 대기열로 넘깁니다.
이 세 가지가 돌면 사람은 ‘봐야 할 것’만 보게 됩니다.
Insights Agent — 트레이스 더미에서 패턴 뽑기
정형화된 평가만으로는 새로 떠오르는 실패 양상을 못 잡습니다. LangSmith의 Insights Agent는 트레이스 데이터를 통째로 훑어서 반복되는 패턴과 트렌드를 끌어올립니다. 사람이 미처 정의해 두지 않았던 실패 유형을 발견하는 단계입니다. 여기서 새로 발견된 패턴이 다음 라운드의 평가자와 테스트 케이스로 들어갑니다.
골든 데이터셋 — 오늘의 운영 데이터를 내일의 테스트로
론칭 후에 얻을 수 있는 진짜 보물은 실제 사용자 입력입니다. 다만 그대로 쓰면 편향이 들어오니, 균형 잡힌 평가 세트로 큐레이션하는 단계에서 다시 한 번 사람의 판단이 들어갑니다. 그리고 에이전트가 잘 처리한 케이스만 모아 ‘골든 데이터셋’을 만들어 두면, 이게 회귀 테스트의 기준선이 됩니다. 새 버전이 이 데이터셋의 점수를 깎아내리면 그 자리에서 잡아내는 식입니다.
실무자가 볼 핵심 포인트
- 에이전트 개발 = 평가 자동화의 점진적 빌드. 처음부터 완벽한 평가자는 없습니다. 사람이 라벨링한 작은 데이터셋 → LLM-as-a-judge 캘리브레이션 → 운영 데이터로 확장의 순서가 자연스럽습니다.
- 결정론적 코드를 부끄러워하지 말 것. LLM이 자유롭게 풀어야 할 단계와, 코드로 박아야 할 단계를 처음부터 분리해 두면 운영 비용과 사고가 둘 다 줄어듭니다.
- 컨텍스트 큐레이션이 도구 추가보다 중요합니다. 에이전트에게 ‘무엇을 알게 할 것인가’가 종종 ‘무엇을 시킬 것인가’보다 결과를 더 많이 바꿉니다.
- 알람·어노테이션 큐가 없으면 운영 데이터는 그냥 로그입니다. 사람을 정확한 케이스로 부르는 장치가 있어야 운영이 학습으로 이어집니다.
- 골든 데이터셋은 한 번 만들고 끝나는 게 아닙니다. 신규 실패 유형이 잡힐 때마다 추가하고, 해결된 케이스는 회귀 방지용으로 남깁니다.
정리하면, LangChain이 말하는 그림은 한 줄로 줄여집니다. 사람이 판단의 기준을 정의하면, 자동 평가가 그 기준을 모든 트레이스에 매일 적용한다 — 그리고 운영 데이터가 다시 사람의 판단을 보강한다. 이 순환이 에이전트를 진짜로 좋아지게 만드는 플라이휠입니다.