개요
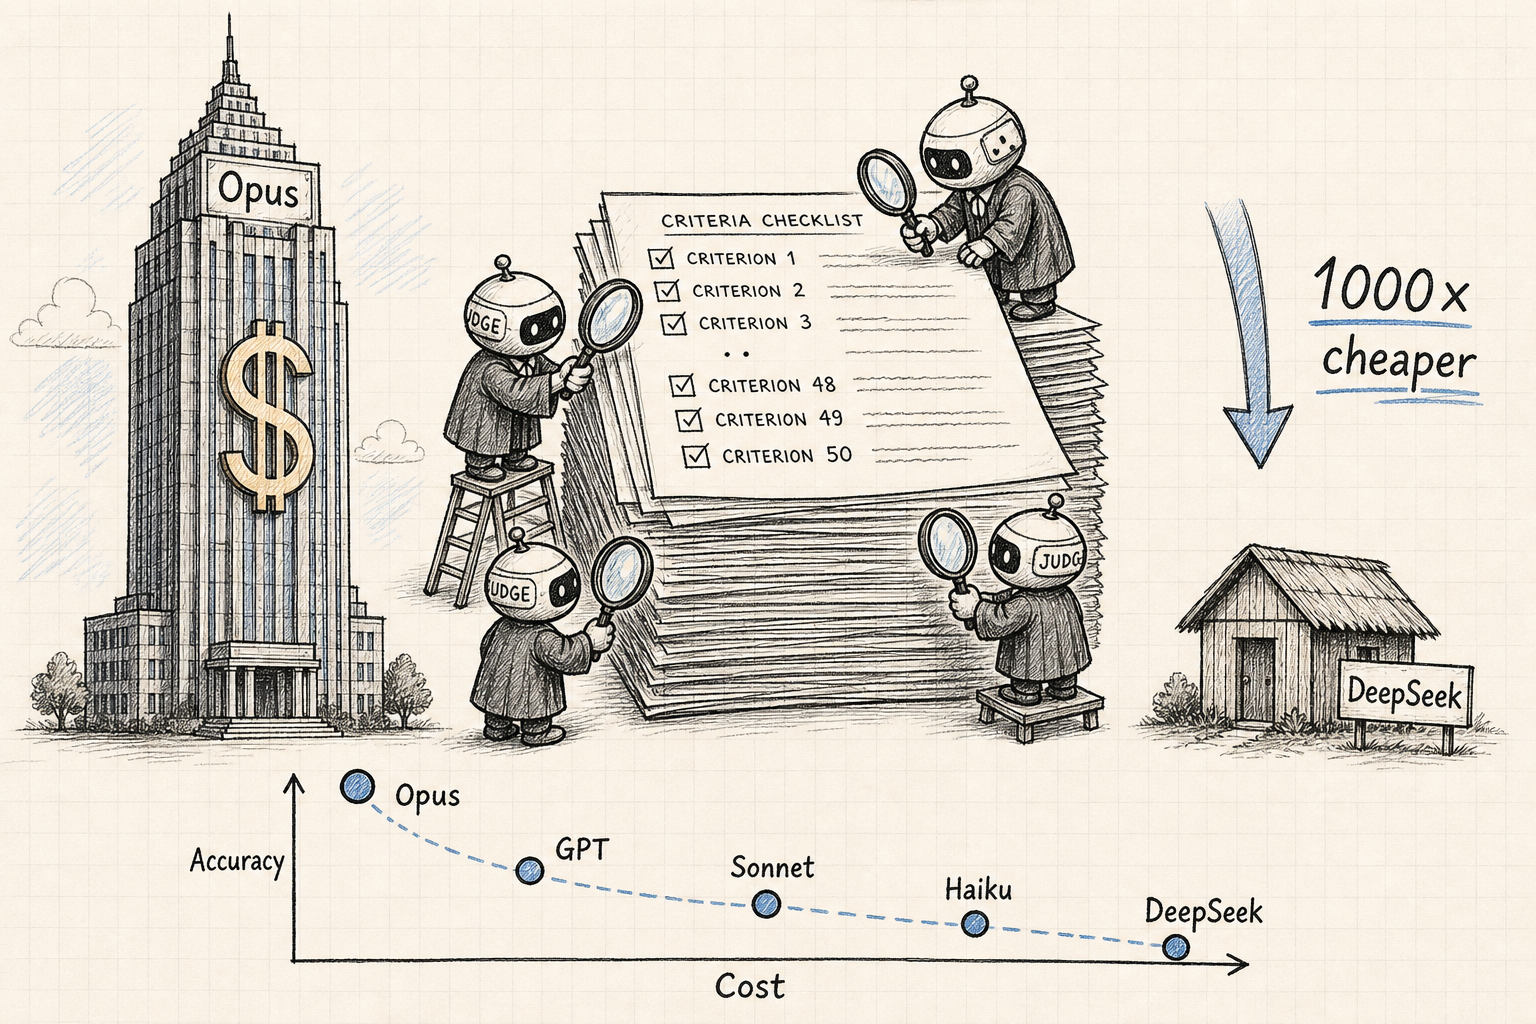
법률 에이전트의 답을 LLM 심판이 채점한다고 칩시다. 한 과제에 채점 기준이 50개가 넘으면, 그걸 다 GPT-5.5나 Opus 4.7로 한 줄씩 돌리는 순간 평가 비용이 학습 비용보다 더 큰 부담이 됩니다. LangChain Labs와 Harvey 팀이 이 병목을 정면으로 다뤘습니다. 결론부터 말하면, 묶음 채점과 오픈 모델을 같이 쓰면 같은 정확도 근방에서 비용이 한 자릿수까지 떨어집니다.
핵심 요약
- Harvey의 LAB 벤치마크 40개 과제, 2,348개 채점 항목으로 검증기 5종을 비교했습니다
- 항목별 호출(per-criterion) 대신 한 번에 전체 루브릭을 묶어 채점(batch)하면 같은 모델로도 비용이 약 10배 떨어집니다
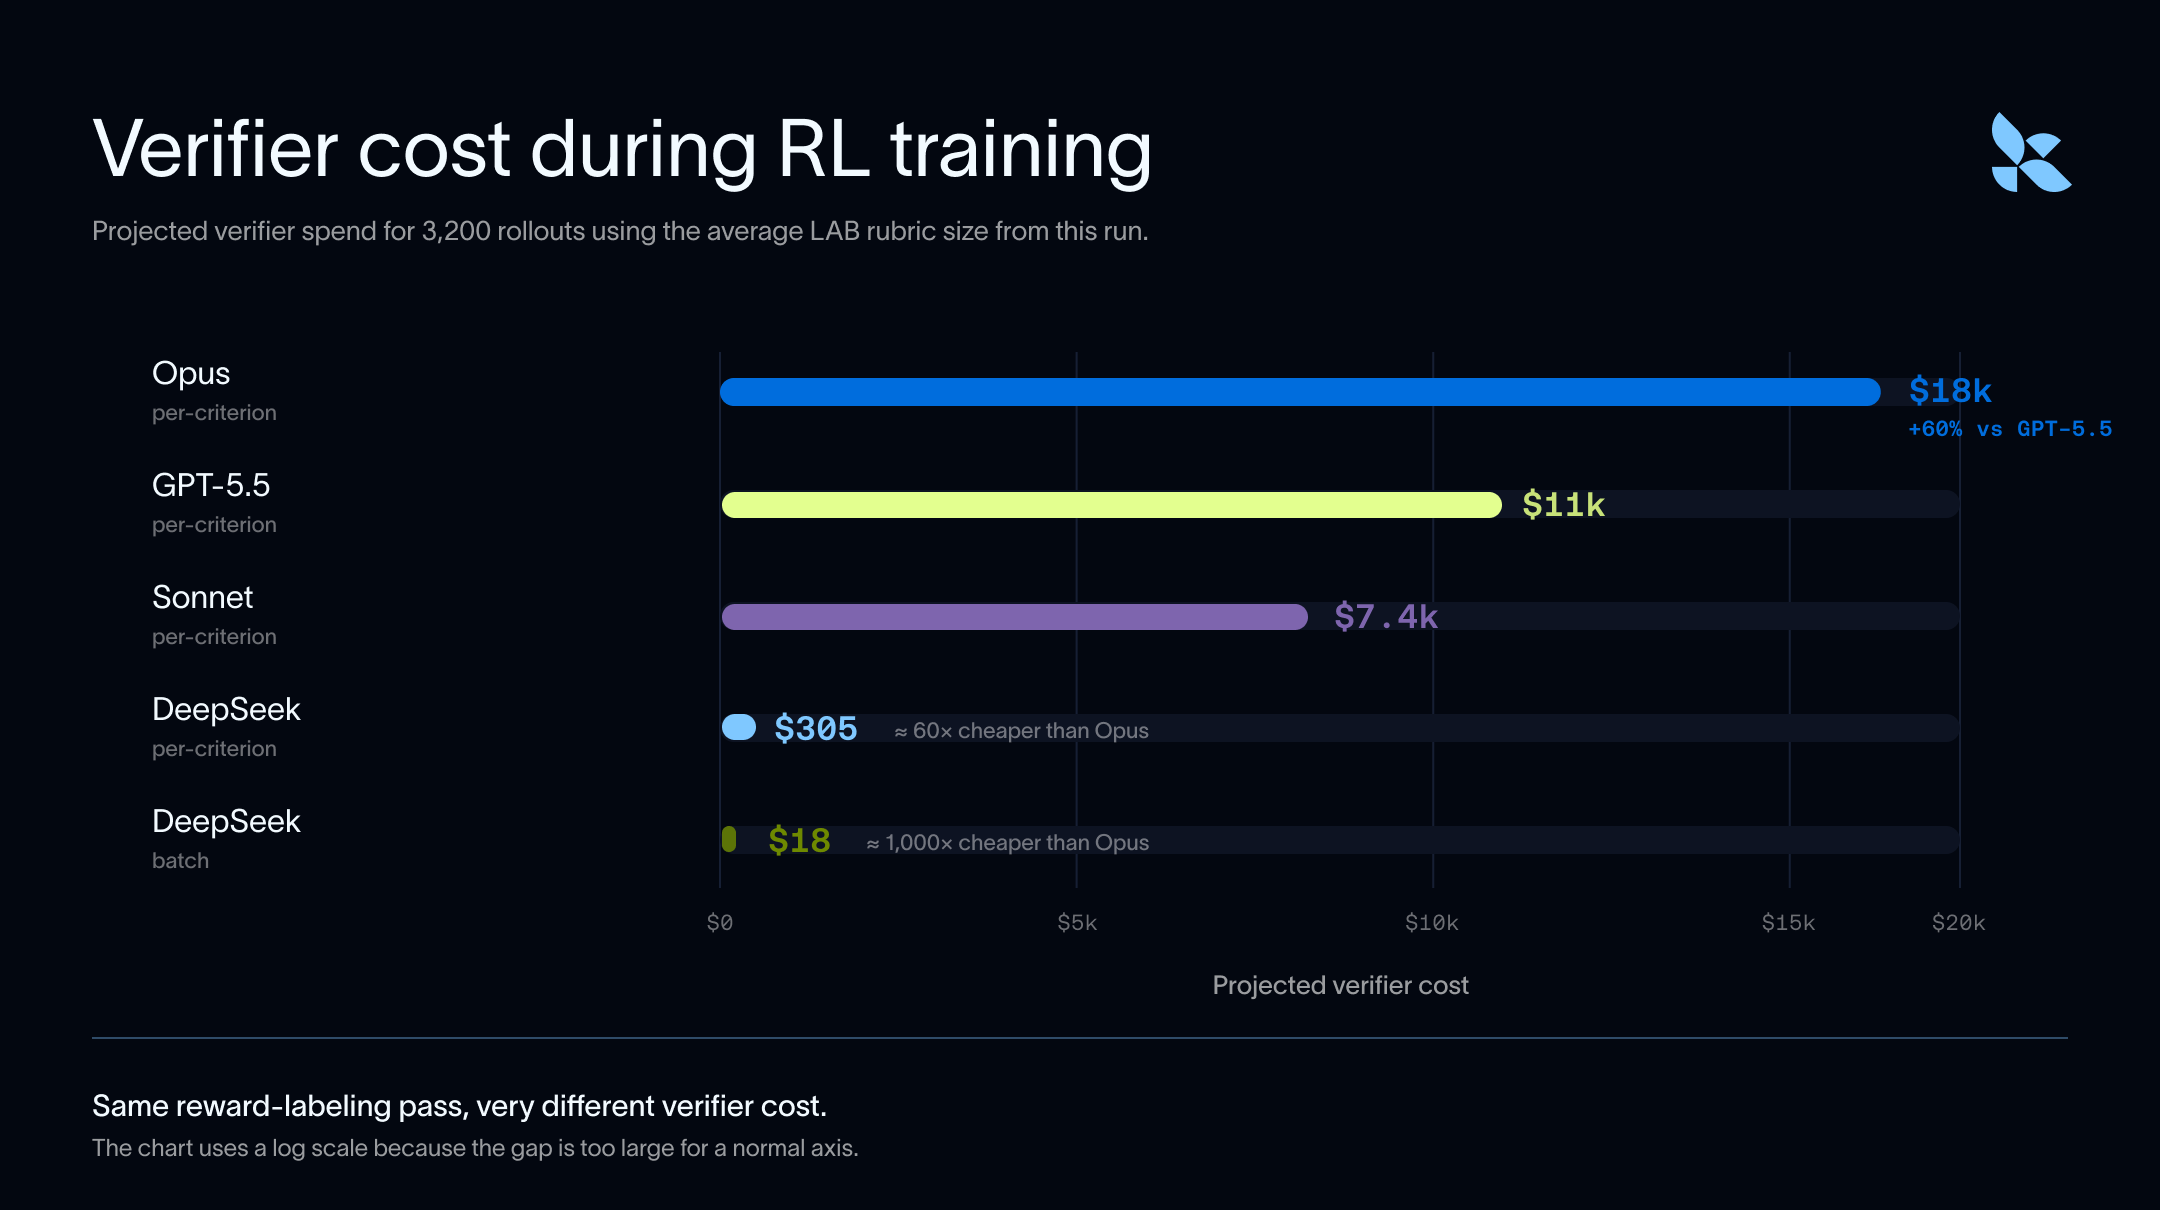
- DeepSeek V4 Flash는 Opus 4.7 수준의 정확도를 유지하면서도 비용이 3자릿수(약 1,000배) 더 쌉니다
- Haiku 4.5는 너무 너그러워서(false-pass 48.4%) 법률 검증에는 부적합합니다
- 프롬프트만 손봐도 DeepSeek의 false-pass가 10.7% → 9.5%로 줄었습니다
왜 법률 검증이 어려운가
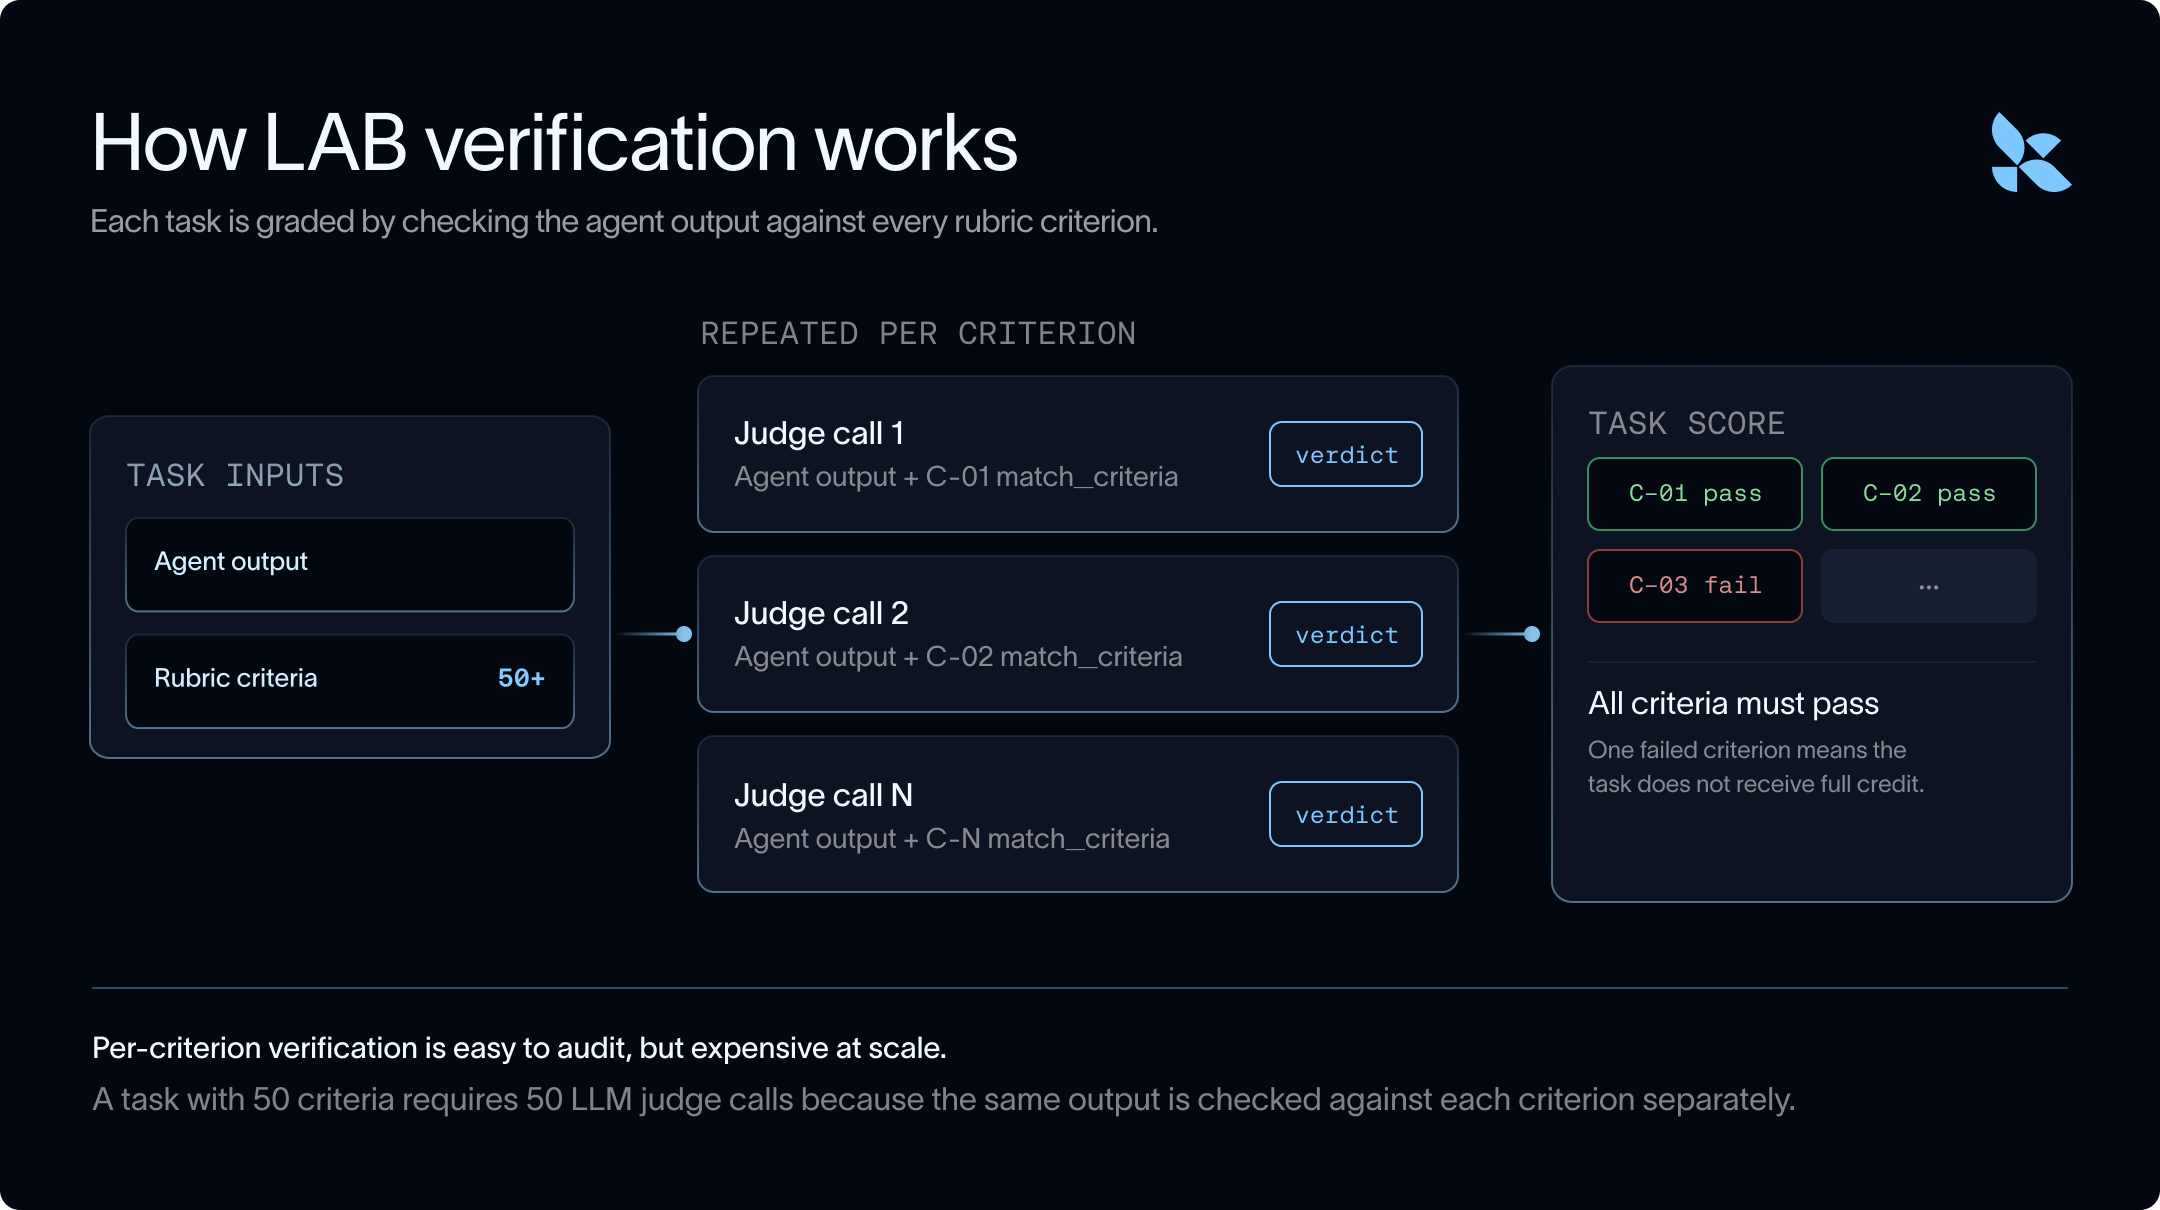
법률 업무는 에이전트한테 가장 까다로운 영역에 속합니다. 컨텍스트를 빠르게 채우는 긴 문서가 많고, 전문 지식이 필요하며, 결과물 하나가 통과하려면 까다로운 기준을 전부 만족해야 합니다. Harvey가 공개한 LAB 벤치마크는 사람 리뷰어가 일하는 방식 그대로, 과제마다 합격해야 할 기준 리스트를 두고 모든 기준을 LLM 심판이 각자 채점합니다.
문제는 비용입니다. 한 과제에 50개 넘는 기준이 흔하고, 각 기준마다 프론티어 모델을 호출하면 평가 한 번이 학습 비용을 압도할 수도 있습니다. RL 후속학습(post-training)으로 넘어가면 같은 과제를 여러 번 굴려야 하니 비용은 더 커집니다.
두 가지 길 — 토큰을 줄이거나, 더 싼 토큰을 쓰거나
LangChain Labs와 Harvey가 검토한 방향은 단순합니다.
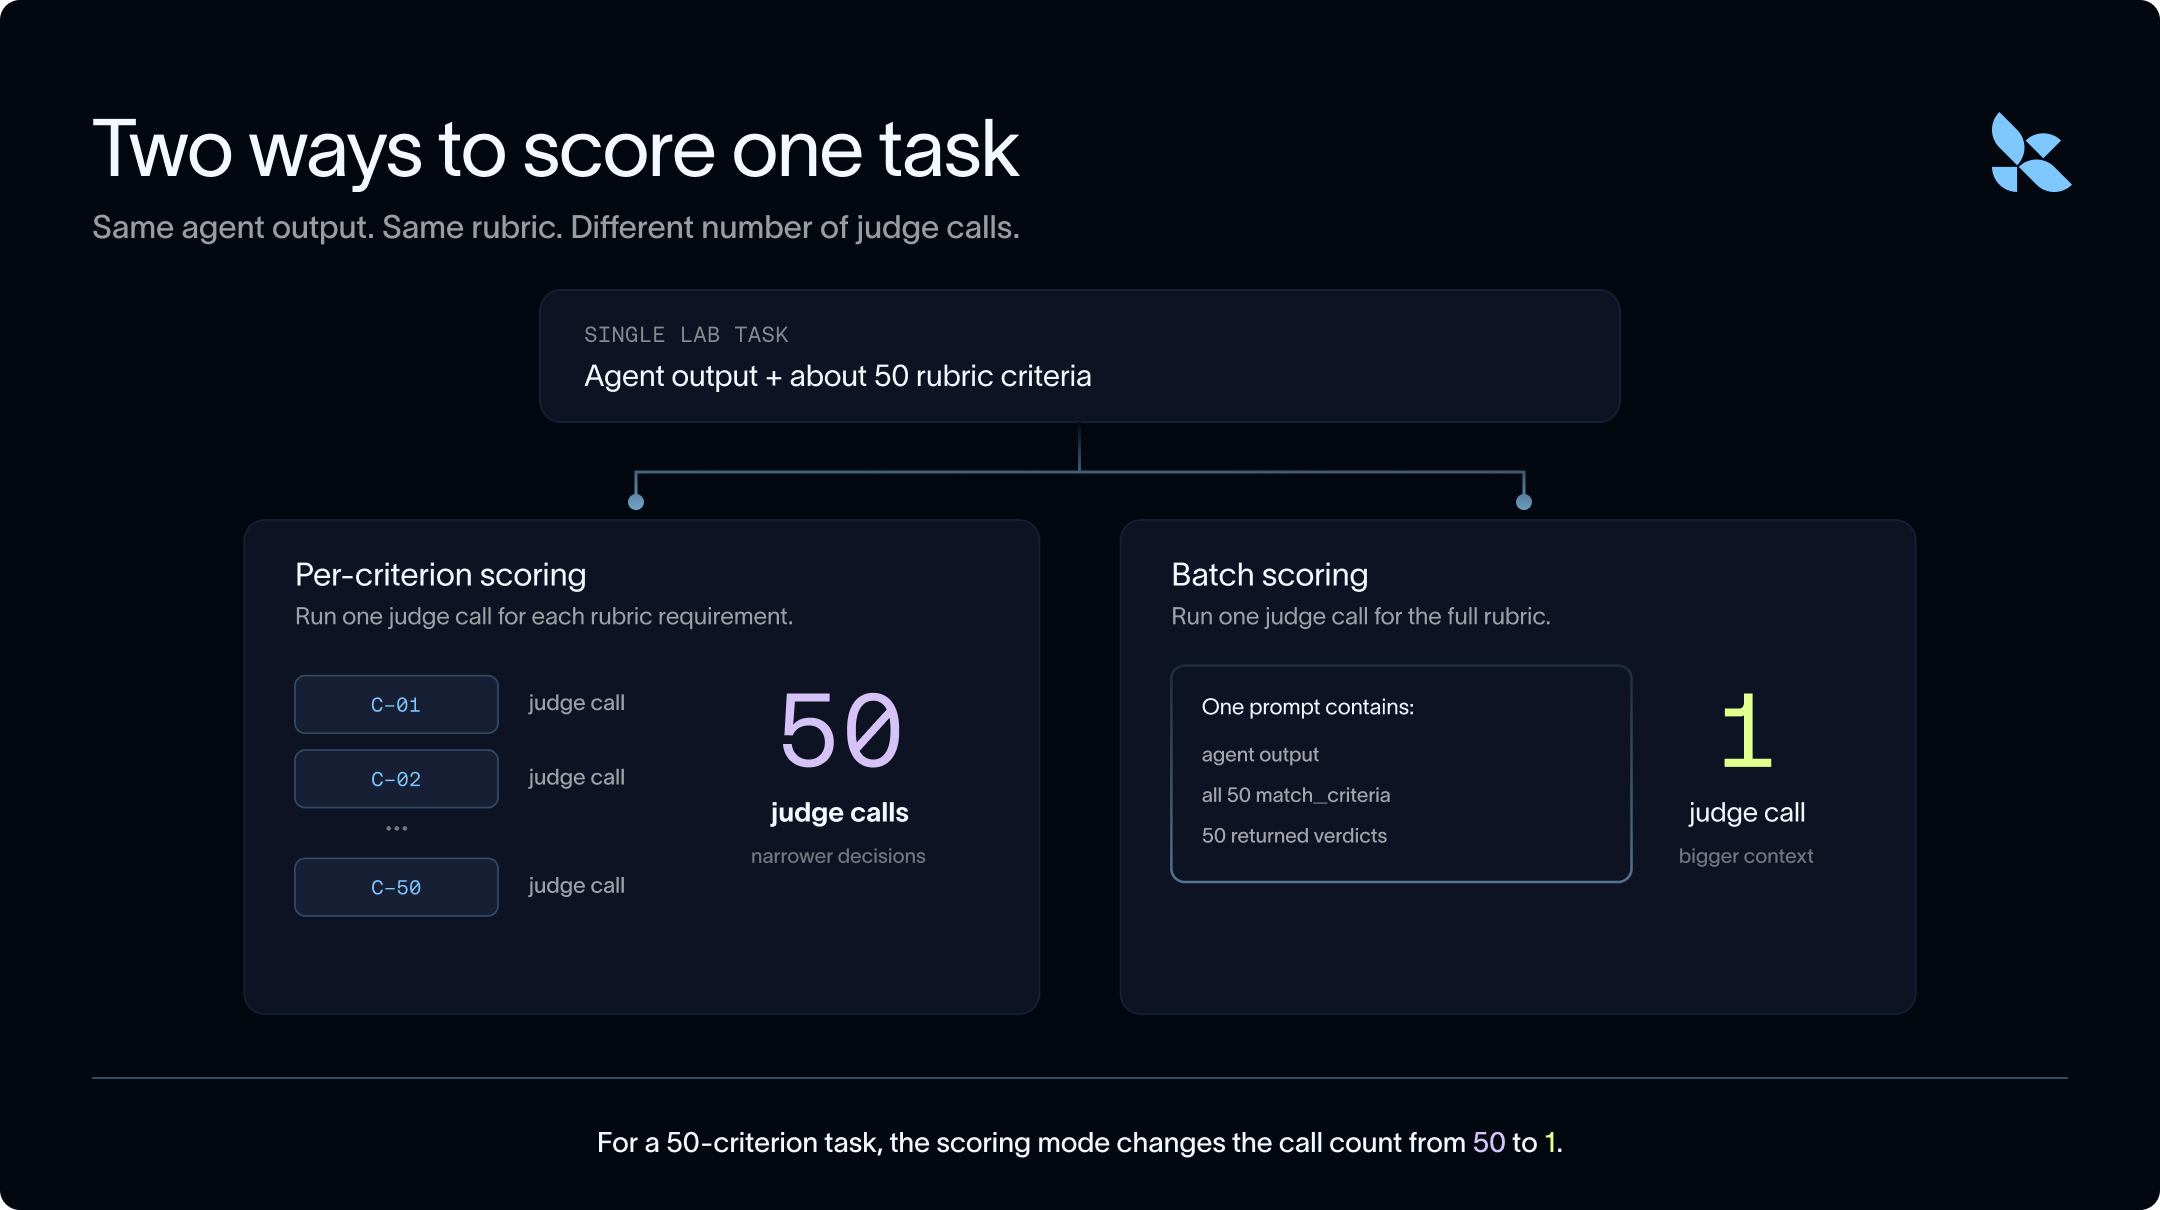
- 토큰 수를 줄인다 — 기준 하나당 호출하지 말고, 전체 루브릭을 한 번에 던져 한 호출로 모든 항목을 판정한다(batch).
- 토큰 단가를 낮춘다 — Opus 4.7을 기준선으로 두고, GPT-5.5·Sonnet 4.6·Haiku 4.5·DeepSeek V4 Flash를 같은 데이터로 비교한다.
실험 설정
평가 대상이 될 에이전트 출력은 Kimi K2.6 기반 에이전트로 만들었습니다. M&A·세무·VC·신탁/상속 등 4개 분야에서 LAB 공개 과제 40개를 풀게 했고, 그 결과 2,348개의 합격/불합격 채점 항목이 만들어졌습니다.
각 검증기를 굴리면서 다음 네 가지를 잰 게 핵심입니다.
- 합치율(Agreement) — Opus 라벨과 얼마나 같이 가는가
- 잘못된 합격(False pass) — Opus가 떨어뜨린 항목을 통과시키는 비율
- 잘못된 불합격(False fail) — Opus가 통과시킨 항목을 떨어뜨리는 비율
- 비용(Cost) — 40개 과제 채점에 든 실제 토큰 비용
법률 도메인에서는 잘못된 불합격보다 잘못된 합격이 훨씬 위험합니다. 떨어진 건 다시 사람이 들여다보면 되지만, 통과시켜버린 잘못된 결과는 그대로 흘러가니까요. 그래서 false-pass 지표를 가장 무겁게 봤습니다.
결과 — 비용은 떨어지는데 정확도는 어디까지 버티나
같은 모델이라도 항목별 호출에서 묶음 호출로 바꾸면 합치율은 조금 떨어지지만 비용은 약 10배 줄어듭니다. 입력 토큰이 반복되지 않기 때문입니다.
흥미로운 사실 하나. **GPT-5.5와 Opus 4.7끼리도 합치율이 95.7%**입니다. 프론티어 모델 두 개가 4–5%는 서로 다르게 채점한다는 뜻이고, 일부 항목은 사람도 일관되게 매기기 어려울 만큼 정의가 모호하다는 신호이기도 합니다. 100% 합치를 노리는 게 비현실적일 수 있다는 얘기입니다.
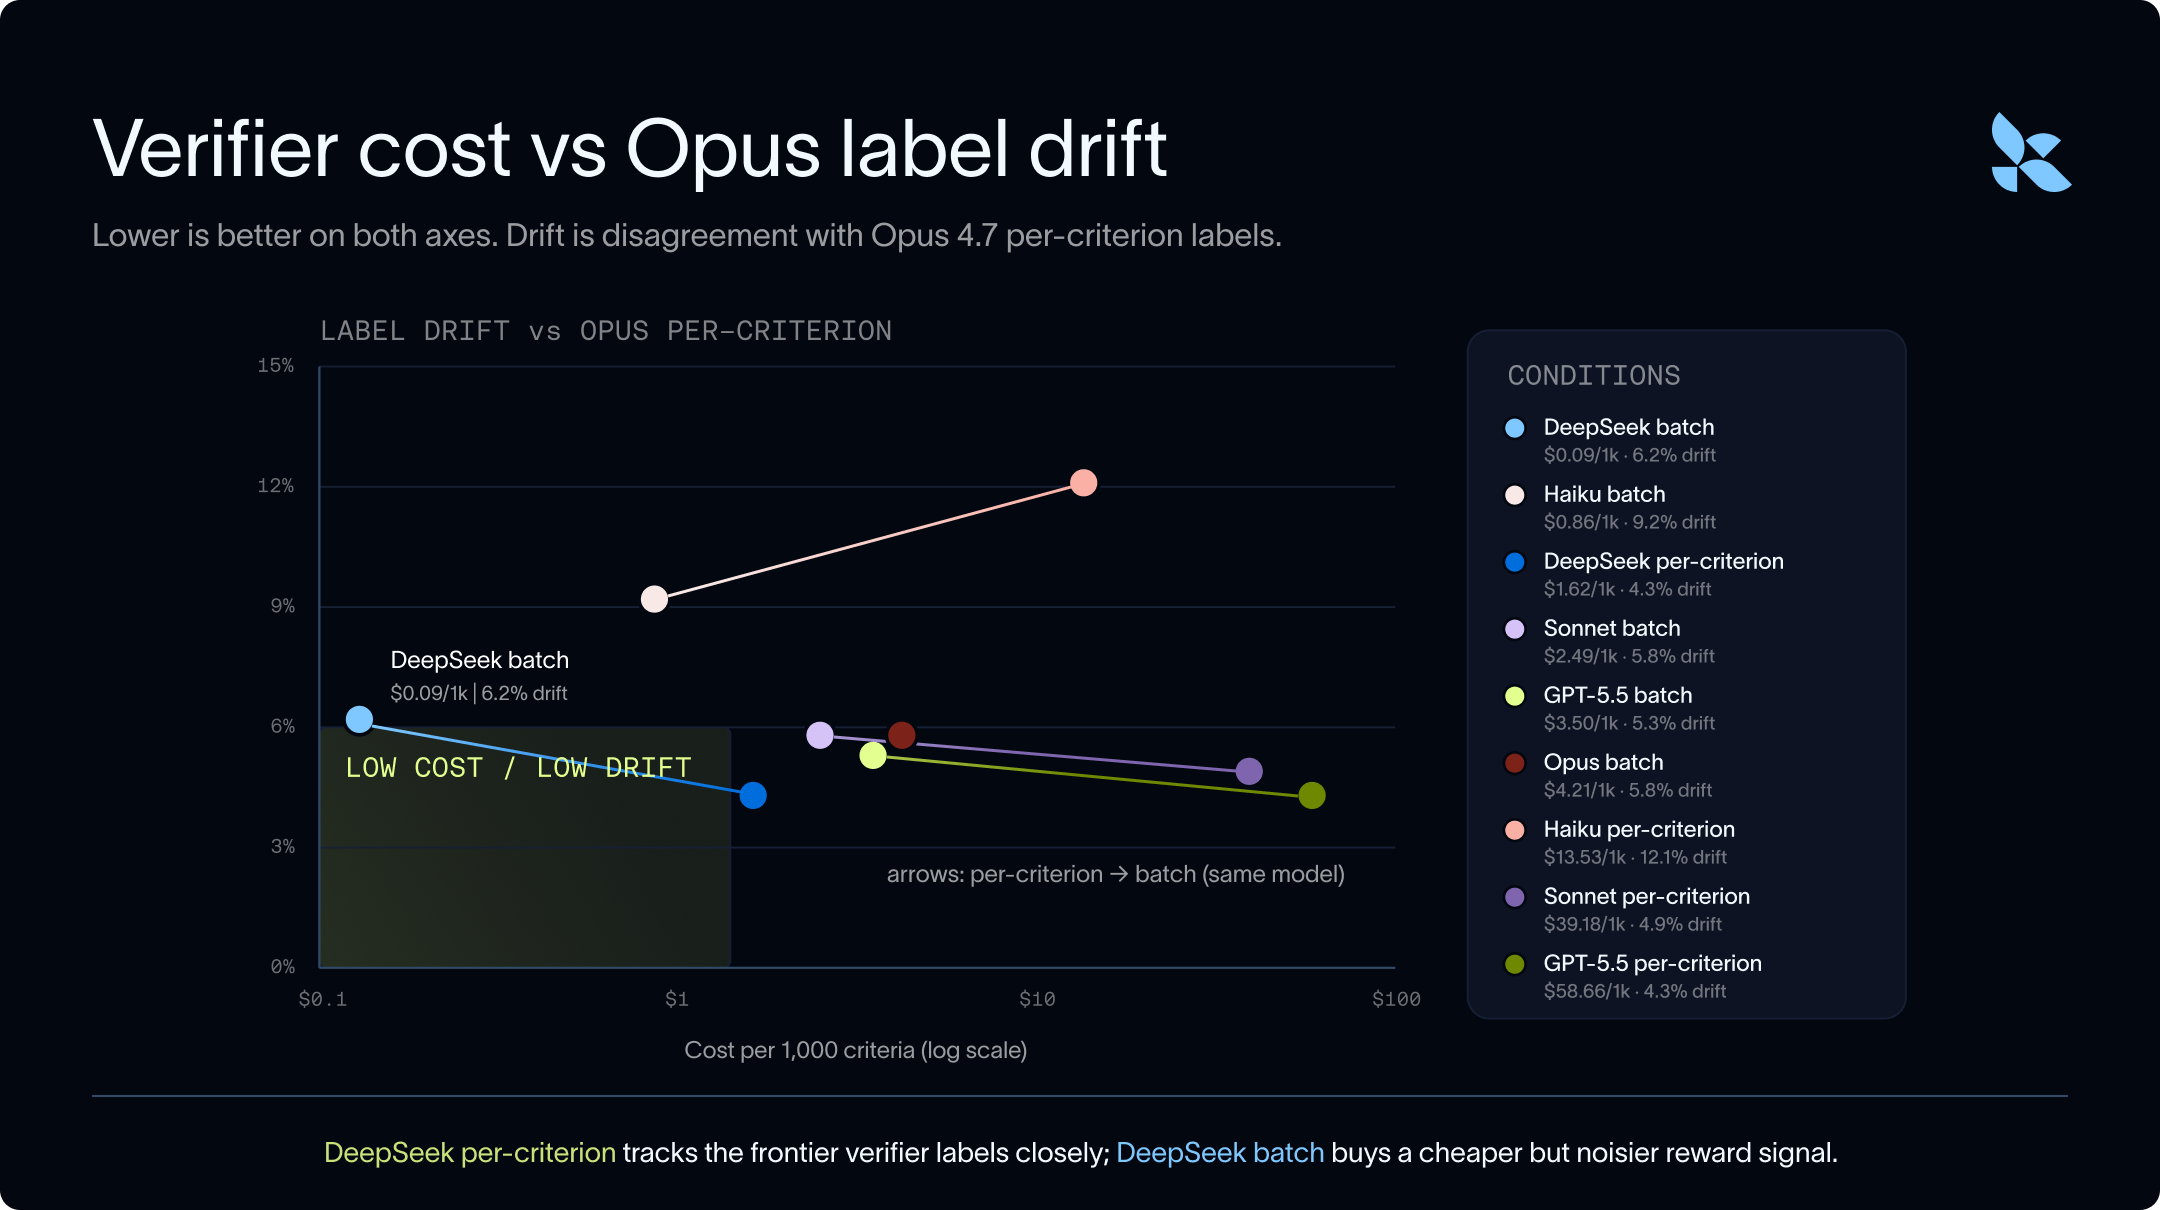
차트를 보면 핵심이 한눈에 잡힙니다.
- DeepSeek V4 Flash가 항목별·묶음 양쪽 모두에서 Opus 근사치를 잘 따라갑니다. 그러면서 비용은 약 1,000배 더 쌉니다.
- Haiku 4.5는 싸긴 한데 너무 관대했습니다. false-pass가 항목별 48.4%, 묶음 34.7%. 법률 검증에서 절반 가까운 잘못된 합격은 받아들이기 어렵습니다.
- 묶음 채점은 거의 모든 모델에서 합치율이 살짝 깎이지만, 비용 곡선을 한 자릿수 옮긴다는 점이 큰 이점입니다.
RL 후속학습에서는 차이가 더 커진다
검증기는 평가용만이 아닙니다. RL 후속학습에서는 보상 신호로 쓰입니다. 과제 하나당 롤아웃을 여러 번 굴리니 검증 비용이 그대로 곱해집니다. 같은 1만 회 실험을 돌릴 때 Opus 기준 대비 DeepSeek은 60–1,000배 저렴하게 들어가고, 이 차이는 곧 “실험을 시도해볼 수 있느냐 없느냐"의 문제로 이어집니다.
프롬프트만 손봐도 false-pass가 줄었다
마지막 실험은 프롬프트 튜닝입니다. DeepSeek이 Opus와 어긋난 사례들을 자동 분석 루프로 돌려보니, “기준과 관련은 있지만 모든 세부 항목을 만족시키지는 못한” 답을 너그럽게 통과시키는 경향이 보였습니다.
대응책은 단순합니다. 프롬프트에서 기준을 체크리스트로 잘게 쪼개도록 강제하고, 정보가 명확하지 않을 때는 보수적으로 판정하라고 지시했습니다.
| 모드 | 기존 프롬프트 | 튜닝 후 |
|---|---|---|
| 항목별 | 10.7% | 9.5% |
| 묶음 | 15.6% | 14.2% |
큰 폭은 아니지만, 모델을 바꾸지 않고 프롬프트만으로 false-pass를 깎을 수 있다는 점이 의미가 큽니다. 트레이스에서 실패 패턴을 뽑아 프롬프트로 되돌려 넣는 방식, 검증기뿐 아니라 에이전트 일반에도 통하는 전략입니다.
실무자가 볼 핵심 포인트
- 루브릭 채점은 묶음부터 시도해 보세요. 같은 모델로 비용이 한 자릿수 떨어집니다. 합치율 손실이 받아들일 만한지 도메인 기준으로 판단하면 됩니다.
- 오픈 모델을 검증기 후보에서 빼지 마세요. DeepSeek 같은 모델이 Opus 근사치를 내면서 1,000배 싸게 굴러갑니다. 대규모 평가나 RL 학습에서는 이게 곧 실험 가능 여부를 가릅니다.
- 싸다고 다 좋은 건 아닙니다. Haiku처럼 false-pass가 폭발하는 모델은 법률·의료·금융 같은 고위험 도메인에서는 부적합합니다. 합치율이 아니라 false-pass·false-fail로 의사결정하세요.
- 프론티어 모델끼리도 4–5% 어긋납니다. 검증기 평가의 천장이 100%가 아니라 95% 부근이라는 점을 인정하고, 사람 라벨러와 동일한 수준의 모호성을 기대하지 마세요.
- 프롬프트는 무료로 쓸 수 있는 가장 강한 손잡이입니다. 트레이스에서 어긋난 케이스를 뽑아, 체크리스트화·보수적 판정 지침으로 되돌리는 짧은 루프를 한 번만 돌려도 false-pass가 줄어듭니다.
원문 출처
원문 보기 — LangChain Labs × Harvey 공동 연구, 2026-06-02