개요
긴 컨텍스트 LLM을 직접 돌려본 사람이면 다 압니다. GPU가 노는데도 토큰은 느리게 나옵니다. 범인은 연산이 아니라 KV 캐시입니다. 시퀀스가 길어질수록 캐시가 선형으로 부풀어, 매 토큰마다 그 큰 덩어리를 HBM으로 다시 끌어와야 합니다. 메모리 대역폭이 천장을 치는 순간 디코딩 속도가 무너집니다.
2026년 상반기에 이 문제에 대한 답이 한꺼번에 셋이나 나왔습니다. TurboQuant(구글·NYU, ICLR 2026), OSCAR(Together AI), EpiCache(애플)입니다. 셋 다 KV 캐시를 줄이지만, 노리는 지점이 다 다릅니다. 어느 하나가 정답이 아니라 서로 보완하는 도구입니다.
핵심 요약
- TurboQuant: 데이터·캘리브레이션 없이 모든 모델에 그대로 꽂히는 양자화. 3~4비트 구간에서 거의 무손실. 정보이론 하한의 약 2.7배 안에 든다는 이론적 보장이 있습니다.
- OSCAR: 캘리브레이션을 받아 INT2까지 밀어붙인 프로덕션 지향 방식. 100K 컨텍스트에서 작업 처리량 최대 7.83배, KV 메모리 약 8배 절감. SGLang에 통합된 Triton 커널까지 같이 옵니다.
- EpiCache: 다중 턴 대화에서 누적되는 히스토리를 에피소드 단위로 잘라 따로 관리. 4~6배 압축 구간에서 풀 캐시 수준 정확도, 최대 40% 더 높은 정확도를 보고합니다.
- 세 방식은 경쟁이 아니라 조합입니다. EpiCache 위에 OSCAR나 TurboQuant를 얹으면 절감 효과가 곱으로 붙습니다.
- 공통의 적은 outlier 채널입니다. 소수의 큰 채널이 양자화 범위를 잡아먹기 때문에, 단순 INT2는 거의 항상 무너집니다.
왜 KV 캐시가 병목인가
트랜스포머는 디코딩할 때 매 레이어에서 키·밸류 벡터를 캐시에 쌓아둡니다. 같은 토큰을 다시 계산하지 않으려는 정상적인 최적화입니다. 다만 그 캐시가 시퀀스 길이와 배치 크기에 비례해 선형으로 커집니다.
수치를 보면 체감이 됩니다. Llama-3.1-70B를 BF16으로 돌릴 때 토큰 하나당 KV가 약 0.31MB입니다. 128K 토큰이면 40GB, 1M 토큰이면 300GB가 넘습니다. 모델 가중치 자체가 140GB인데 캐시가 그걸 추월하는 셈입니다.
문제는 거기서 끝나지 않습니다. 매 새 토큰을 뽑을 때마다 이 캐시 전체를 HBM에서 다시 스트리밍해야 합니다. 연산은 충분한데 메모리 대역폭이 못 따라가니, 디코딩은 GPU의 코어가 아니라 메모리 칩이 결정합니다.
기존에도 답을 찾아보긴 했습니다. H2O·SnapKV 같은 토큰 제거, KIVI·GEAR 같은 양자화, Palu의 저랭크 투영, KVMerger의 병합, MLA 같은 아키텍처 차원의 공유. 그중 KIVI가 기준선처럼 자리잡았습니다. 키는 토큰마다 같은 자리에 outlier가 박힌다는 점을 활용해 채널별로, 값은 토큰별로 2비트 양자화를 합니다. 캘리브레이션 없이 약 2.6배 메모리 절감.
세 신예는 여기서 한 발씩 더 나갑니다.
TurboQuant — 캘리브레이션 없이, 어디든 그대로
TurboQuant의 매력은 단순합니다. 데이터를 안 봅니다. 모델을 받으면 그 자리에서 바로 돌릴 수 있습니다.
두 단계로 돕니다. 첫째, 키·값 벡터에 무작위 회전을 걸어 좌표들을 거의 독립적이고 가우시안에 가까운 분포로 만듭니다. outlier가 만든 한쪽 쏠림이 풀립니다. 둘째, 그 위에 Lloyd-Max로 미리 계산된 최적 스칼라 양자화기를 좌표마다 똑같이 적용합니다. 잔차에 대해서는 1비트짜리 양자화 Johnson-Lindenstrauss 변환을 한 번 더 얹습니다.
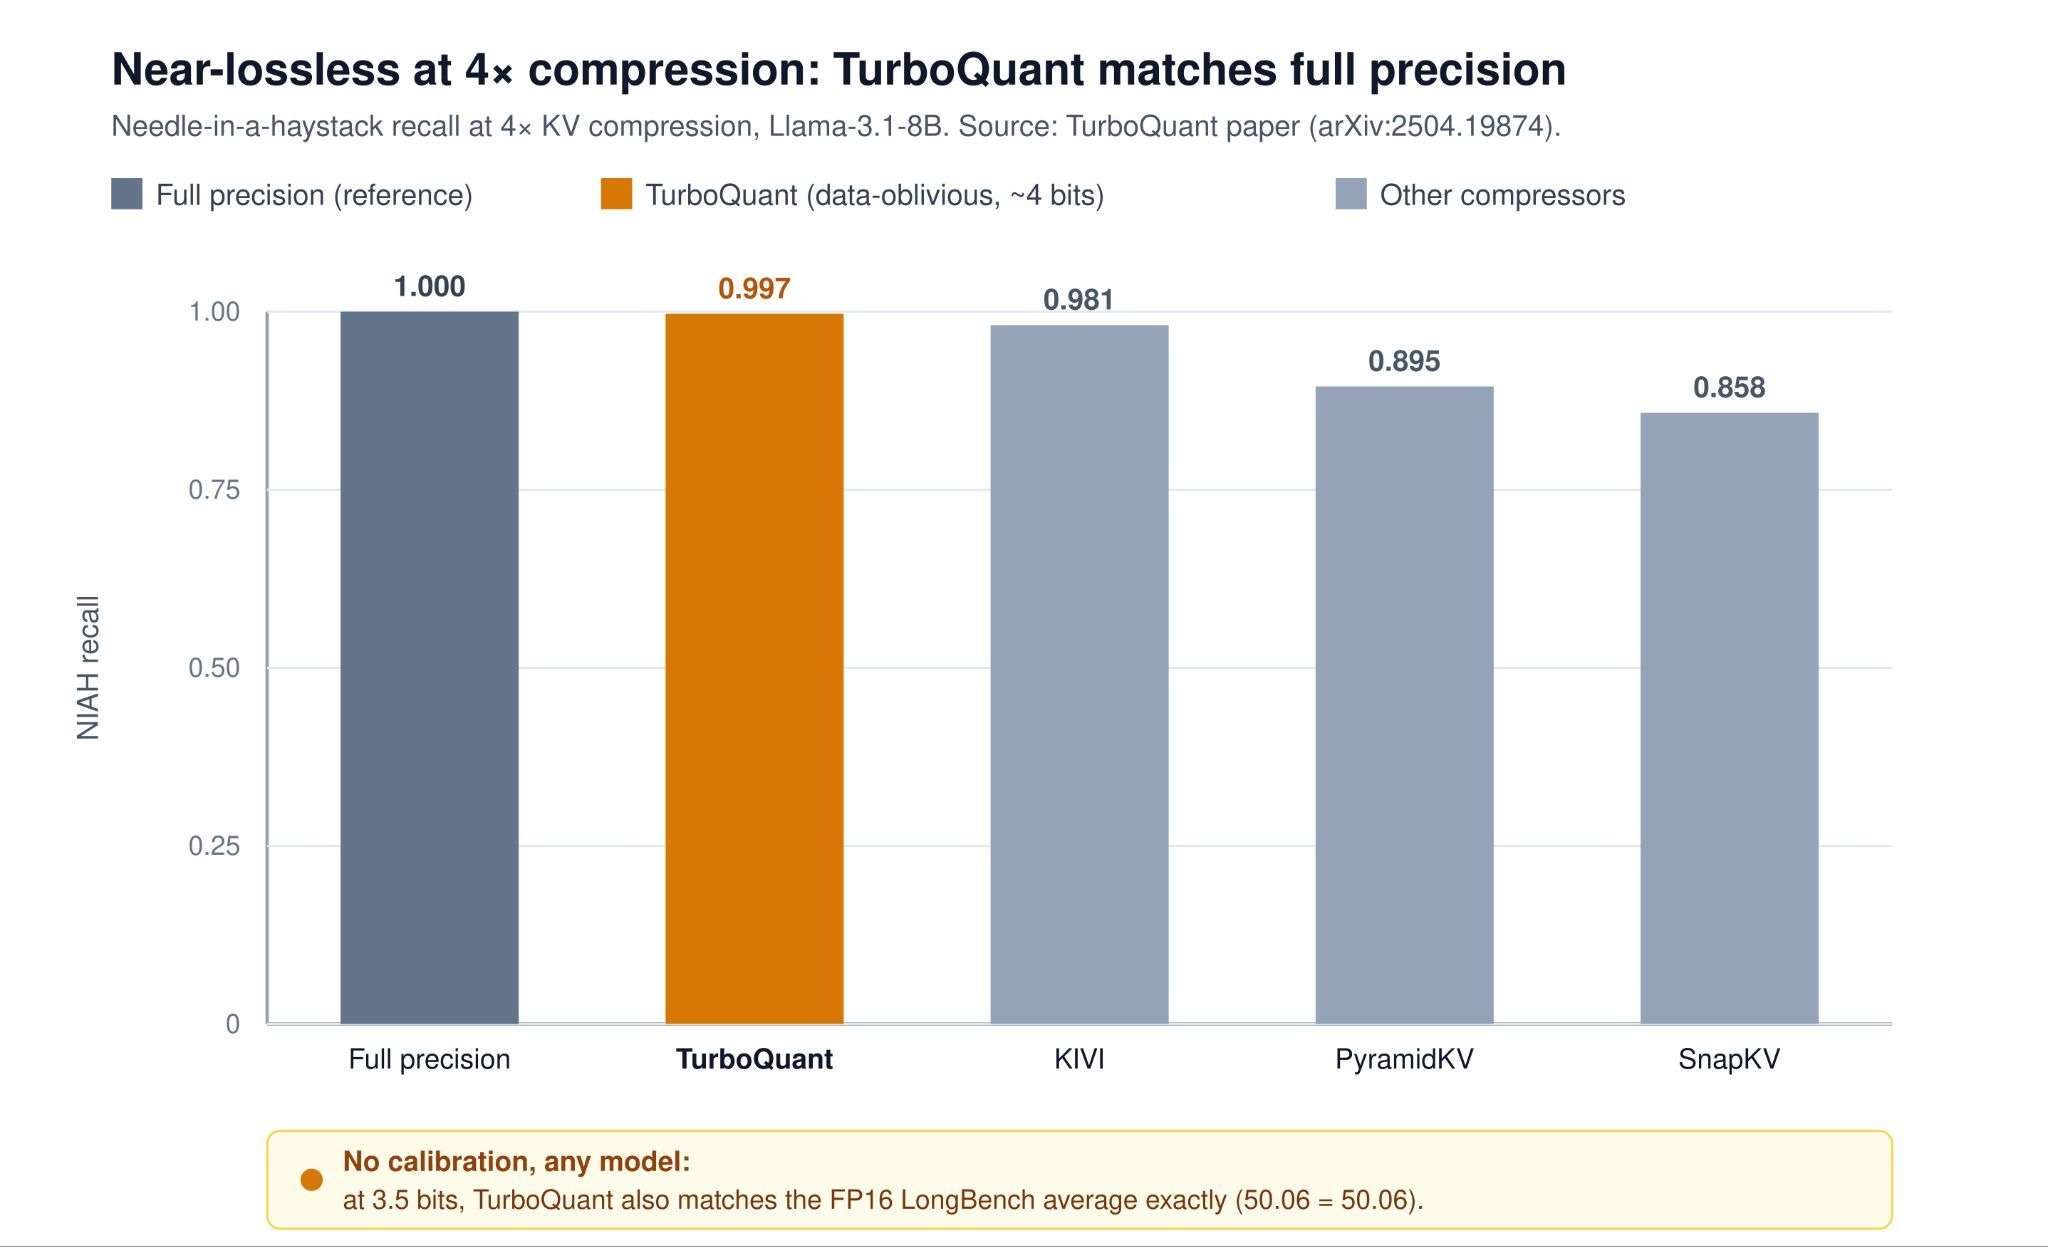
수치보다 흥미로운 건 이론적 보장입니다. 정보이론 한계 대비 약 2.7배 안에 들어간다는 증명이 같이 옵니다. 실제 결과도 4배 압축 구간에서 Needle-in-a-Haystack 회수율이 사실상 풀 정밀도 수준. 3.5비트면 품질 변화가 거의 없고, 2.5비트로 내려가도 미세한 감소만 보입니다.
주의할 게 하나 있습니다. 종종 인용되는 “H100에서 어텐션 8배 빠름"이라는 수치는 논문이 아니라 구글 블로그에서 나온 말이고, 한정된 마이크로벤치 결과입니다. 실전 스위트스폿은 그래서 3~4비트 구간입니다. 캘리브레이션 데이터를 못 모으는 상황, 모델이 자주 바뀌는 환경, 그리고 벡터 DB까지 한 번에 손보고 싶을 때 강력합니다.
OSCAR — INT2를 실전으로 끌어내린 캘리브레이션 회전
OSCAR의 출발점은 솔직합니다. INT2는 양자화 단계가 네 개뿐이라, 데이터를 보지 않는 회전은 못 버틴다. 그래서 OSCAR는 오프라인 캘리브레이션으로 어텐션 인식 회전을 계산해 둡니다.
- 키는 쿼리 공분산의 고유기저로 회전시킵니다. 쿼리가 자주 관심을 두는 방향에 양자화 비트를 우선 배분합니다.
- 값은 점수 가중 값 공분산 기준으로 회전. 실제 출력에 기여하는 방향을 먼저 보존합니다.
- 그 위에 Hadamard 변환 + 비트 반전 순열을 얹어, 중요한 채널이 한쪽에 몰리지 않게 균등하게 흩뜨립니다.
운영 쪽도 단단합니다. 최근 토큰은 BF16, 오래된 히스토리는 INT2로 묶는 혼합 정밀 페이지드 캐시 구조라, 128K 컨텍스트에서 비압축 토큰 비중이 약 **0.24%**에 그칩니다. Triton으로 짠 퓨즈드 커널이 SGLang에 통합돼 있고, Qwen3(4B·8B·32B), GLM-4.7-FP8, MiniMax-M2.7용으로 사전 계산된 RotationZoo까지 같이 옵니다.
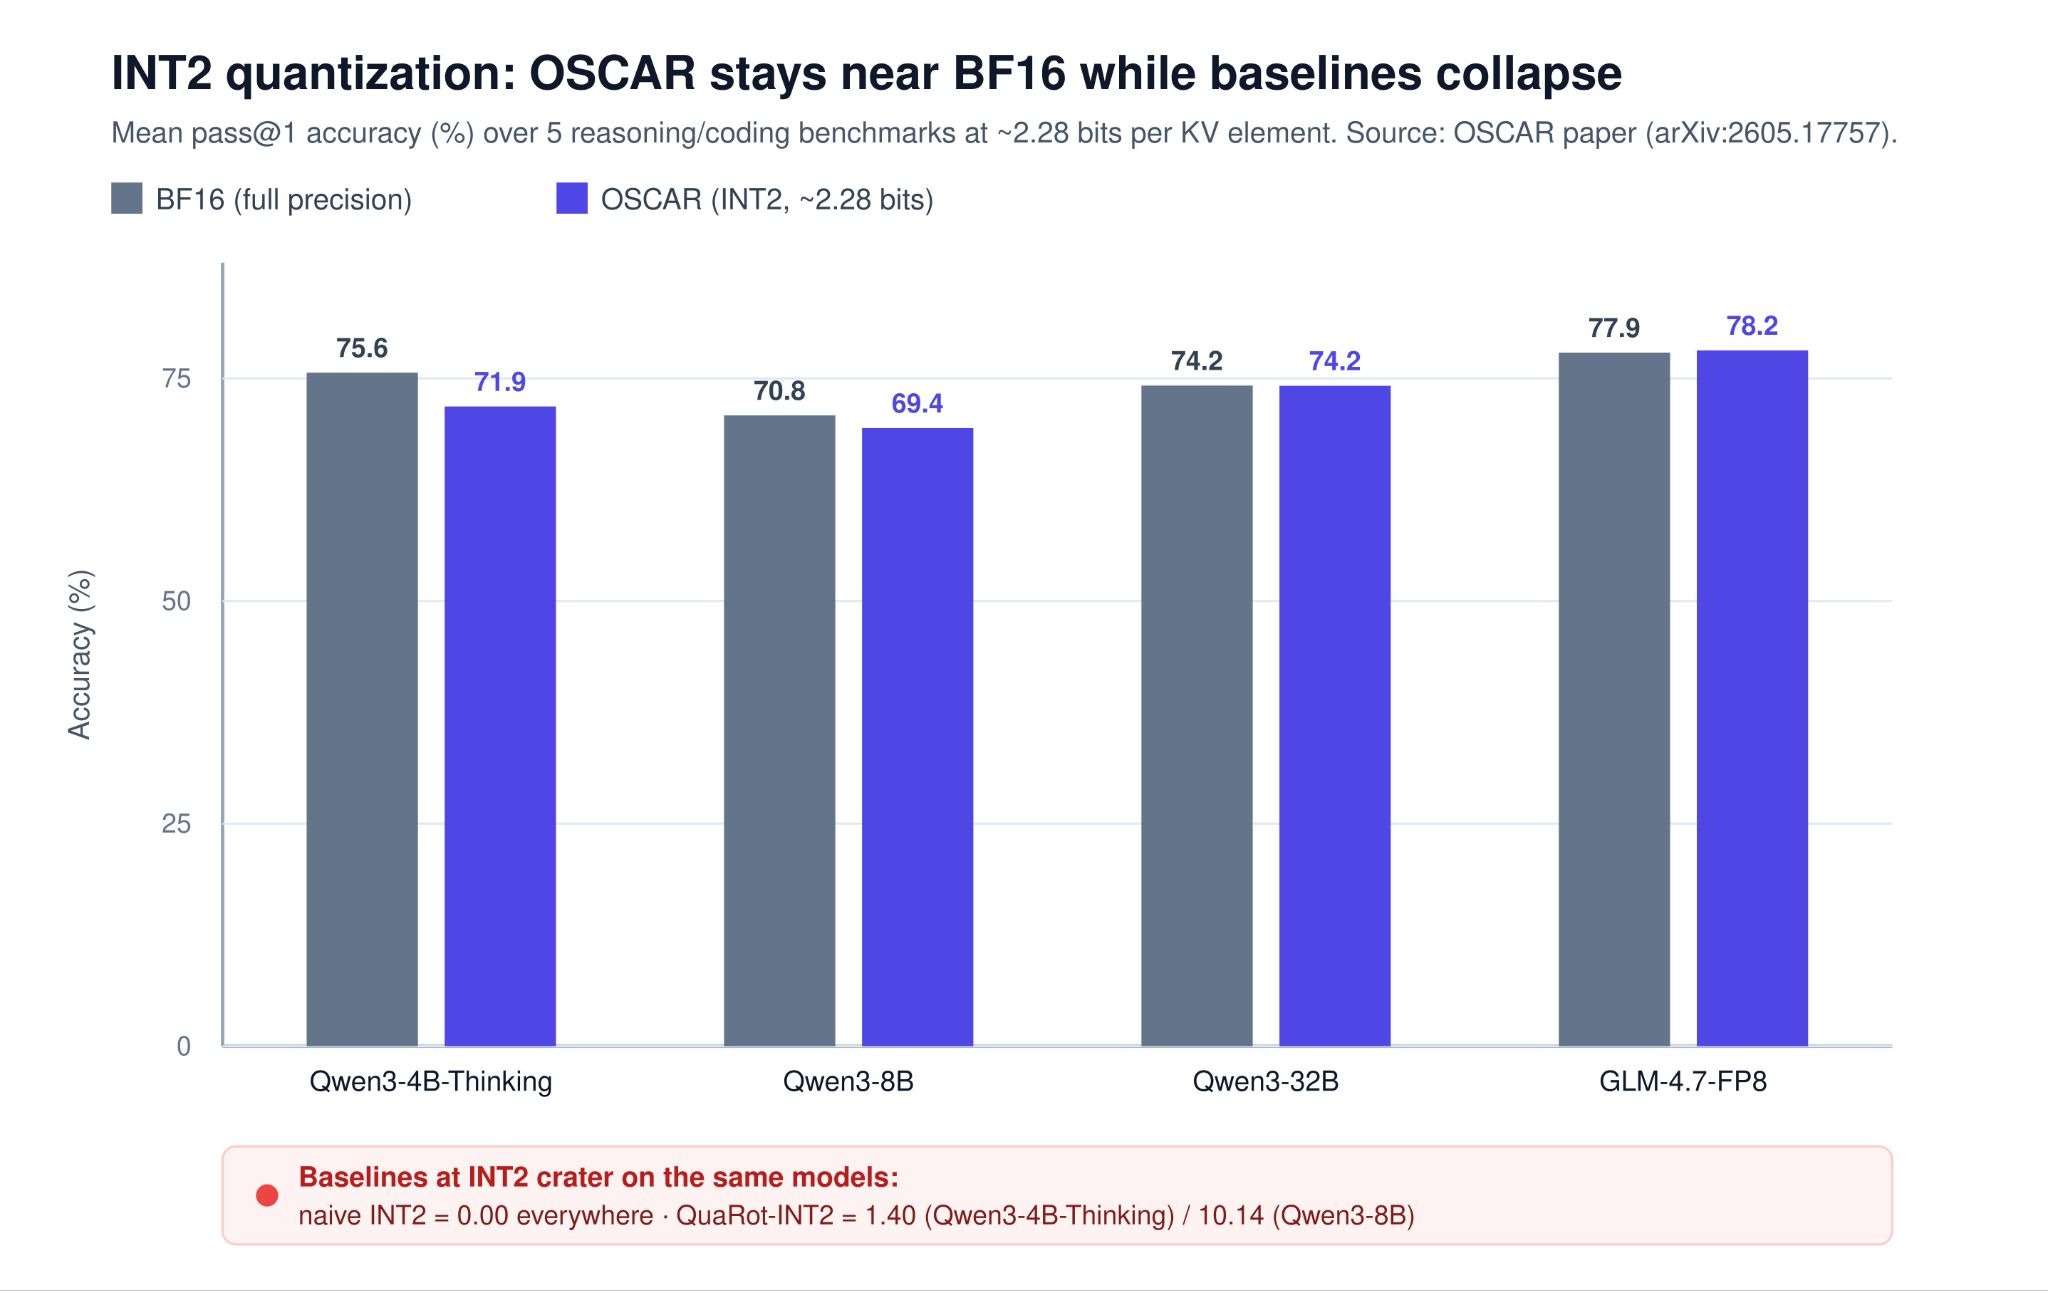
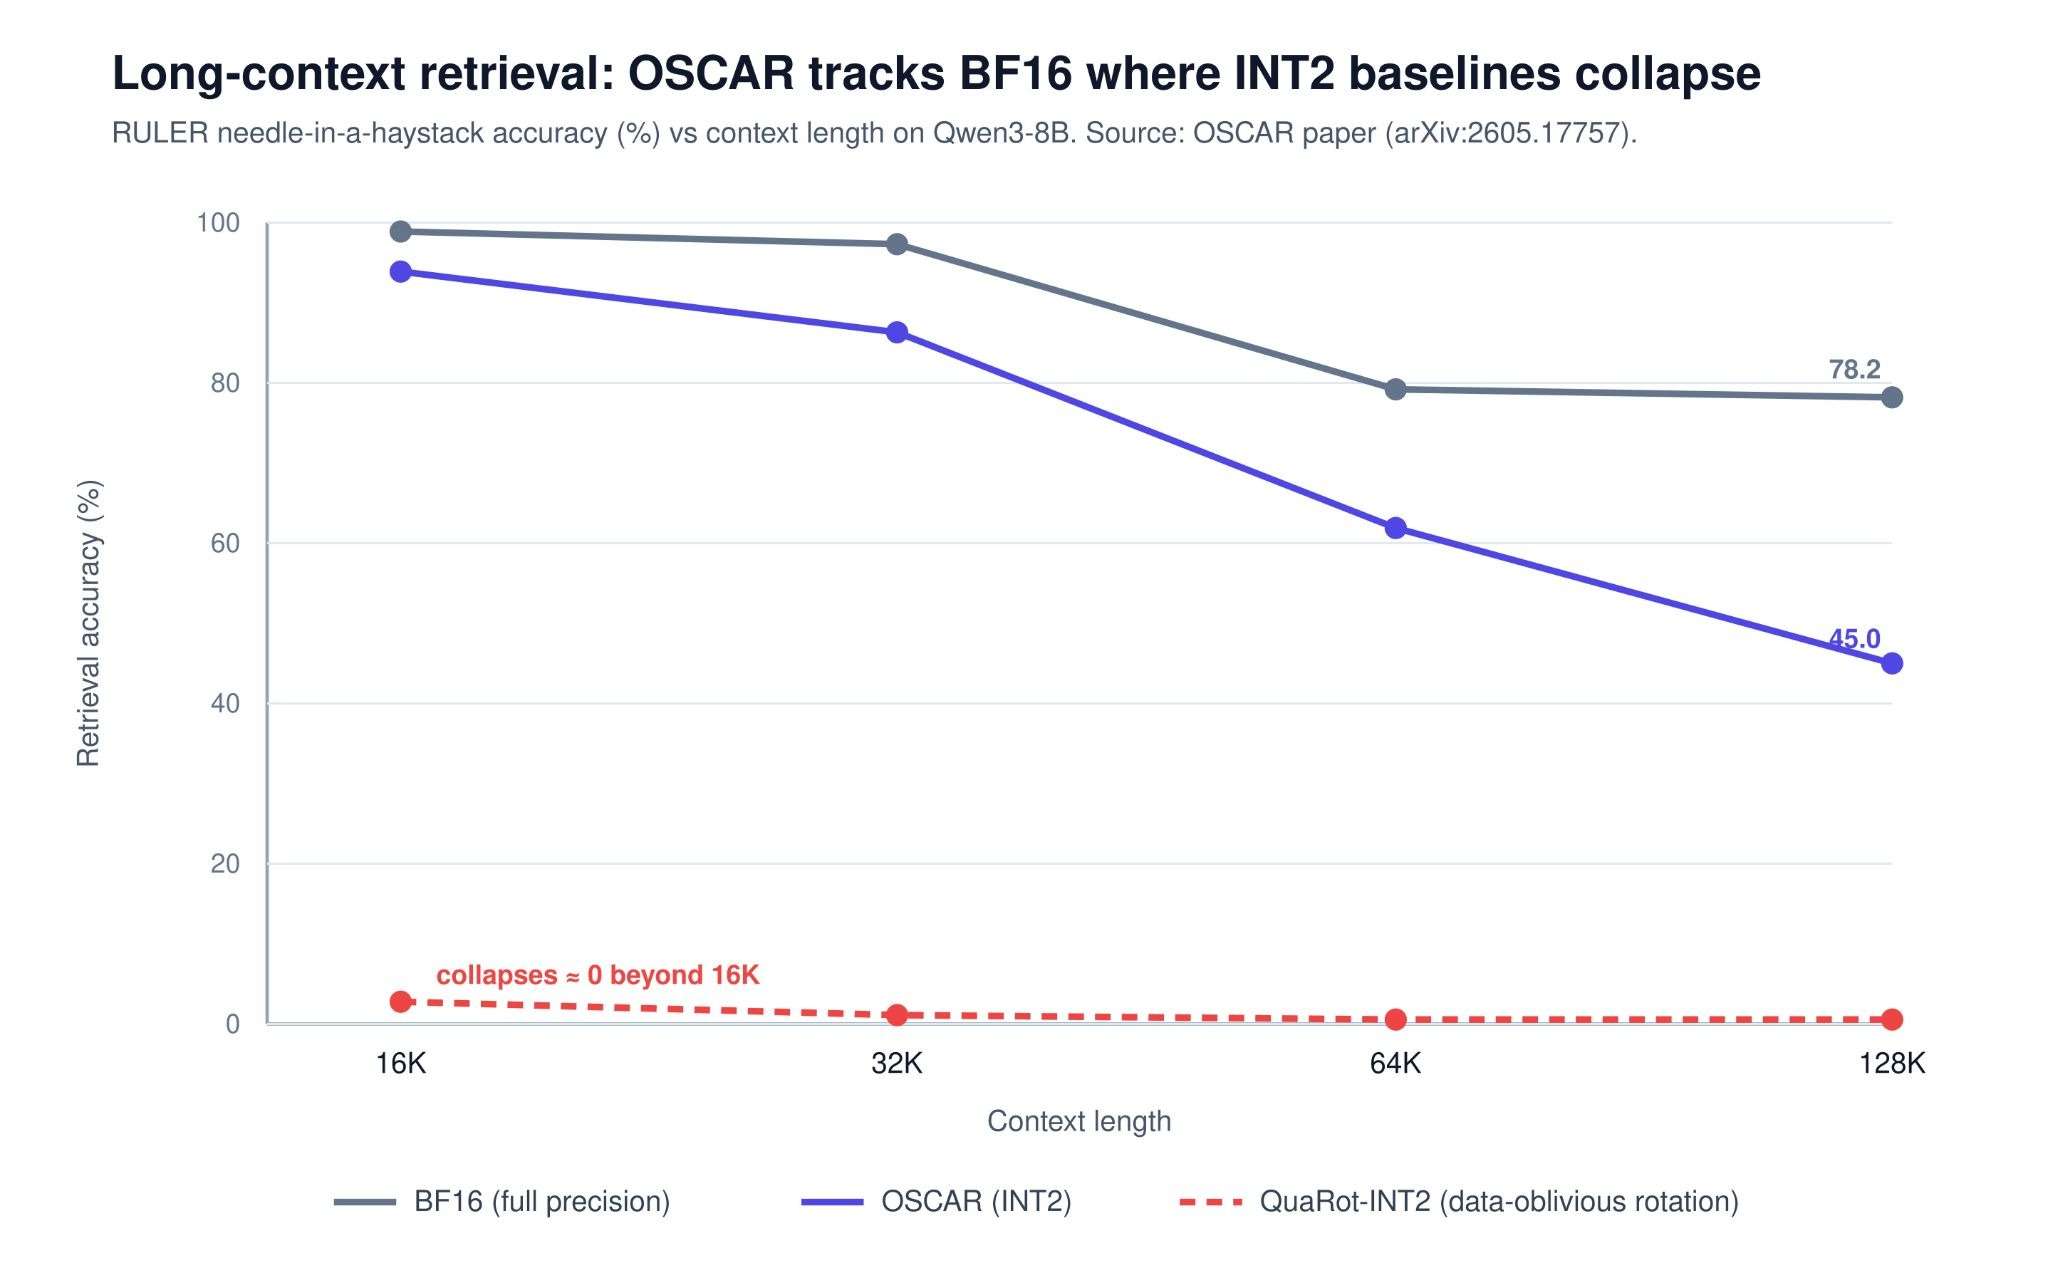
성능 보고는 구체적입니다. 유효 2.28비트 구간에서 Qwen3-8B 기준 BF16 대비 단 1.42점 차이. Qwen3-32B는 사실상 동등(0.02점), GLM-4.7-FP8에서는 BF16과 동률입니다. 같은 조건에서 naive INT2는 점수가 영 가까이로 무너집니다. 100K 컨텍스트에서 작업 단위 처리량 최대 7.83배, KV 메모리 약 8배 절감, 디코딩은 최대 3배 빠릅니다.
요약하면 OSCAR는 “지원 모델이 명확하고, 그 모델로 가능한 한 낮은 비트까지 짜내야 하는 프로덕션 인프라"가 본진입니다.
TurboQuant vs OSCAR — 진짜 비교는 누가 할 것인가
OSCAR 논문은 TurboQuant를 같은 비트폭에서 평가해 40점 넘는 하락을 보고했습니다. 그런데 OSCAR 측 스스로 단서를 답니다. 이 평가는 OSCAR 자체 프레임 안에서, 모든 레이어를 양자화하고, 단일 시드로 돈 결과이며, TurboQuant가 원래 노리는 비트 구간이 아닙니다. 즉, 두 진영의 직접 대결로 보기엔 조건이 한쪽으로 기울어 있습니다.
오히려 흥미로운 건 남은 빈칸입니다. 캘리브레이션 인식 회전 위에 최적 스칼라 양자화기를 얹는 조합은 아직 누구도 출시하지 않았습니다. 두 팀 모두 가능성을 공개적으로 인정하고 있습니다. 이 빈칸을 누가 먼저 채우느냐가 다음 라운드의 출발점이 될 가능성이 큽니다.
EpiCache — 양자화로 못 푸는 문제, 다중 턴 메모리
TurboQuant도 OSCAR도, 결국은 한 번에 들어온 컨텍스트를 줄입니다. 그런데 챗봇이나 에이전트는 그렇게 안 흘러갑니다. 대화가 누적되고, 히스토리가 점점 자랍니다. 비트 수를 줄이는 것만으로는 풀리지 않는 시나리오입니다.
애플의 EpiCache는 이 결을 정면으로 잡습니다.
- 블록 단위 프리필: 히스토리를 정해진 크기 청크로 잘라 순서대로 처리합니다.
- 에피소드 클러스터링: 대화를 의미 단위 “에피소드"로 묶고, 각 에피소드마다 따로 압축된 캐시를 둡니다.
- 에피소드 매칭 검색: 새 질문이 들어오면 관련 에피소드만 골라 라우팅합니다.
- 레이어별 적응형 예산 배분: 어떤 레이어가 토큰 제거에 민감한지 측정하고, 그 결과에 따라 예산을 다르게 줍니다.
LongMemEval·RealTalk·LoCoMo 같은 다중 턴 벤치마크에서 결과가 깔끔합니다. 단순 제거 기반 베이스라인 대비 최대 40% 더 높은 정확도, 4~6배 압축에서 풀 캐시 수준 정확도, 최대 3.5배 낮은 피크 메모리와 약 2.4배 짧은 지연을 보고합니다. 핵심은 EpiCache가 양자화와 직교한다는 점입니다. OSCAR나 TurboQuant 위에 그대로 얹어, 절감 효과를 곱으로 만들 수 있습니다.
실무자가 볼 핵심 포인트
- 모델이 자주 바뀌거나 캘리브레이션 데이터를 못 모으는 환경이면 TurboQuant부터 보세요. 3~4비트로 거의 무손실, 벡터 DB까지 같이 누를 수 있습니다.
- 운영 중인 모델이 OSCAR 지원 목록(Qwen3, GLM-4.7-FP8, MiniMax-M2.7)에 있고 INT2까지 짜내야 한다면 OSCAR가 사실상 유일한 후보입니다. RotationZoo와 SGLang 통합 덕에 도입 비용도 낮습니다.
- 대화형 에이전트나 장기 메모리가 누적되는 챗봇이라면 EpiCache는 옵션이 아니라 필수에 가깝습니다. 양자화 선택과 독립이라 둘을 같이 써도 무방합니다.
- 어떤 방식을 고르든 결국 outlier 채널 처리가 품질을 가릅니다. naive INT2부터 던지지 말고, 회전·재배치 단계가 들어간 압축인지부터 확인하세요.
- 도입 전 벤치마크는 자기 워크로드의 컨텍스트 길이·턴 수·모델·하드웨어 조합으로 직접 돌려야 합니다. 논문 수치는 대개 단일 모델·단일 데이터셋 기준입니다.
원문 출처
원문 보기 — MarkTechPost, Arnav Rai (2026-06-18)