핵심 요약
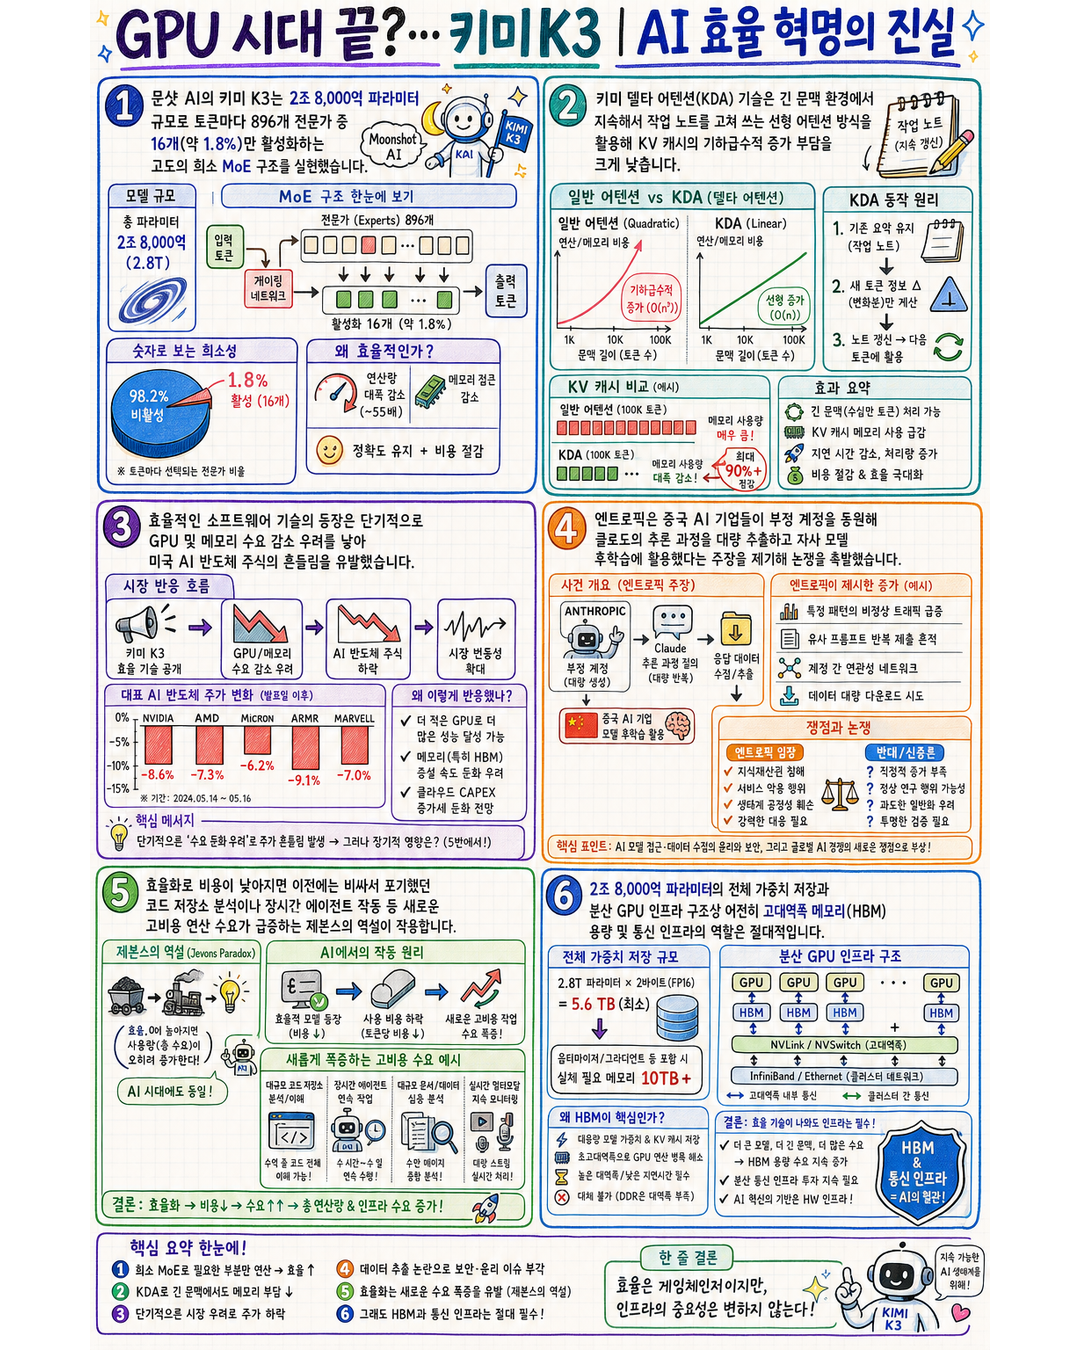
- 문샷 AI가 공개한 키미 K3는 총 2조 8000억 파라미터인데, 토큰 하나를 처리할 때 896개 전문가 중 16개만 켭니다. 활성 비율이 약 1.8%입니다.
- 키미 델타 어텐션(KDA) 은 지난 토큰의 모든 계산을 다 펼쳐두는 대신, 작업 노트 한 장을 계속 고쳐 쓰는 선형 어텐션 방식으로 KV 캐시 폭증을 눌렀습니다.
- 발표 직후 미국 AI 반도체 주가가 흔들렸습니다. “소프트웨어가 이렇게 효율적이면 GPU를 덜 사도 되는 것 아니냐"는 계산이 돌았기 때문입니다.
- 그런데 2.8TB짜리 가중치를 어딘가에 올려두고, 흩어진 전문가끼리 실시간으로 통신시켜야 한다는 조건은 그대로입니다. HBM 용량과 대역폭은 여전히 병목입니다.
- 연산이 싸지면 예전엔 비싸서 포기했던 작업이 살아납니다. 저장소 전체 분석, 몇 시간짜리 에이전트 실행 같은 것들이죠. 제본스의 역설이 그대로 작동합니다.
- 앞으로의 경쟁력은 GPU를 몇 장 가졌느냐가 아니라, 같은 메모리에서 얼마나 많은 유효 작업을 뽑아내느냐로 옮겨갑니다.
2조 8000억인데 1.8%만 켠다
키미 K3의 숫자는 언뜻 모순처럼 보입니다. 총 파라미터는 2조 8000억. 그런데 토큰 하나를 처리할 때 실제로 계산에 참여하는 전문가는 896개 중 16개뿐입니다.
이게 초희소(ultra-sparse) MoE 설계입니다. 모델 전체를 거대한 전문가 사전으로 두고, 들어온 토큰에 맞는 항목만 펼쳐 보는 구조죠. 지식의 총량은 2조 8000억 파라미터만큼 크게 유지하면서, 토큰당 연산 비용은 훨씬 작은 밀집 모델 수준으로 떨어뜨립니다.
기존 MoE도 같은 아이디어였습니다. 다만 K3는 그 희소성을 극단까지 밀어붙였습니다. 전문가 수를 900개 가까이 늘리고 활성 개수는 16개로 묶어두면, 전문가 하나하나는 더 좁고 더 전문적인 역할을 맡게 됩니다. 라우팅이 정확하기만 하면 같은 연산량으로 더 나은 답이 나옵니다.
문제는 그 “라우팅이 정확하기만 하면"이라는 조건입니다. 전문가를 잘게 쪼갤수록 라우터가 틀렸을 때의 손해도 같이 커집니다. 16개를 고르는 과정에서 엉뚱한 전문가가 섞이면, 그 토큰에 대해서는 2조 8000억 파라미터를 들고 있으면서도 엉성한 답이 나옵니다. 학습 단계에서 라우터를 얼마나 안정적으로 수렴시켰는지가 이런 설계의 성패를 가릅니다. 뒤에서 다시 다루겠습니다.
KDA — 긴 문맥에서 노트를 고쳐 쓰는 방식
두 번째 축은 어텐션입니다.
표준 어텐션은 문맥이 길어질수록 KV 캐시가 선형으로, 계산량은 제곱으로 불어납니다. 100만 토큰짜리 문맥을 다루려는 순간 이 캐시가 메모리를 통째로 잡아먹습니다. 긴 문맥 서비스가 비싼 진짜 이유가 여기 있습니다.
키미 델타 어텐션은 접근을 바꿉니다. 지나간 토큰의 세부 계산을 전부 보관해두는 대신, 압축된 상태 하나를 두고 새 토큰이 들어올 때마다 그 상태를 갱신합니다. 회의록을 한 줄도 빠짐없이 남기는 대신, 요약 노트 한 장을 계속 고쳐 쓰는 셈입니다.
선형 어텐션 계열의 오래된 아이디어지만, 그동안은 품질 손실 때문에 최전선 모델에 잘 안 들어갔습니다. K3는 이걸 전면에 세웠고, 그 결과 긴 문맥에서의 메모리 곡선이 훨씬 완만해졌습니다.
여기서 나오는 실무적 함의가 하나 있습니다. 같은 GPU 한 장에 올릴 수 있는 동시 세션 수가 늘어난다는 것. 서빙 관점에서는 이게 파라미터 수보다 훨씬 직접적인 비용 차이입니다. 문서 수십 개를 한꺼번에 물려 돌리는 사내 검색이나, 대화 이력을 통째로 들고 가는 상담 봇처럼 문맥이 계속 길어지는 서비스에서 특히 체감이 큽니다.
물론 공짜는 아닙니다. 압축된 상태 하나로 과거를 대신하는 방식은 원리상 정보를 버립니다. 문맥 앞쪽의 특정 문장 하나를 정확히 짚어내야 하는 작업에서 표준 어텐션만큼 버텨주는지는, 공개된 가중치로 외부 재현이 이뤄져야 판단할 수 있는 영역입니다.
그래서 GPU를 덜 사게 되나요
발표 직후 시장의 반응은 단순했습니다. 소프트웨어가 이만큼 효율적이면 하드웨어 지출이 줄어든다, 그러니 반도체 주식을 팔자.
세 가지를 놓친 계산입니다.
첫째, 가중치는 어디로도 사라지지 않습니다. 토큰당 16개 전문가만 켠다고 해서 나머지 880개를 안 들고 있어도 되는 게 아닙니다. 어떤 전문가가 호출될지 미리 알 수 없으니 2.8TB에 달하는 전체 가중치를 언제든 꺼낼 수 있는 곳에 올려둬야 합니다. HBM 용량 요구는 활성 파라미터가 아니라 총 파라미터를 따라갑니다.
둘째, 통신 부담이 커집니다. 전문가가 여러 GPU에 흩어져 있으면 토큰마다 “내 전문가가 있는 노드"로 데이터가 오갑니다. 전문가가 900개면 이 트래픽 패턴은 훨씬 산만해집니다. 인기 있는 전문가로 요청이 몰리는 부하 불균형까지 겹치면, 이론상 연산량은 줄었는데 실제 지연 시간은 기대만큼 안 줄어드는 상황이 나옵니다. 연산이 아니라 네트워크가 병목이 되는 거죠.
셋째, 싸지면 더 씁니다. 이게 제본스의 역설입니다. 증기기관 효율이 올라가자 석탄 소비가 오히려 늘었던 그 이야기요. 추론 단가가 떨어지면 예산 때문에 접었던 작업들이 되살아납니다. 코드 저장소 전체를 통으로 읽히기, 에이전트를 몇 시간씩 돌리기, 후보 답안을 수십 개 만들어 고르기. 하나같이 예전 단가로는 계산기가 안 맞던 일들입니다.
정리하면, 효율화는 GPU 수요를 없애는 게 아니라 수요의 성격을 바꿉니다. “모델 하나 겨우 올리기"에서 “같은 메모리에 더 많은 사용자와 더 긴 문맥과 더 복잡한 에이전트를 밀어 넣기"로요.
능력 추출 논란이라는 변수
기술 얘기와 별개로, K3를 둘러싼 논쟁이 하나 더 있습니다.
앤스로픽 쪽에서 중국 AI 기업들이 부정 계정을 대량으로 동원해 클로드의 추론 과정을 뽑아냈고, 이를 자사 모델 후학습에 썼다는 주장을 제기했습니다. 이른바 능력 추출(capability extraction) 의혹입니다. 현재까지 K3에 대해 확정된 사실로 규명된 건 아니고, 문샷 측 반박과 별개로 공방이 이어지는 단계입니다.
의혹의 진위와 별개로, 투자자들이 이 사안을 신경 쓰는 이유는 분명합니다. 수십억 달러를 들여 만든 최전선 모델의 우위가 API 호출 몇 백만 건으로 상당 부분 복제될 수 있다면, 선두 기업의 기술 격차 유지 기간이 계산보다 짧아집니다. 데이터센터 투자 회수 기간을 어떻게 잡느냐가 통째로 흔들리는 문제죠.
원본 영상
키미 K3의 구조 설명과 시장 반응, 능력 추출 논란까지의 흐름은 위 영상에서 함께 짚습니다. 특히 MoE 라우팅과 KV 캐시 부담을 비유로 풀어낸 부분이 이해에 도움이 됩니다.
실무자가 볼 체크포인트
| 구분 | 확인할 것 |
|---|---|
| 벤치마크 해석 | 순위표 등수보다 활성 파라미터 크기와 100만 토큰 입력 시 첫 토큰 지연(TTFT)을 봅니다 |
| MoE 실측 | 전문가 부하 불균형이 실제 추론 지연을 얼마나 끌어올리는지 통신 통계로 확인합니다 |
| 워크로드 배치 | 고난도 추론은 폐쇄형 모델에, 대량·반복 처리는 KDA·MoE 계열 효율 모델에 나눠 붙이는 하이브리드 설계가 가능해졌습니다 |
| 인프라 투자 | 연산력 지표만 보지 말고 스위칭 인프라와 메모리 전송 대역폭을 쥔 기업까지 범위를 넓혀 봅니다 |
| 보안 설계 | 자사 모델을 API로 열어둔다면 대량 추론 로그 수집 패턴에 대한 탐지·제한 정책이 필요합니다 |
남는 질문
키미 K3가 남긴 건 “GPU가 이제 필요 없다"는 결론이 아닙니다. 하드웨어를 평가하는 잣대가 한 단계 복잡해졌다는 사실입니다.
예전엔 GPU 장수와 총 연산량으로 대략의 순위가 나왔습니다. 이제는 네트워크 대역폭, 전문가 부하 균형, 메모리 슬롯당 처리 밀도까지 같이 봐야 답이 나옵니다. 양적 경쟁에서 서빙 품질 경쟁으로 축이 옮겨간 거죠.
문샷이 기술 보고서를 완전히 공개하고 외부 재현이 이뤄지기 전까지, 지금 나온 숫자는 어디까지나 회사 발표치입니다. 그 검증 과정에서 활성 파라미터와 실측 지연 시간이 어떻게 나오는지가, 이 모델의 실제 무게를 결정할 겁니다.
원문 출처
원문: 영상 원문 보기 — GPU 시대 끝?… 키미K3 | AI 효율 혁명의 진실 — 안될공학 - IT 테크 신기술