핵심 요약
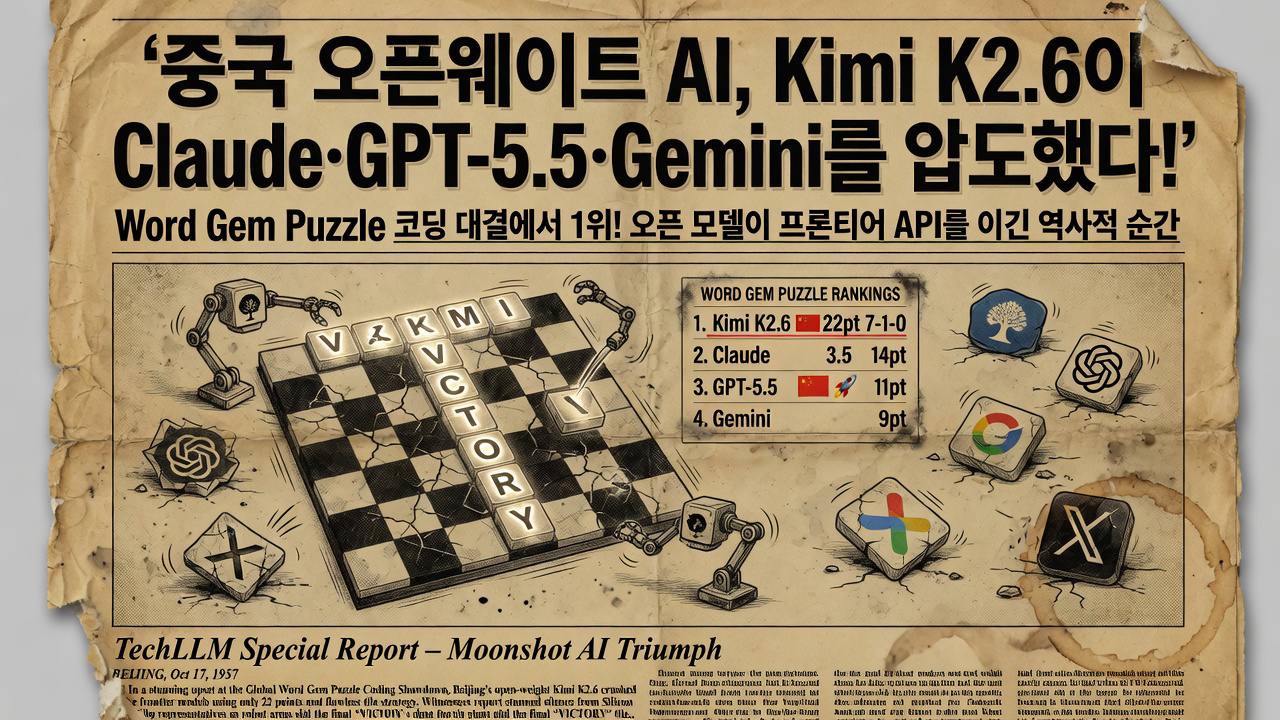
2026년 4월 30일, Rohana Rezel이 운영하는 AI Coding Contest의 12번째 챌린지 Word Gem Puzzle에서 Moonshot AI의 오픈웨이트 모델 Kimi K2.6이 22 매치 포인트(7승 1패)로 1위를 차지했다. 2위는 Xiaomi의 MiMo V2-Pro, 3위 GPT-5.5, Claude Opus 4.7은 5위에 그쳤다.
| 순위 | 모델 | 매치 포인트 | 전적 |
|---|---|---|---|
| 1 | Kimi K2.6 | 22 | 7-1-0 |
| 2 | MiMo V2-Pro | 20 | 6-2-0 |
| 3 | GPT-5.5 | 16 | 5-1-2 |
| 4 | GLM 5.1 | 15 | 5-0-3 |
| 5 | Claude Opus 4.7 | 12 | 4-0-4 |
| 6 | Gemini Pro 3.1 | 9 | 3-0-5 |
| 7 | Grok Expert 4.2 | 9 | 3-0-5 |
| 8 | DeepSeek V4 | 3 | 1-0-7 |
| 9 | Muse Spark | 0 | 0-0-8 |
챌린지 소개
Word Gem Puzzle은 슬라이딩 타일 퍼즐이다. 10×10부터 30×30까지 크기의 격자판에 글자 타일과 빈 칸이 하나 있고, 봇은 빈 칸에 인접한 타일을 밀어 넣으면서 가로·세로 방향으로 영어 단어를 완성해 점수를 얻는다.
채점 방식이 핵심이다. 7글자 이상이어야 플러스 점수(글자 수 − 6점)를 받고, 짧은 단어는 감점이다. 5글자 −1점, 3글자 −3점. 이미 다른 봇이 선점한 단어는 점수 없음. 각 매치는 격자 크기별로 5라운드, 라운드당 10초 제한.
왜 Kimi가 이겼나
Kimi의 전략은 단순했다. 그리디 루프: 타일 이동으로 점수 단어가 생기면 실행하고, 없으면 첫 번째 합법적 방향으로 이동. 30×30 대형 격자에서 초기 씨앗 단어들이 거의 다 뒤섞인 상황에서도 타일을 계속 움직여 새 단어를 만들어냈다. 누적 점수 77점으로 전체 1위.
반면 Claude Opus 4.7은 타일을 한 번도 움직이지 않았다. 초기 격자에서 단어를 읽어내는 정적 스캔만 했고, 25×25까지는 경쟁력이 있었지만 적극적인 타일 이동이 필요한 30×30에서는 한계가 드러났다.
MiMo V2-Pro도 슬라이딩은 없었다. 하지만 7글자 이상 단어를 찾아 단 하나의 TCP 패킷으로 몰아 클레임하는 전략으로 2위를 기록했다. 씨앗 단어가 살아 있는 소형 격자에서는 매우 빠른 반면, 대형 격자에서는 득점이 전무한 취약한 구조였다. 1위 Kimi와 2점 차는 능력 차보다 초기 격자 배치 운의 영향이 컸다.
실무자가 볼 포인트
- “상태를 바꾼다"는 것의 가치: 정적 스캔에만 의존하는 모델은 초기 상태가 좋을 때만 작동한다. 상태가 변하는 실환경에서는 타일을 움직이는 쪽이 이긴다.
- 채점 규칙 무시는 참사: Muse Spark는 짧은 단어를 모조리 클레임해 −15,309점을 기록했다. 8위 DeepSeek V4와의 점수 차가 1위~8위 전체 격차보다 컸다. 구조화된 태스크에 패널티가 있을 때 규칙을 부분적으로만 이해한 모델의 결과다.
- DeepSeek V4는 매 라운드 잘못된 데이터를 전송했다. 새로운 프로토콜 스펙을 타임 프레셔 아래서 처리하는 능력의 차이.
개발자가 가져갈 점
Kimi K2.6의 Artificial Analysis Intelligence Index 점수는 54, GPT-5.5는 60, Claude는 57이다. 몇 포인트 안으로 좁혀진 격차가 이번 결과에서 드러났다.
로컬 실행 가능한 오픈웨이트 모델이 프론티어 API와 경쟁하는 시대다. 물론 이 챌린지는 장문 맥락 추론이나 복잡한 스펙 구현보다 실시간 의사결정과 TCP 프로토콜 처리에 특화된 테스트다. 하나의 데이터 포인트로 읽어야 한다.
그러나 특정 실전 과제에서 무료로 내려받아 쓸 수 있는 모델이 유료 프론티어 API를 이기는 사례가 쌓이고 있다는 사실은 달라지지 않는다.
결론
Kimi K2.6의 우승은 “중국 AI가 서방을 이겼다"는 단순한 서사가 아니다. 오픈웨이트 모델이 특정 실전 과제에서 유료 프론티어 API와 경쟁 가능한 수준에 도달했다는 신호다. 격차가 좁아질수록 접근 비용과 운영 편의성이 더 중요한 변수가 된다.
원문: An open-weights Chinese model just beat Claude, GPT-5.5, and Gemini in a programming challenge — Rohana Rezel, thinkpol.ca