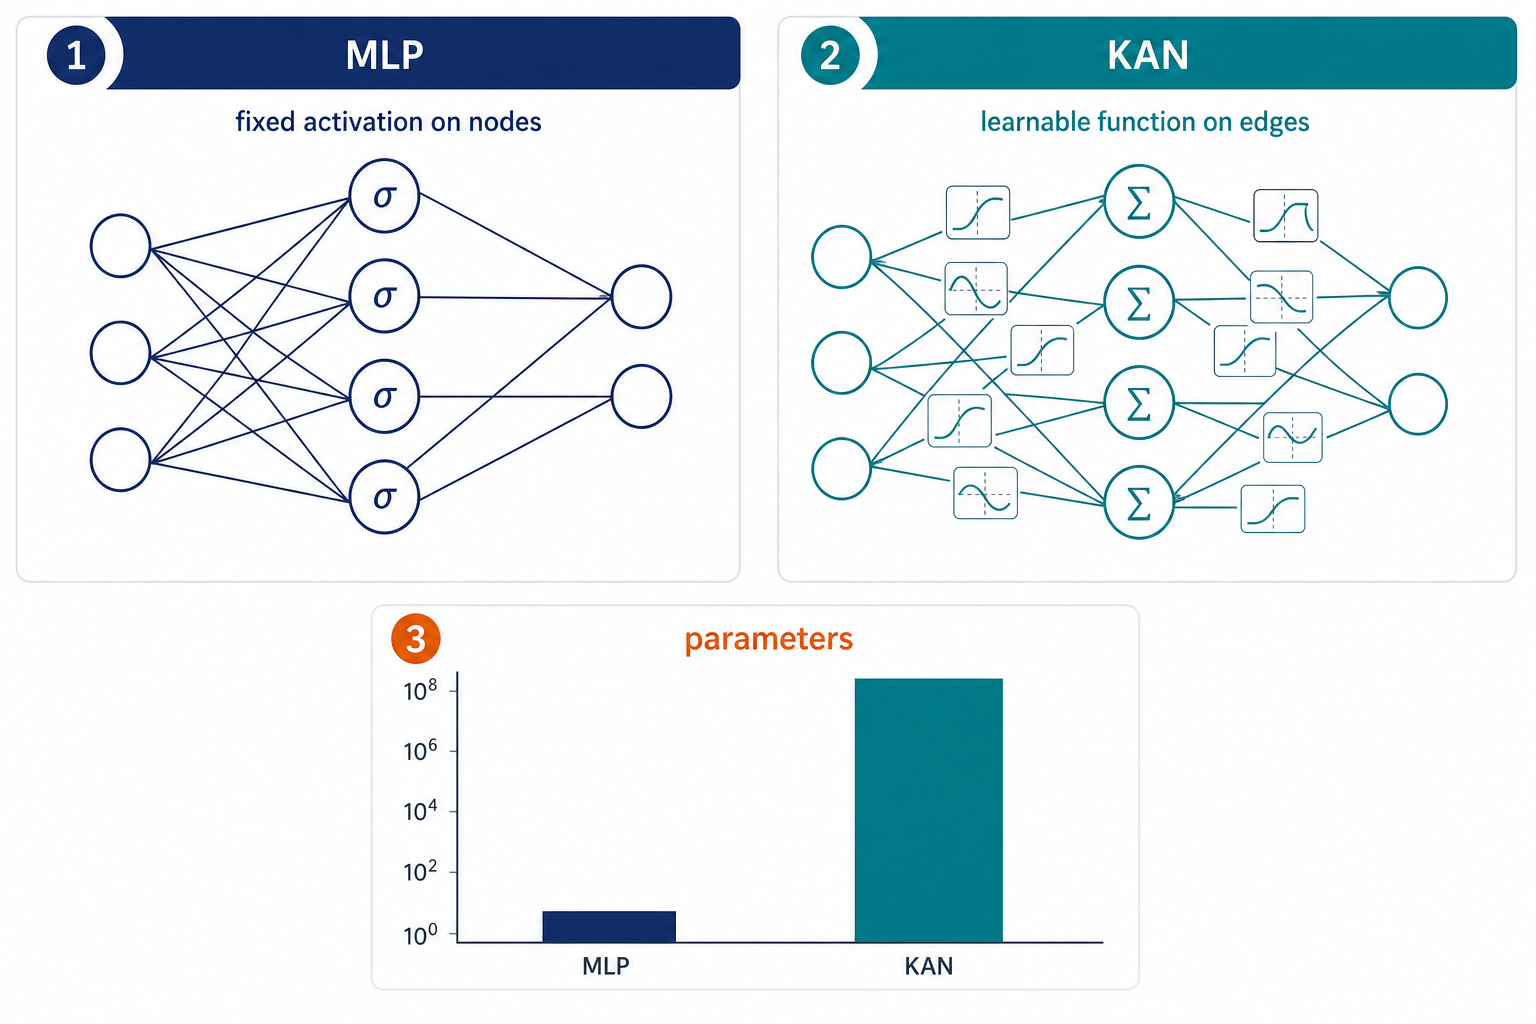
MIT 연구진이 신경망의 곱셈 가중치를 전부 학습 가능한 곡선으로 바꿨더니, 매듭 이론 과제에서 파라미터 200개짜리 모델이 30만 개짜리 MLP보다 정확했습니다.
세 문장 요약
문제 — 지금의 신경망은 대부분 MLP(다층 퍼셉트론, 노드마다 정해진 활성화 함수를 두고 연결선에는 숫자 가중치 하나씩만 두는 구조)를 쌓아 만드는데, 데이터 뒤에 깔끔한 수식이 숨어 있는 과학 문제에서도 파라미터를 크게 늘려야 겨우 정확도가 나오고 학습한 내용을 사람이 읽어내기도 어렵습니다.
방법 — KAN은 노드에 있던 활성화 함수를 연결선(엣지)으로 옮기고, 선형 가중치를 전부 B-스플라인(구간마다 이어 붙인 부드러운 다항식 곡선)으로 바꿔 곡선 자체를 학습시킵니다. 노드에서는 들어온 값을 더하기만 합니다.
결과 — 매듭 이론 데이터에서 파라미터 약 200개짜리 KAN이 테스트 정확도 81.6%를 기록해 구글 딥마인드가 쓴 파라미터 약 30만 개짜리 MLP의 78%를 넘겼고, 푸아송 방정식 풀이에서는 파라미터를 100분의 1로 줄이고도 오차를 100분의 1로 낮췄습니다. 대신 같은 파라미터 수 기준으로 학습은 약 10배 느립니다.
곡선 맞추기가 막히는 지점
딥러닝의 기본 부품은 20년 넘게 거의 그대로입니다. 연결선마다 숫자 가중치를 하나씩 두고, 노드마다 ReLU 같은 정해진 함수를 통과시키는 방식이죠. 이 구조는 이미지든 언어든 데이터만 충분하면 잘 작동합니다.
문제는 데이터가 적고 답이 수식으로 떨어지는 영역입니다. 물리·수학처럼 변수 몇 개가 정해진 관계로 묶여 있는 문제에서 MLP는 두 가지 아쉬움을 동시에 드러냅니다. 정확도를 끌어올리려면 모델을 계속 키워야 하고, 다 학습하고 나면 그 안에서 무슨 일이 벌어졌는지 사람이 읽어내기 어렵습니다.
논문이 직접 꺼내 든 사례가 구글 딥마인드의 매듭 이론 연구입니다. 매듭의 여러 성질(불변량) 사이에 어떤 관계가 있는지 신경망으로 찾은 작업인데, 여기서 쓰인 모델은 4층에 폭 300짜리 MLP였고 테스트 정확도는 78%였습니다. 파라미터로 따지면 약 30만 개입니다.
수치보다 눈에 띄는 건 작업 방식입니다. 논문 저자들은 딥마인드 팀이 여러 불변량 중 시그니처(매듭의 뒤틀림 정도를 나타내는 정수 불변량)를 예측 대상으로 직접 골랐다는 점을 지적합니다. 입력과 출력을 무엇으로 나눌지 사람이 정해주지 않으면 경우의 수가 변수 개수에 따라 지수적으로 늘어나기 때문입니다. 모델이 관계를 스스로 드러내지 못하니, 사람이 미리 가설을 좁혀줘야 했던 겁니다.
보편근사정리가 답하지 않는 것
MLP의 이론적 근거는 보편근사정리(UAT)입니다. 어떤 함수든 오차 범위를 정해주면 뉴런을 충분히 많이 쓴 2층 신경망으로 그 범위 안에 들어갈 수 있다는 정리죠.
논문은 이 정리의 빈칸을 짚습니다. 정리는 “충분히 많이"라고만 말할 뿐, 오차를 줄일 때 뉴런 수가 얼마나 빠르게 늘어나는지는 보장하지 않습니다. 실제로 어떤 경우에는 입력 차원이 커질수록 필요한 뉴런 수가 지수적으로 폭발하는 차원의 저주가 나타납니다.
두 정리의 차이는 결국 하나로 모입니다. KAN은 함수에 숨어 있는 저차원 합성 구조를 활용하고, MLP는 그러지 못합니다.
정리하면, 임의의 함수를 상대로는 차원의 저주를 피할 방법이 없습니다. 그래서 논문은 표적을 좁힙니다. 과학과 공학에서 실제로 마주치는 함수는 대개 몇 개의 단순한 연산이 겹겹이 쌓인 합성 구조를 갖습니다. 그런 “얌전한” 함수라면 구조를 이용해 훨씬 작은 모델로 훨씬 정확하게 맞출 수 있다는 것이 이 논문의 출발점입니다.
여기서 논문의 질문이 나옵니다. 연결선에 숫자 하나만 두는 대신, 연결선마다 함수 모양 자체를 학습시키면 어떻게 될까요.
엣지 위의 스플라인
KAN의 근거는 1957년 콜모고로프-아르놀트 표현 정리입니다. 여러 변수를 받는 연속 함수는 1변수 함수들의 덧셈과 합성만으로 다시 쓸 수 있다는 내용이죠. 변수가 몇 개든, 결국 “한 변수짜리 곡선 여러 개 + 덧셈"으로 분해된다는 뜻입니다.
이 정리는 오래전부터 알려져 있었지만 딥러닝에서는 거의 쓰이지 않았습니다. 정리가 보장하는 형태는 2층에 중간 폭이 입력 차원의 2배+1인 아주 얕은 구조인데, 이 형태로는 실제 함수를 매끄럽게 근사하기 어렵기 때문입니다. 논문은 정리를 그대로 따르는 대신, 정리가 제시한 구조를 넓히고 깊게 쌓을 수 있는 신경망 계층으로 일반화합니다.
노브 대신 이퀄라이저
기존 MLP를 오디오 장비에 비유하면, 연결선마다 볼륨 노브가 하나씩 달려 있고 노드에는 미리 정해진 이펙터가 물려 있는 믹서입니다. 학습이란 노브 숫자를 돌리는 일이고, 소리를 어떻게 바꿀지는 이펙터가 정해둔 대로만 가능합니다.
KAN은 노브를 떼어내고 그 자리에 이퀄라이저 곡선을 붙입니다. 연결선마다 “입력이 이 값일 때 출력을 이만큼"이라는 곡선 전체가 학습 대상이 되고, 노드는 들어온 곡선 출력을 더하는 일만 합니다. 곱셈 가중치는 하나도 남지 않습니다.
곡선은 B-스플라인으로 표현합니다. 구간을 격자로 나눈 뒤 각 구간의 계수를 학습하는 방식이라, 곡선의 표현력을 격자 수 G와 다항식 차수 k(보통 3차)로 조절할 수 있습니다. 학습 도중에 격자를 촘촘하게 늘려 정확도를 올리는 그리드 확장도 여기서 나옵니다. 거친 격자로 대강 맞춘 뒤 세밀한 격자로 갈아 끼우는 겁니다.
파라미터는 더 쓰고, 폭은 더 줄인다
깊이 L, 폭 N, 격자 G인 구조를 놓고 세어 보면 KAN의 파라미터는 대략 N²LG, MLP는 N²L입니다. 같은 폭·깊이라면 KAN이 격자 수만큼 더 많은 셈이라 언뜻 손해로 보입니다.
논문의 반박은 폭에 있습니다. KAN은 MLP보다 훨씬 작은 N으로 충분하기 때문에, 격자로 늘어난 몫을 폭을 줄여 상쇄하고도 남는다는 겁니다. 이론적으로도 근거를 댑니다. 곡선을 k차 스플라인으로 잡으면 테스트 오차가 파라미터 수의 −(k+1)제곱에 비례해 줄어드는데, 3차 스플라인이면 지수가 4가 됩니다. 기존 연구에서 MLP는 지수 1조차 채우지 못하고 일찍 정체됐다는 것이 저자들이 내놓는 비교점입니다.
모델을 키우는 대신 격자를 늘린다
KAN의 실용적인 장점 하나는 모델을 키우는 방식에 있습니다. MLP에서 스케일링 법칙을 확인하려면 크기가 다른 모델을 각각 처음부터 따로 학습시켜야 합니다. 비용이 크게 드는 이유죠.
KAN은 다릅니다. 파라미터가 적은 모델을 먼저 학습시킨 뒤, 스플라인 격자만 촘촘하게 바꿔 더 큰 모델로 확장할 수 있습니다. 큰 모델을 백지 상태에서 다시 학습시킬 필요가 없습니다. 거친 격자로 그린 곡선에 세밀한 격자의 곡선을 맞춰 계수를 초기화하는 방식이라, 이미 배운 모양을 그대로 물려받습니다.
작게 시작해 필요한 만큼만 정밀도를 올리는 방식이 가능하다는 뜻입니다.
여기에 해석 가능성이 얹힙니다. 학습된 곡선을 그대로 그림으로 볼 수 있으니, 기여가 거의 없는 연결선은 잘라내고 남은 곡선을 사인·지수 같은 익숙한 함수로 바꿔 끼우면 모델이 찾아낸 관계를 수식으로 읽어낼 수 있습니다. 이 과정은 자동화된 한 방이 아니라 사람이 개입하는 여러 단계로 이뤄집니다.
가지치기에서 수식까지
KAN을 해석 가능하게 만드는 절차는 논문에서 “누를 수 있는 버튼들"로 표현됩니다. 순서대로 눌러야 하는 파이프라인이 아니라, 결과를 보면서 다음에 무엇을 시도할지 고르는 도구 모음에 가깝습니다.
첫 단계는 희소화입니다. MLP에서는 가중치에 L1 정규화를 걸어 불필요한 연결을 0으로 몰아가는데, KAN에는 애초에 숫자 가중치가 없습니다. 그래서 활성화 함수의 L1 노름을 입력값들에 대한 평균 크기로 정의합니다. 그런데 저자들은 L1만으로는 충분히 희소해지지 않는다는 것을 발견하고, 층별 기여도의 엔트로피를 함께 벌점으로 넣습니다. 기여가 여러 연결에 골고루 퍼지는 상태를 억제해 소수의 연결로 몰아주는 장치입니다.
다음은 눈으로 보는 단계입니다. 곡선의 크기에 따라 선의 투명도를 조절해 그리면, 거의 일하지 않는 연결선은 흐려지고 실제로 신호를 나르는 연결선만 진하게 남습니다. 그림만 봐도 어디를 잘라야 할지 보입니다.
앨리스가 식을 찾아가는 다섯 단계
논문은 가상의 사용자 앨리스가 곡선 뒤에 숨은 수식을 찾아가는 과정을 예로 듭니다. 목표는 지수와 사인이 겹쳐진 함수 하나입니다.
- 희소화 학습 — 완전 연결된 [2,5,1] KAN에서 시작합니다. 희소화 정규화를 걸고 학습하면 은닉층 뉴런 5개 중 4개가 사실상 놀고 있는 상태가 됩니다.
- 가지치기 — 자동 가지치기가 마지막 하나만 남기고 은닉 뉴런을 모두 잘라내 [2,1,1] 구조가 됩니다. 남은 활성화 함수들의 모양이 눈에 익은 곡선으로 보이기 시작합니다.
- 기호 고정 — 사용자가 그림을 보고 각 곡선을 사인, 제곱, 지수로 지정합니다. 어떤 함수인지 감이 오지 않으면 후보를 추천받는 기능(
suggest_symbolic)을 쓸 수 있습니다. - 추가 학습 — 모든 활성화 함수를 기호로 바꾸고 나면 남는 것은 아핀 계수뿐입니다. 이 계수만 더 학습시켜 손실이 기계 정밀도까지 떨어지면, 식을 제대로 찾았다는 신호입니다.
- 수식 출력 — 심파이로 정리하면 원래 함수와 같은 식이 나옵니다. 논문 예시에서는 원주율이 3.14로 표시된 것 말고는 정답과 동일했습니다.
저자들은 “그럼 기존 기호 회귀를 쓰면 되지 않느냐"는 반문을 직접 다룹니다. 기호 회귀는 잘 깨지고 디버깅이 어렵다는 것이 논문의 답입니다. 성공 아니면 실패라는 결과만 내놓을 뿐, 중간에 무엇이 어떻게 진행되는지 사람이 읽을 수 있는 형태로 보여주지 않기 때문입니다. KAN은 학습 도중에도 곡선 그림이라는 중간 산출물을 계속 내놓습니다.
활성화만 학습시켜서는 부족했다
곡선을 학습시키는 것이 핵심이라면, 굳이 엣지로 옮기지 않고 노드의 활성화 함수만 학습 가능하게 바꿔도 되지 않을까요. 저자들은 이 절충안을 실제로 만들어 부록에서 비교합니다. 가중치 행렬은 그대로 두고 노드의 활성화 함수만 학습시키는 구조입니다.
확장성만 보면 이 절충안이 유리합니다. 학습해야 할 활성화 함수의 개수가 폭에 비례해 늘어나는 데 그치는 반면, KAN은 폭의 제곱에 비례해 늘어나기 때문입니다. 정확도도 MLP보다는 나았습니다.
문제는 해석 가능성이었습니다. KAN에서는 그림만 봐도 구조가 읽히던 예제들이, 가중치 행렬이 남아 있는 구조에서는 잘 읽히지 않았습니다. 저자들은 행렬이 자유도를 너무 많이 남겨 학습된 활성화 함수를 제멋대로 만든다고 해석합니다. 결론은 분명합니다. 해석 가능성을 얻으려면 선형 가중치 행렬 자체를 없애야 한다는 것이죠. 활성화 함수를 엣지로 옮긴 선택이 취향이 아니라 필요였다는 근거입니다.
숫자로 본 실험 결과
논문은 곡선 맞추기, 미분방정식 풀이, 연속 학습, 과학 데이터 재발견까지 네 갈래로 실험합니다. 핵심 비교는 다음과 같습니다.
| 과제 | KAN | 비교 대상(MLP) | 차이 |
|---|---|---|---|
| 매듭 이론 시그니처 분류 | [17,1,14] 구조, 약 200 파라미터, 정확도 81.6% | 딥마인드 4층 폭 300, 약 3×10⁵ 파라미터, 78% | 정확도 +3.6%p, 파라미터 약 1,500분의 1 |
| 푸아송 방정식 풀이 | 2층 폭 10, 약 10² 파라미터, MSE 10⁻⁷ | 4층 폭 100, 약 10⁴ 파라미터, MSE 10⁻⁵ | 오차 약 100분의 1, 파라미터 약 100분의 1 |
| 특수 함수 근사(구면조화함수) | [2,2,3,2,1], 테스트 RMSE 9.45×10⁻⁵ | 테스트 RMSE 6.21×10⁻⁴ | 오차 약 6.6분의 1 |
| 특수 함수 근사(야코비 타원함수) | [2,3,2,1,1,1], 테스트 RMSE 1.33×10⁻⁴ | 테스트 RMSE 6.48×10⁻⁴ | 오차 약 4.9분의 1 |
| 순차 학습(가우시안 봉우리 5개) | 이전 구간 유지, 망각 없음 | 이전 구간 손상, 심한 망각 | 정성 비교 |
숫자만 보면 압도적이지만, 조건을 함께 봐야 합니다.
스케일링 지수 4
곡선 맞추기 실험의 결론은 오차가 줄어드는 속도입니다. 장난감 데이터 다섯 개에서 KAN은 이론이 예측한 가장 빠른 기울기, 즉 파라미터의 −4제곱에 거의 근접하게 오차를 떨어뜨렸습니다. 같은 조건에서 MLP는 훨씬 완만하게 줄다가 금세 평평해졌습니다. 모델을 키운 만큼 정확도가 따라오느냐의 문제라, 작은 모델로 높은 정밀도가 필요한 과학 계산에서 특히 의미가 큽니다.
사람이 짠 구조와 기계가 찾은 구조
앞의 결과에는 전제가 하나 붙습니다. 정답에 해당하는 KAN 모양을 알고 있다는 전제죠. 논문은 그 중간 지대를 파인만 방정식 데이터셋으로 확인합니다. 물리 공식 모음이라 변수 사이 관계는 알지만, 어떤 KAN 구조가 최적인지는 모르는 상황입니다.
비교 방식이 재미있습니다. 사람이 공식 구조를 보고 직접 설계한 KAN과, 큰 KAN을 학습시킨 뒤 가지치기로 자동으로 찾아낸 KAN을 나란히 놓습니다. 가우시안 분포 공식을 예로 들면 이렇습니다.
| 구성 방식 | 구조 | 테스트 RMSE |
|---|---|---|
| 사람이 설계 | [2,2,1,1] | 7.66×10⁻⁵ |
| 가지치기로 발견(최저 손실) | [2,2,1,1] | 2.86×10⁻⁵ |
| 가지치기 없이 학습 | — | 4.60×10⁻⁵ |
| MLP | — | 1.45×10⁻⁴ |
같은 모양이라도 가지치기를 거친 쪽의 오차가 더 낮습니다. 구조를 줄이는 과정 자체가 학습에 도움이 됐다는 뜻이고, 사람의 설계가 언제나 최선은 아니라는 이야기이기도 합니다. 네 방식 모두 MLP보다는 오차가 작았습니다.
파국적 망각이 사라진 이유
연속 학습 실험은 구조 차이를 가장 선명하게 보여줍니다. 1차원 회귀 문제에서 봉우리 다섯 개를 한꺼번에 주지 않고 하나씩 순서대로 학습시켰더니, MLP는 새 봉우리를 배울 때마다 앞서 배운 봉우리를 뭉개버렸습니다. KAN은 이전 구간을 그대로 유지했습니다.
원인은 스플라인의 국소성입니다. 샘플 하나는 자기 근처의 격자 계수 몇 개만 건드리고 멀리 있는 계수는 손대지 않습니다. 반면 ReLU나 tanh처럼 입력 전 구간에 걸쳐 작동하는 활성화 함수를 쓰면, 한 곳의 변화가 통제 없이 멀리까지 번져 이미 저장된 정보를 망가뜨립니다. 저자들은 이 성질을 사람 뇌의 국소적 가소성에 빗대 설명합니다.
곱셈을 푸는 방식까지 보인다
해석 가능성 실험은 간단한 수식 여섯 개로 시작합니다. 그중 곱셈이 인상적입니다. 두 수를 곱하는 함수를 [2,5,1] KAN에 학습시키고 가지치기했더니 [2,2,1] 구조가 남았고, 살아남은 활성화 함수는 일차 함수와 이차 함수였습니다.
계산 그래프를 따라가면 이 모델이 곱셈을 어떻게 처리했는지 드러납니다. 두 수를 더해 제곱한 값에서 각각의 제곱을 빼는 방식, 즉 2xy = (x+y)² − (x²+y²)라는 항등식을 스스로 찾아 쓴 겁니다. 정답을 맞혔다는 사실만이 아니라 어떤 경로로 맞혔는지가 그림에 남습니다.
방향을 뒤집은 실험도 있습니다. 지금까지는 무엇이 입력이고 무엇이 출력인지 정해준 상태였는데, 실제 과학에서는 변수 여러 개를 앞에 두고 그 사이에 어떤 관계가 있는지부터 찾아야 할 때가 많습니다. 논문은 이 상황을 “모든 변수를 넣었을 때 0이 되는 식을 찾는 문제"로 바꿔 풉니다. 앞에서 본 딥마인드 사례처럼 사람이 목표 변수를 손으로 고르지 않아도 되도록 만드는 우회로입니다.
과학 데이터에서 식을 끄집어내기
물리 쪽 사례는 앤더슨 국소화입니다. 무질서한 양자계에서 전자 파동함수가 한곳에 갇히는 현상이고, 갇힌 상태와 퍼진 상태를 가르는 경계를 이동도 가장자리(mobility edge)라고 부릅니다. 연구진은 준주기 구조를 가진 격자 모형 세 가지(모자이크 모형, 일반화·수정 오브리-앙드레 모형)에서 나온 수치 데이터를 KAN에 학습시켰습니다.
일반화 오브리-앙드레 모형에서는 KAN이 뽑아낸 식이 이미 알려진 정답 공식과 거의 일치했습니다. 더 복잡한 수정 모형에서는 사람이 “이 활성화 함수는 이런 형태일 것"이라는 가설을 주고 KAN이 빠르게 검증하는 방식으로 식을 정리했습니다. 모델이 답을 통째로 내놓는 그림이 아니라, 사람이 가설을 던지고 모델이 확인해주는 협업에 가깝습니다.
매듭 이론에서도 결과는 같은 방향입니다. 17개 불변량을 입력으로 넣은 KAN은 시그니처가 주로 자오선 이동(meridinal translation)의 실수부와 허수부에 좌우된다는 딥마인드의 결론을 다시 찾아냈습니다. 그것도 파라미터 200개짜리 모델로 말이죠.
10배 느린 학습
논문이 스스로 밝힌 가장 큰 약점은 속도입니다. 같은 파라미터 수를 기준으로 KAN 학습은 MLP보다 대략 10배 느립니다. 저자들은 “효율을 열심히 최적화하지 않았다"고 인정하면서, 근본적인 한계라기보다 앞으로 개선할 엔지니어링 문제로 본다고 적었습니다. 빠른 학습이 필요하면 MLP를 쓰라는 문장도 논문에 그대로 있습니다.
논문은 느린 원인을 따로 분석하지 않지만, 구조만 놓고 보면 짐작은 갑니다. 연결선마다 스플라인 계수가 여러 개 붙고, 입력값이 어느 격자 구간에 들어가는지 따져 기저 함수를 계산해야 합니다. 행렬 곱 한 번으로 끝나는 MLP와 달리 GPU가 좋아하는 연산 형태에서 멀어지는 셈입니다. 여기까지는 논문에 적힌 설명이 아니라 구조를 보고 붙인 추측입니다.
구조를 모른 채 시작한다
두 번째 약점은 구조를 미리 모른다는 점입니다. 앞의 성능 수치 상당수는 정답에 해당하는 KAN 모양을 알고 있다는 전제에서 나왔습니다. 실제 문제에서는 콜모고로프-아르놀트 표현이 존재하는지도, 존재한다면 어떤 모양인지도 알 수 없습니다. 특수 함수 실험이 이 문제를 정면으로 다루긴 하지만, 결국 여러 구조를 시도해 파레토 프런티어(파라미터 수와 오차를 함께 놓고 가장 유리한 조합만 이은 경계선)를 그리는 방식입니다.
세 번째는 비교의 공정성입니다. 미분방정식 실험을 두고 저자들이 직접 짚습니다. 정답이 기호로 떨어지는 수식이면 그런 표현에 강한 KAN에 유리한 비교일 수 있다고요. KAN과 MLP가 잘 다루는 함수 부류가 서로 다르며 그 경계는 아직 정리되지 않았다는 것이 논문의 결론입니다.
범위도 논문이 직접 못 박았습니다. 2025년 2월 수정본(v5)의 초록은 KAN이 MLP를 앞선다는 주장을 “작은 규모의 AI + 과학 과제"로 한정합니다. 모든 딥러닝 모델의 MLP를 갈아 끼우자는 제안이 아니라는 뜻입니다.
그래서 어디에 쓸까
논문이 부수 효과로 언급하는 쓸모가 하나 있습니다. 특수 함수를 KAN으로 압축해보니, 고차원 룩업 테이블을 1차원 테이블 여러 개로 쪼갤 가능성이 보인다는 겁니다. 추론할 때 덧셈 몇 번이 더 붙는 정도의 부담으로 메모리를 크게 아낄 수 있다는 관측입니다. 정확도 경쟁과는 별개의 실용적인 갈래입니다.
논문 마지막에는 언제 KAN을 쓸지 정리한 결정 트리가 실려 있습니다. 요약하면 이렇습니다.
| 상황 | 논문의 권고 |
|---|---|
| 학습을 빨리 끝내야 한다 | MLP |
| 해석 가능성이나 정확도가 더 중요하고, 느린 학습을 감수할 수 있다 | KAN을 시도 |
| 대상 문제 | 작은 규모의 AI + 과학 과제 |
여기부터는 논문에 없는 관측입니다. 이 논문이 겨눈 자리는 대형 언어모델의 트랜스포머 블록이 아니라, 데이터가 적고 답이 식으로 정리되는 연구실 문제입니다. 물성 데이터에서 경험식을 뽑거나, 시뮬레이션 결과를 축약한 대리 모델을 만들거나, 실험 변수 사이의 관계를 눈으로 확인해야 하는 작업이라면 파라미터 200개짜리 모델이 30만 개짜리보다 낫다는 결과가 그대로 쓸모가 됩니다.
크기가 작다는 점도 실무에서는 그 자체로 의미가 있습니다. 파라미터 200개짜리 모델은 노트북에서도 몇 초 만에 돌고, 결과를 그림으로 확인한 뒤 조건을 바꿔 다시 돌려보는 반복이 가능합니다. 학습이 10배 느리다는 단점은 원래 모델이 작을 때 체감이 크게 줄어듭니다.
반대로 대규모 사전학습에 이 구조를 얹으면 어떻게 되는지는 이 논문이 답하지 않습니다. 표에 정리한 승부는 대부분 변수 두세 개짜리 문제에서 나온 것이고, 논문 자신도 적용 범위를 그렇게 한정했습니다. KAN을 범용 MLP 대체재로 읽으면 논문이 하지 않은 주장을 얹는 셈입니다.
원문 출처
- 논문: KAN: Kolmogorov-Arnold Networks
- 저자: Ziming Liu, Yixuan Wang, Sachin Vaidya, Fabian Ruehle, James Halverson, Marin Soljačić, Thomas Y. Hou, Max Tegmark (MIT, 캘리포니아공대, 노스이스턴대, NSF 인공지능·기초상호작용 연구소)
- arXiv:2404.19756 — 초판 2024년 4월 30일, 최종 수정본(v5) 2025년 2월 9일
- 게재: ICLR 2025 채택
- 구현체: 논문에 공개된 pykan (
pip install pykan)