문서를 매번 찾아 넣지 않고, 모델이 문서 내용을 미리 익혀서 답하게 만드는 학습법이다.
무엇이 문제였나 — 기존 RAG 방식은 질문할 때마다 관련 문서를 찾아 프롬프트에 넣지만, 이 방식은 느리거나 보안상 곤란할 수 있다. 어떻게 풀었나 — IAR은 먼저 문서 내용을 여러 방식으로 익히게 하고, 그다음 질문에 답하는 법을 가르친 뒤, 마지막으로 원래 모델과 섞어 일반 대화 능력을 되살린다. 그래서 뭐가 좋아졌나 — 실험에서는 문서를 보여주지 않고 질문만 던져도 더 잘 답했고, 일반 문제풀이와 지시 따르기 성능도 Vanilla SFT보다 많이 회복했다.
시험 전에 교과서를 그냥 한 번 읽는 대신, 빈칸 채우기·요약에서 원문 복원하기·읽기 과제처럼 여러 방식으로 공부한다. 그 뒤 실제 문제 풀이 연습을 하고, 마지막에는 예전에 잘하던 과목을 잊지 않도록 원래 실력과 새로 익힌 내용을 적당히 섞는 방식에 가깝다.
논문 정보
Qian Kou, Xiaofeng Shi, Xiaosong Qiu, Hua Zhou et al. · Beijing Academy of Artificial Intelligence (BAAI) · Preprint · 2025
왜 중요한가
회사 내부 규정, 의료 기록, 법률 문서처럼 매번 검색해 보여주기 어렵거나 민감한 문서를 모델이 미리 익혀두면, 추론 때 검색 없이 빠르게 답할 수 있다. 논문의 핵심은 단순히 더 외우게 하는 것이 아니라, 문서 답변 능력과 일반 대화 능력 사이의 균형점을 고르는 절차를 제시한 데 있다.
핵심 지표
| 지표 | 값 | 설명 |
|---|---|---|
| 평균 도메인 정확도 향상 | +3.6pp | 주 비교에서 IAR vs Vanilla SFT, 8개 데이터셋-모델 조합 평균 |
| 평균 일반 성능 향상 | +12.1pp | IFEval·MMLU·MSBench 평균, IAR vs Vanilla SFT |
| Qwen3-4B CC 도메인 정확도 | 50.5% | Vanilla SFT 42.4% 대비 +8.1pp, 검색 없이 질문만 입력한 평가 |
| Qwen3 스케일링 일반 성능 복원 | +14.9~24.1pp | CC의 Qwen3-8B/14B/32B에서 IAR이 Best IA 대비 회복한 평균 일반 성능 폭 |
어떻게 동작하나
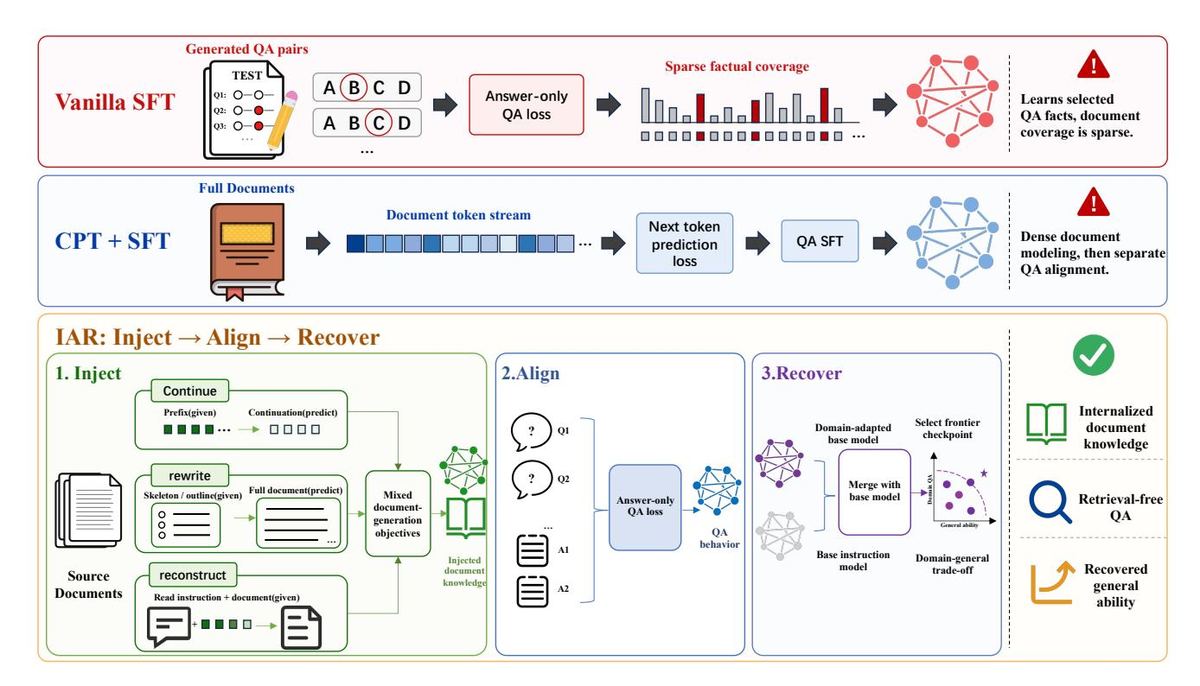
IAR은 검색 없이 고정된 문서 컬렉션을 모델 파라미터로 내재화하기 위한 3단계 사후학습 프레임워크다. 1단계 Inject는 raw CPT처럼 문서 스트림을 그대로 예측하지 않고, continuation·rewrite·instruction-formatted reconstruction의 세 가지 지도 목표로 문서를 변환해 어시스턴트 정답 토큰에만 손실을 적용한다. 2단계 Align은 Inject 체크포인트에 answer-only QA SFT를 수행해 질문-답 인터페이스를 학습한다. 3단계 Recover는 학습된 IA 체크포인트와 원래 instruction 모델을 SLERP·Task Arithmetic·TIES·DARE의 고정 12개 후보로 병합한다. 선택은 검증 분할에서 Vanilla SFT 대비 도메인 정확도 허용 범위와 일반 성능 guardrail을 통과한 후보 중 도메인 정확도를 1차 기준으로 고르는 방식이며, 최종 보고는 held-out test에서 수행한다. 평가 시점에는 검색 문서 없이 질문만 입력하고, 도메인 QA 정확도와 IFEval·MMLU·MSBench를 함께 측정한다.
 IAR 전체 파이프라인: Vanilla SFT / CPT+SFT 대비 3단계 분해 구조
문서 노출·QA 정렬·능력 복원을 하나의 SFT로 합치지 않고 별도 단계로 나눈 것이 핵심이다.
핵심 수식:
\mathcal{L}_{\text{inj}} = \sum_{m \in \mathcal{M}} \pi_m \, \mathbf{E}_{(u,y) \sim \mathcal{D}_m} [\ell_\theta(u,y)]
원문에서 \ell_\theta(u,y) = -\frac{1}{|y|}\sum_{t=1}^{|y|}\log p_\theta(y_t \mid u, y_{<t}) 이다. \pi_m은 혼합 샘플링과 길이 필터링 뒤의 실제 표본 비율이며 자유로운 loss coefficient가 아니다. system/user prompt 토큰은 마스킹되고 assistant target y에만 손실이 적용된다.
한계와 주의할 점
- 최적 Inject 레시피는 모델군·코퍼스별로 달라 보편적 단일 처방이 아니다. CC에서는 Llama·Phi가 1:1:2, Qwen3-4B·SmolLM3가 1:1:1이 best IA였고, CCI에서는 Qwen3-4B만 1:0:0이 가장 높았다.
- Qwen3-4B CCI처럼 base instruction 모델이 이미 70.6% 도메인 정확도를 보이는 경우 Inject의 추가 도메인 이득은 작다. 이 행은 큰 신규 지식 주입보다 높은 사전 성능을 보존하며 일반 성능을 회복한 boundary case로 읽어야 한다.
- IAR이 모든 baseline과 모든 지표를 일관되게 이기지는 않는다. LoRA와 FAPM은 일부 일반 지표에서 더 높고, Phi CCI는 IAR이 Vanilla SFT보다 IFEval·MSBench는 높지만 도메인 정확도와 MMLU는 낮다.
- 모든 보고 checkpoint는 단일 training run이며 다중 seed 평균이 아니다. 고정 seed가 run 추적성은 높이지만 분산 GPU 학습과 judge API의 반복 실행 견고성을 보장하지 않는다.
- 도메인 QA 평가는 adaptive LLM-as-judge 패널에 의존한다. 전체 242,255 valid record에서 first-two exact agreement .707, binary Cohen’s kappa .691, third-judge trigger rate .297로 평가 불확도를 함께 고려해야 한다.
- 베이스 모델이 이미 해당 도메인을 강하게 알고 있는 경우 Inject 단계의 추가 도메인 이득이 작아질 수 있다. Qwen3-4B CCI가 대표 사례다.
- Recover에서 선택된 병합 운영점은 반드시 최고 도메인 정확도 checkpoint가 아니다. 도메인 정확도만 절대 우선인 서비스에서는 Best IA 대비 작은 손실을 감수해야 할 수 있다.
- CPT+SFT는 Base checkpoint 존재 여부와 initialization에 민감하다. Phi-4-mini는 대응되는 non-instruction Base release가 없어 main CPT+SFT 비교가 불가능하다.
- Qwen3-8B/14B/32B scaling ablation은 선택된 TIES d=0.3 Recover 설정은 남아 있지만 Inject/Align training arguments와 node provenance가 archive에 없어 cross-corpus scaling law로 해석하기 어렵다.
시스템 적용 아이디어
논문의 기법을 비슷한 구조를 가진 시스템에 옮길 때의 적용 지점이다.
Retrieval-free 장기 기억을 위한 구조적 문서 주입 레시피
장기 기억을 retrieval 없이 파라미터로 들고 있어야 하는 에이전트의 사후학습 단계에서, raw CPT 손실 대신 continuation, rewrite, instruction-formatted reconstruction의 세 가지 지도 목표로 문서 컬렉션을 변환한다. 시스템·유저 토큰을 마스킹하고 assistant target에만 손실을 주며, 레시피 혼합은 모델과 코퍼스별로 검증 분할에서 선택한다. 논문에서 Best IA는 Vanilla SFT 대비 CC에서 +2.8, +7.7, +5.3, +4.7pp, CCI에서 +5.6, +6.1, +0.4, +2.3pp의 pre-recovery 도메인 이득을 보였다.
적용 지점 — 에이전트 장기 기억의 retrieval-free 문서 내재화 단계
기대 효과 — Best IA 기준 8개 main setting 모두에서 Vanilla SFT보다 높은 pre-recovery 도메인 정확도
사후 모델 병합 그리드로 도메인-일반 운영점 선택
도메인 파인튜닝 후 바로 배포하지 않고, SLERP t∈{0.2,0.3,0.4}, Task Arithmetic w∈{0.3,0.5,0.7}, TIES d∈{0.3,0.5,0.7}, DARE dr∈{0.1,0.3,0.5}의 고정 12개 병합 후보를 원래 instruction 모델과 만든다. 검증 분할에서 도메인 feasibility, 평균 일반 성능, 3개 일반 지표 중 2개 이상 guardrail을 통과한 후보만 남기고 domain-primary ranking으로 선택한다. Qwen3-8B/14B/32B CC에서는 TIES d=0.3이 Best IA 대비 도메인을 0.71.1pp만 낮추면서 평균 일반 성능을 14.924.1pp 회복했다.
적용 지점 — 에이전트 모델 체크포인트 배포 정책 및 가중치 병합 단계
기대 효과 — Qwen3-8B/14B/32B CC에서 평균 일반 성능 +14.9~+24.1pp, 도메인 손실 1.1pp 이내
프루닝 대신 모델 병합으로 파인튜닝 망각 복구
도메인 파인튜닝 후 일반 능력 망각을 복구할 때 FAPM 같은 pruning-based recovery와 TIES·Task Arithmetic 같은 weight-space merge를 분리해 비교한다. 원문 표 21·22·24·25에서 FAPM은 여러 일반 지표가 높지만 도메인 정확도를 크게 잃는 경우가 많다. 예를 들어 CC Llama에서 Vanilla-FAPM은 domain 22.3%이고 IAR은 36.5%이며, CC Phi에서도 Vanilla-FAPM 17.1% 대비 IAR 34.1%다. 따라서 문서 내재화와 일반 능력을 함께 봐야 하는 시스템에서는 pruning 결과를 일반 성능만으로 채택하면 안 된다.
적용 지점 — 도메인 파인튜닝 후 망각 복구 단계의 checkpoint 선택
기대 효과 — CC Llama 기준 도메인 정확도 +14.2pp (IAR 36.5% vs Vanilla-FAPM 22.3%)
단계별 도입 로드맵
| 단계 | 목표 | 액션 | 기대 효과 |
|---|---|---|---|
| Phase 1 | 검증 분할·체크포인트 인프라와 Inject 데이터 파이프라인 구축 | 1) 경계 있는 문서 컬렉션에서 self-contained QA를 만들고 train/validation/test 분할 고정 2) Continuation·Rewrite·Instruction-formatted reconstruction 3종 Inject 데이터 생성 3) Vanilla SFT 기준점의 D(v), I(v), M(v), B(v), G(v) 확보 4) SLERP·Task Arithmetic·TIES·DARE의 고정 12개 Recover 후보 생성 코드 준비 | 도메인-일반 운영점 선택을 검증 단계에서 끝낼 수 있는 재현 가능한 실험 기반 확보 |
| Phase 2 | 3단계 IAR 학습 및 운영점 선택 | 1) Inject 단계: 모델·코퍼스별로 1:1:1, 1:1:2, 1:0:0 등 후보 레시피를 검증 2) Align 단계: Inject 체크포인트에서 answer-only QA SFT 3) Recover 단계: 12개 병합 후보를 만들고 D(c)≥D(v)-1pp, G(c)≥G(v), 일반 지표 2개 이상 guardrail 조건으로 후보 필터링 4) 비지배 후보 중 domain-primary 규칙으로 최종 checkpoint 선택 | Vanilla SFT 대비 도메인 정확도와 일반 성능을 함께 고려한 운영점 확보 |
| Phase 3 | 예산 매칭 진단 및 운영 확장 | 1) BudgetMatch 대조군으로 IAR 이득 중 token budget 효과와 staged exposure 효과를 분리 2) Qwen3-8B/14B/32B 같은 확장 실험에서는 run provenance를 보존해 재현성 강화 3) adaptive 3-judge panel, raw vote 저장, 2,000회 bootstrap interval로 평가 신뢰도 관리 | 모델 크기·토큰 예산 변화에 대한 결론을 더 신뢰성 있게 확장하고 운영 환경의 평가 불확도를 추적 |
원문 PDF: 2026-08-22-inject-align-recover-staged-post-training-for-retrieval-free-document-kn.pdf