핵심 요약
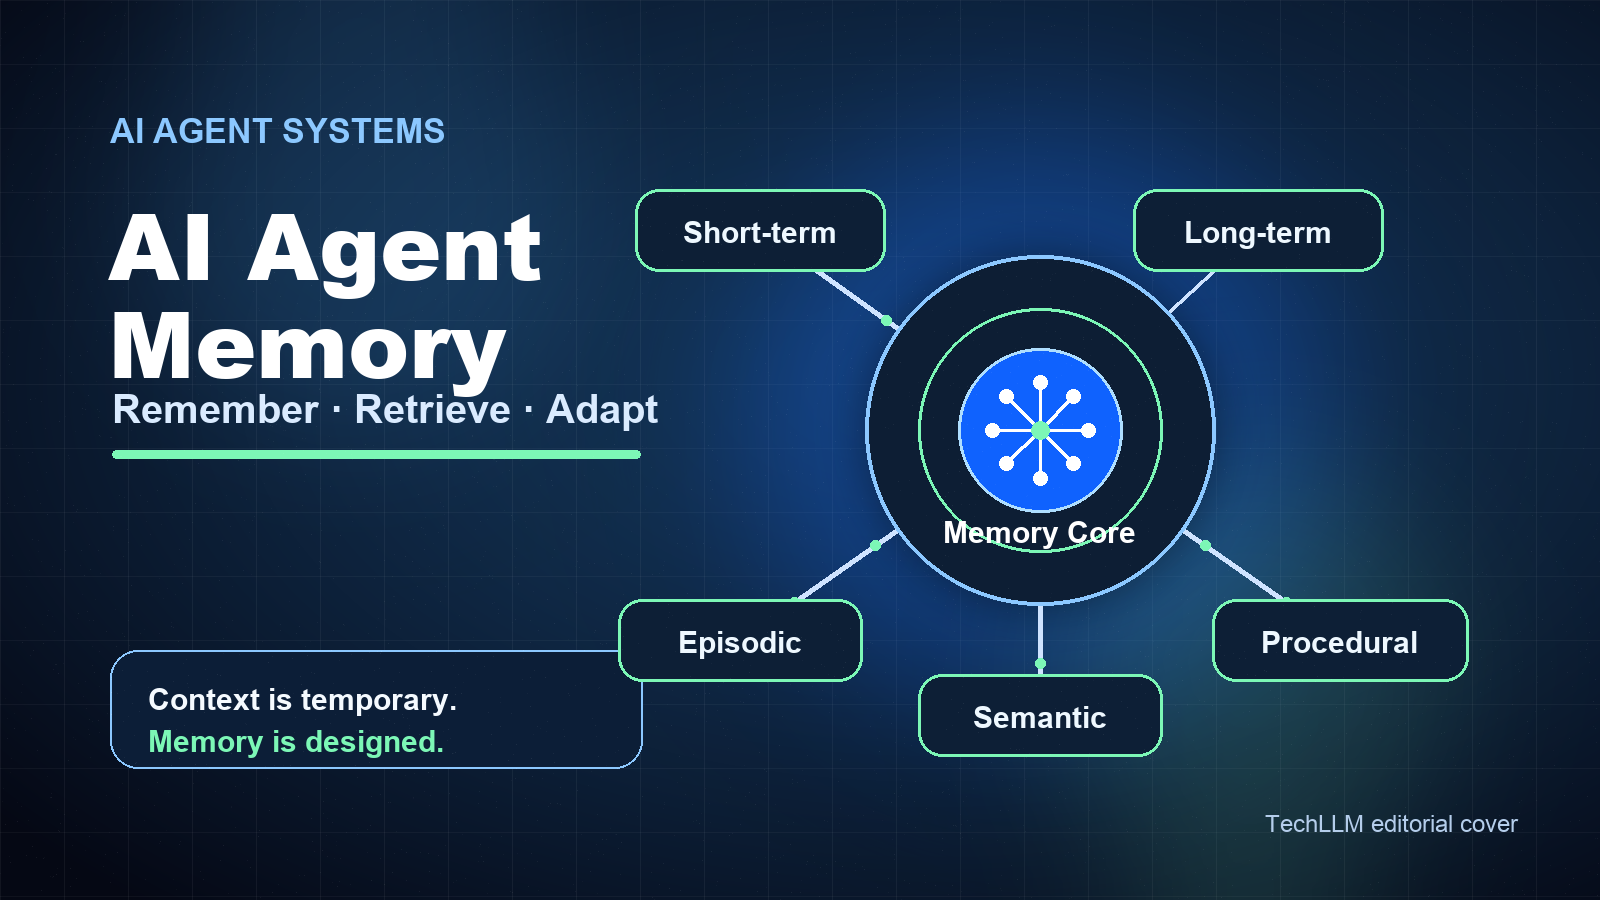
IBM의 **“What is AI agent memory?”**는 AI 에이전트가 왜 메모리를 필요로 하는지 설명합니다. 핵심은 단순합니다. 에이전트가 매번 새로운 요청처럼 반응하면, 복잡한 업무를 이어서 처리하거나 사용자에게 맞춰 적응하기 어렵습니다. 진짜 일하는 에이전트가 되려면 과거 상호작용, 행동 결과, 업무 규칙을 저장하고 다시 불러올 수 있어야 합니다.
LLM은 혼자서 기억하지 못한다
많은 사람이 LLM이 대화를 “기억한다”고 느끼지만, 모델 자체가 영구 기억을 갖는 것은 아닙니다. 세션 안의 문맥은 컨텍스트 윈도우에 잠시 들어갈 뿐이고, 장기적으로 유지하려면 별도의 메모리 시스템이 필요합니다.
IBM은 단순한 reflex agent는 메모리가 없어도 된다고 설명합니다. 예를 들어 기본 온도조절기는 현재 온도만 보고 켜고 끄면 됩니다. 하지만 smart thermostat은 과거 사용 패턴을 기억해 더 효율적으로 작동합니다. AI 에이전트도 마찬가지입니다. 현재 입력만 처리하는 수준을 넘어서려면 기억이 필요합니다.
에이전트 메모리의 다섯 가지 유형
첫째, short-term memory는 현재 대화나 최근 입력을 유지하는 기억입니다. 챗봇이 같은 세션 안에서 앞선 대화를 참고해 자연스럽게 답하는 데 필요합니다. 보통 rolling buffer나 context window로 구현됩니다.
둘째, long-term memory는 세션을 넘어 유지되는 기억입니다. 사용자 선호, 과거 상담 이력, 추천 기록처럼 장기간 개인화와 학습이 필요한 정보가 여기에 해당합니다. 데이터베이스, 지식 그래프, 벡터 임베딩과 함께 쓰이는 경우가 많습니다.
셋째, episodic memory는 특정 과거 사건을 기억하는 방식입니다. 예를 들어 금융 상담 에이전트가 사용자의 과거 투자 선택과 그 결과를 기억하고, 다음 조언에 반영하는 식입니다.
넷째, semantic memory는 사실, 정의, 규칙 같은 구조화된 지식을 저장합니다. 법률, 의료, 기업 지식 관리처럼 도메인 전문성이 필요한 에이전트에 중요합니다.
다섯째, procedural memory는 특정 작업을 수행하는 절차와 행동 패턴을 저장합니다. 매번 처음부터 추론하지 않고, 학습된 절차를 따라 빠르게 실행하게 해줍니다.
구현에서 중요한 것은 “많이 저장”이 아니다
메모리 설계의 어려움은 저장 공간이 아니라 검색 효율입니다. 모든 데이터를 저장하면 응답이 느려지고, 잘못된 기억이 섞이면 품질이 떨어집니다. 그래서 에이전트 메모리는 무엇을 저장할지, 언제 요약할지, 어떤 정보를 검색할지, 오래된 정보를 어떻게 정리할지까지 함께 설계해야 합니다.
IBM은 LangChain, LangGraph 같은 프레임워크와 벡터 데이터베이스, RAG가 메모리 구현에 자주 쓰인다고 설명합니다. RAG는 장기 메모리에서 관련 정보를 찾아 현재 응답에 넣는 대표적인 방식입니다.
실무자가 볼 포인트
AI 에이전트 메모리는 “채팅 기록 저장”보다 훨씬 넓은 개념입니다. 고객지원 에이전트라면 이전 문의, 선호 채널, 해결된 문제를 기억해야 합니다. 개발 에이전트라면 코드베이스 규칙, 과거 PR 피드백, 테스트 실패 패턴을 기억해야 합니다. 업무 자동화 에이전트라면 승인 절차와 예외 처리 규칙을 기억해야 합니다.
다만 메모리는 강력한 만큼 위험합니다. 개인정보, 권한, 삭제 요청, 감사 로그, 잘못된 기억의 수정까지 고려해야 합니다. 좋은 에이전트 메모리는 오래 기억하는 시스템이 아니라, 필요한 것을 정확히 기억하고 필요 없어진 것은 지울 수 있는 시스템입니다.
결론
AI 에이전트의 성능은 모델만으로 결정되지 않습니다. 같은 모델이라도 어떤 기억을 저장하고, 어떤 순간에 꺼내고, 어떻게 검증하느냐에 따라 결과가 달라집니다.
겅허게 말하면, 앞으로의 에이전트 경쟁력은 “얼마나 똑똑한가”보다 무엇을 기억하고, 무엇을 잊을 수 있는가에서 갈릴 가능성이 큽니다.