개요
Gradium이 실시간 음성번역 모델 두 개를 한꺼번에 내놨습니다. 음성을 받아 다른 언어 텍스트로 돌려주는 stt-translate, 음성을 받아 다른 언어 음성으로 돌려주는 s2s-translate. 둘 다 브라우저에서 바로 스트리밍됩니다. 회사 주장으로는 OpenAI gpt-realtime-translate보다 정확도-지연 균형이 좋고, Gemini의 gemini-3.5-live-translate보다도 정확도에서 앞섭니다. 게다가 GPT에는 없는 출력 음성 선택과 보이스 클로닝까지 붙였습니다.
핵심 요약
- 두 모델, 한 번에:
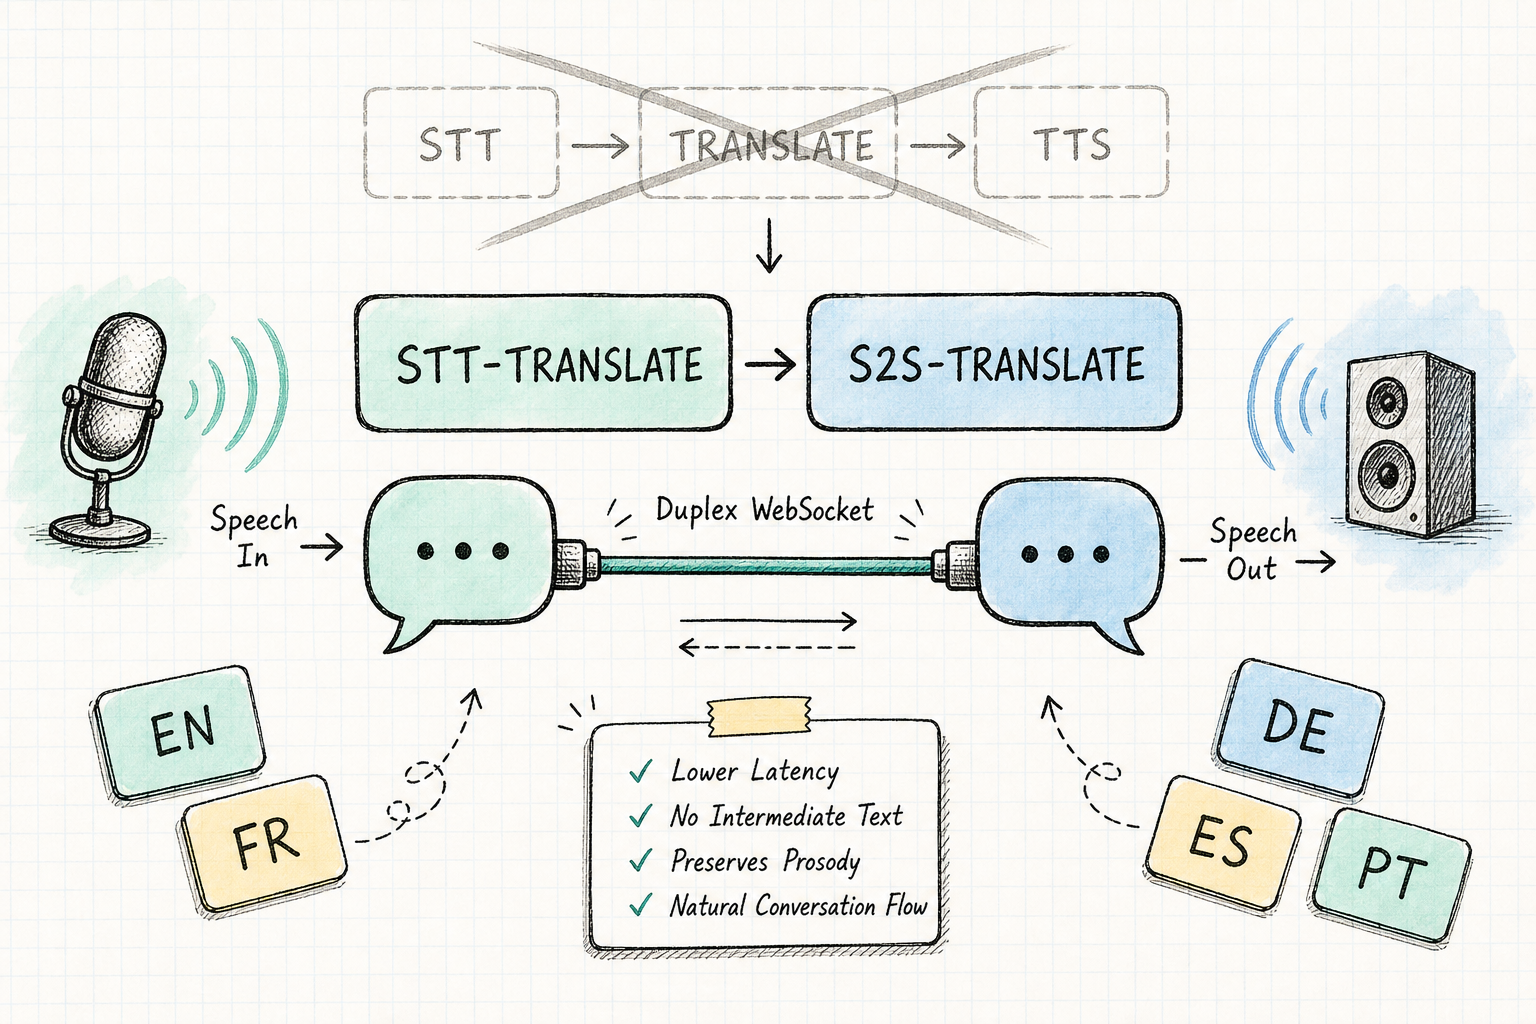
stt-translate(음성→텍스트)와s2s-translate(음성→음성). 영어·프랑스어·독일어·스페인어·포르투갈어 등 5개 언어, 양방향 20개 페어. - 3-모델을 2-모델로: 기존 STT → 텍스트 번역 → TTS 3단 캐스케이드 중 중간 텍스트 번역 단계를 빼고, 전사와 번역을 단일 모델 한 번에 처리합니다.
- 지연 3.0초:
s2s-translate평균 3.0초. GPT의 3.6초보다 짧고, Gemini의 2.9초에 거의 붙었습니다. - 정확도 우위: BLEU에서는 GPT·Gemini 둘 다 이겼고, MetricX에서는 GPT와 비슷, Gemini보다는 앞섭니다.
- 음성 자유도: 카탈로그에서 출력 보이스를 고르거나, 본인 목소리를 직접 클로닝해 쓸 수 있습니다. GPT에는 없는 기능입니다.
stt-translate — 전사와 번역을 한 번에
stt-translate는 한 언어로 들어온 음성을 다른 언어 텍스트로 바꿔 줍니다. 지원 언어는 EN, FR, DE, ES, PT 다섯 개. 이 안에서는 어느 방향이든 가능해서 총 20개 페어가 나옵니다.
설계의 핵심은 단계 압축입니다. 보통은 음성을 일단 같은 언어 텍스트로 받아 적은 다음, 별도의 번역 모델로 다시 돌립니다. Gradium은 이걸 한 모델 안에서 한 번에 처리합니다. 중간 전사 결과를 기다릴 필요도, 다른 시스템으로 넘기는 핸드오프도 없습니다.
기반은 Hibiki-Zero 프레임워크. 강화학습으로 저지연과 정확도를 같이 최적화한다고 회사는 설명합니다. 파이프라인의 움직이는 부품 수 자체가 줄었다는 뜻입니다.
s2s-translate — 음성에서 음성까지
s2s-translate는 한 언어 음성을 다른 언어 음성으로 바꿔 줍니다. stt-translate에 Gradium TTS 모델을 묶어 하나의 서비스로 노출한 구조입니다.
WebSocket으로 오디오를 흘려 넣으면, 합성된 출력 음성과 번역 자막이 동시에 돌아옵니다. 직접 STT와 TTS를 붙이거나 연결 두 개를 따로 관리할 필요가 없습니다. 서버가 파이프라인을 돌리고 결과만 스트리밍해 줍니다.
입력은 24kHz / 16-bit signed mono PCM, 출력은 48kHz / 16-bit signed mono PCM이 기본입니다. WAV, Opus, mu-law, A-law도 함께 지원합니다.
품질은 어떻게 쟀나 — BLEU와 MetricX
번역 품질은 한 숫자로 끝나지 않아서, Gradium은 두 지표를 같이 보고합니다.
- BLEU(Papineni 외)는 오랫동안 써 온 기계번역 표준입니다. 모델 출력과 사람 번역의 n-gram 겹침을 잽니다. 0~100, 높을수록 좋습니다. 빠르고 재현 가능하지만 표면 어휘만 보기 때문에, 단어 선택이 다르면 의미가 맞아도 점수가 깎입니다.
- MetricX(Juraska 외, Google)는 학습된 신경망 지표입니다. 사람이 매길 점수를 예측합니다. 오류 점수라 낮을수록 좋고, 사람 판단과 더 잘 맞습니다.
두 지표가 잡는 실패가 다릅니다. BLEU는 단어 단위의 충실도, MetricX는 의미 단위의 적절성을 봅니다.
벤치마크 — 숫자로 보는 차이
Gradium은 일상 대화(업무, 여행, 날씨)에 가까운 자체 음성 데이터셋에서 비교했습니다. Gemini 대비 BLEU와 MetricX 모두 앞섰고, GPT 대비 BLEU에서 앞서며 MetricX에서는 비슷합니다.
| 항목 | Gradium | gpt-realtime-translate | gemini-3.5-live-translate |
|---|---|---|---|
| 평균 지연(전 페어) | 3.0초 | 3.6초 | 2.9초 |
| BLEU(높을수록 좋음) | 두 모델 모두 우위 | 낮음 | 낮음 |
| MetricX(낮을수록 좋음) | GPT와 동급, Gemini보다 우위 | Gradium과 동급 | 오류 더 큼 |
| 출력 음성 선택 | 가능(카탈로그) | 불가 | 미언급 |
| 보이스 클로닝 | 가능 | 불가 | 미언급 |
| 언어 / 페어 | 5개 / 20개 | 미언급 | 미언급 |
정확도(BLEU·MetricX)는 stt-translate 기준, 지연은 s2s-translate 전 구간 기준입니다. 깔끔한 압승은 아닙니다. Gemini는 살짝 더 빠르고, Gradium은 더 정확하면서 음성 제어까지 얹은 그림입니다.
왜 모델 2개가 3개를 이기나
표준 음성-대-음성 스택은 모델이 세 개입니다. STT → 텍스트-대-텍스트 번역 → TTS. 매 단계가 별도 추론 호출이고, 처리 시간과 핸드오프가 더해집니다.
Gradium은 두 개입니다. stt-translate가 전사와 번역을 한 모델에서 처리하면서, 텍스트-대-텍스트 번역 단계 자체가 사라집니다. 임계 경로에서 모델 한 개와 그 지연·핸드오프가 같이 빠지는 것입니다. 같은 품질대에서 끝-대-끝 경로가 짧아지는 이유입니다.
숫자가 그 설계를 뒷받침합니다. s2s-translate의 전 페어 평균 지연은 3.0초. GPT의 3.6초보다 짧고, Gemini의 2.9초에 거의 붙었습니다.
어디에 쓸 만한가
- 라이브 더빙·로컬라이제이션: 발표자 목소리를 한 번 클로닝해 두면, 프랑스어 키노트를 그 사람 목소리 그대로 스페인어로 옮길 수 있습니다.
- 다국어 음성 상담 에이전트: 콜을
s2s-translate로 흘려보내면, 영어 상담원에게는 독일어 고객의 말이 영어로 들리고, 답변은 다시 독일어로 돌아갑니다. - 실시간 회의: WebSocket으로 마이크 오디오를 보내면, 참가자마다 자기 언어로 번역된 음성과 자막을 동시에 받습니다.
- 접근성·자막: 음성 합성이 필요 없는 경우에는
stt-translate만 단독으로 써서 실시간 번역 자막을 띄울 수 있습니다.
몇 줄짜리 코드 예시
Python SDK는 음성을 S2S 엔드포인트로 흘려보내고, 번역 음성과 자막을 같이 돌려받습니다.
import asyncio
import numpy as np
from gradium import client as gradium_client

grc = gradium_client.GradiumClient()  # 환경변수 GRADIUM_API_KEY 사용

setup = {
    "model_name": "s2s-translate",
    "input_format": "pcm_24000",        # 24kHz 16-bit mono
    "output_format": "pcm_48000",       # 48kHz 16-bit mono
    "voice_id": "cLONiZ4hQ8VpQ4Sz",     # 대상 언어의 보이스 ID
    "stt_model_name": "stt-translate",
    "tts_model_name": "default",
    "target_language": "en",
}

with open("input_24k_mono.pcm", "rb") as f:
    pcm = f.read()

async def main() -> np.ndarray:
    audio_out: list[bytes] = []
    async with grc.s2s_realtime(wait_for_ready_on_start=True, **setup) as s2s:
        async def send_loop():
            for i in range(0, len(pcm), 1920):   # 1920바이트 = 24kHz에서 40ms
                await s2s.send_audio(pcm[i:i+1920])
            await s2s.send_eos()

        async def recv_loop():
            async for msg in s2s:
                if msg["type"] == "audio":
                    audio_out.append(msg["audio"])
                elif msg["type"] == "text":
                    print(msg["text"], end=" ", flush=True)
                elif msg["type"] == "end_of_stream":
                    break

        async with asyncio.TaskGroup() as tg:
            tg.create_task(send_loop())
            tg.create_task(recv_loop())

    return np.frombuffer(b"".join(audio_out), dtype=np.int16)

translated_pcm = asyncio.run(main())
SDK는 S2S를 세 가지 방식으로 노출합니다. 라이브 입력에는 s2s_realtime, 유한 이터러블에는 s2s_stream, 버퍼된 파일에는 s2s. 모두 wss://api.gradium.ai/api/speech/s2s 한 엔드포인트로 연결됩니다.
강점과 한계
좋은 점부터.
- 단일 패스
stt-translate로 지연 경로에서 모델 하나가 빠집니다. - BLEU에서 GPT·Gemini를 모두 앞섰습니다.
- 출력 보이스 선택과 클로닝을 같은 듀플렉스 WebSocket으로 처리합니다.
거꾸로, 짚어 둘 점도 있습니다.
- Gemini가 평균 2.9초로 살짝 더 빠릅니다.
- MetricX는 GPT와 동급일 뿐 우위는 아닙니다.
- 벤치마크가 자체 데이터셋이라 외부 재현이 제한적입니다.
실무자가 볼 핵심 포인트
- 파이프라인 단순화가 곧 지연 감소입니다. 단계 압축이 결국 끝-대-끝 시간을 줄이는 가장 확실한 방법이라는 점을 다시 보여 줍니다.
- 언어 커버리지는 EN·FR·DE·ES·PT 5개입니다. 한국어·일본어가 필수인 서비스라면 지금은 후보에서 빠집니다. 영-유럽어 페어 중심 서비스라면 바로 검토할 가치가 있습니다.
- 보이스 클로닝이 차별점입니다. 동일 화자 목소리로 다국어 콘텐츠를 뽑아야 하는 더빙·강연·교육 영역에서는 GPT 대비 분명한 장점입니다.
- 벤치마크는 자체 데이터셋입니다. 도입 전에는 본인 도메인 음성으로 BLEU와 MetricX를 직접 재 보는 게 안전합니다.
- 연결은 듀플렉스 WebSocket 하나입니다. STT와 TTS를 따로 묶고 동기화하던 코드가 통째로 사라지므로, 기존 음성 에이전트의 운영 비용이 눈에 띄게 줄어듭니다.
브라우저 데모는 gradium.ai/translate에서 바로 돌려볼 수 있고, API 문서에 통합 가이드가 정리돼 있습니다.