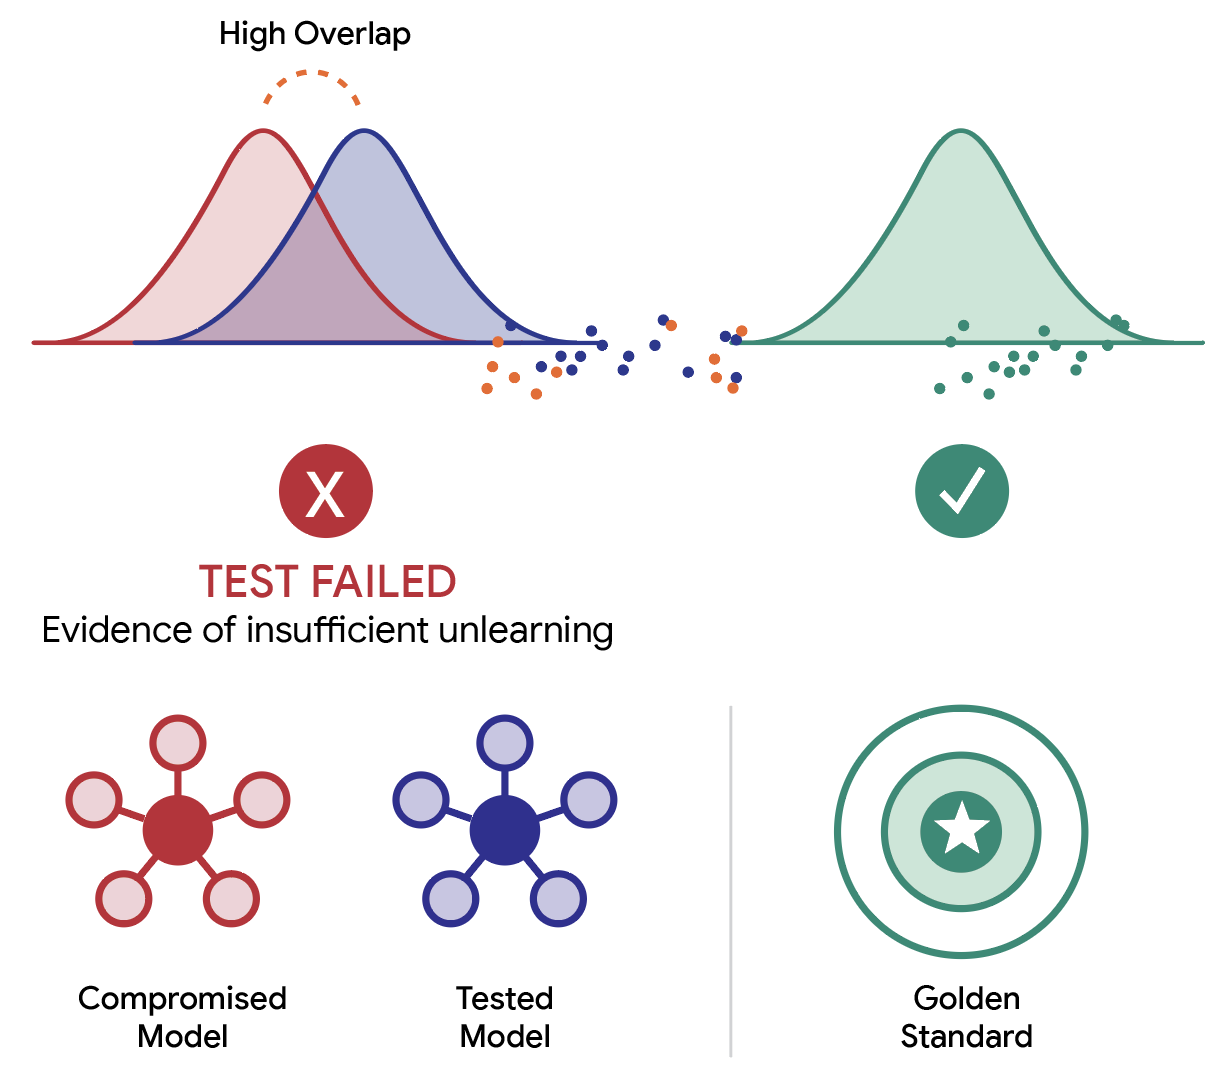
GDPR의 ‘잊혀질 권리’ 요청이 떨어지면 엔지니어 입장은 간단치 않습니다. 모델을 처음부터 다시 학습시키자니 비용이 만만치 않고, 일부만 잊게 만들었다고 주장하더라도 그 말이 사실인지 어떻게 증명할까요. 구글 리서치가 6월 10일 공개한 새 연구는 바로 이 ‘증명’ 문제를 정면으로 다룹니다. AISTATS 2026에서 발표된 Regularized f-Divergence Kernel Tests는, 모델 내부를 들여다보지 않고도 언러닝이 정말 일어났는지 통계적으로 가려내는 감사 도구입니다.
핵심 요약
- 머신 언러닝 감사에서 흔히 쓰던 **두 표본 검정(two-sample test)**은 모델이 커질수록 통계적 검정력이 떨어지고, 안전한 모델까지 위반으로 잡아내는 거짓 양성 문제를 안고 있습니다.
- 구글 팀은 **f-divergence 계열(카이제곱·KL·하키스틱 등)**과 커널 정규화를 묶어, 분포 차이를 종류별로 민감하게 잡아내는 적응형 검정 프레임워크를 제안했습니다.
- 핵심 트릭은 세 표본 상대 거리 검정입니다. 의심되는 모델이 ‘안전하게 재학습한 모델’과 ‘오염된 원본 모델’ 중 어디에 더 가까운지를 보면, 재학습 차이에서 오는 거짓 양성을 깔끔하게 우회할 수 있습니다.
- 실험에서 하키스틱 기반 검정은 차분 프라이버시 위반을 기존 기법(DP-Auditorium) 대비 훨씬 적은 샘플로 잡아냈고, 상대 거리 검정은 가지치기·SSD 같은 근사 언러닝 기법의 실패를 분명히 드러냈습니다.
- 표본 크기에 상관없이 거짓 양성은 이론적으로 통제되고, 샘플이 늘수록 거짓 음성 위험은 0으로 수렴한다는 보장도 함께 증명됐습니다.
왜 기존 도구는 충분하지 않은가
머신 언러닝의 감사자는 보통 모델 내부도, 원본 학습 데이터도 보지 못합니다. 모델에 질문을 던지고 답을 받아 통계로 따져보는 게 거의 전부죠. 이때 가장 자주 등장하는 도구가 두 표본 검정, 특히 **MMD(Maximum Mean Discrepancy)**입니다. 두 분포가 충분히 다른지 평균적인 차이로 판단하는 방법이라, 큰 그림에서의 변화는 잘 잡습니다.
문제는 그 ‘큰 그림’을 넘어서는 순간 생깁니다. 평균은 비슷한데 한 구석에 이상치가 몰려 있는 국소적 차이, 매끄럽게 이어지지 않는 불연속적 차이는 MMD가 놓치기 쉽습니다. 커널 대역폭 같은 하이퍼파라미터를 일일이 손으로 맞춰야 한다는 점도 실무에서 큰 부담이죠.
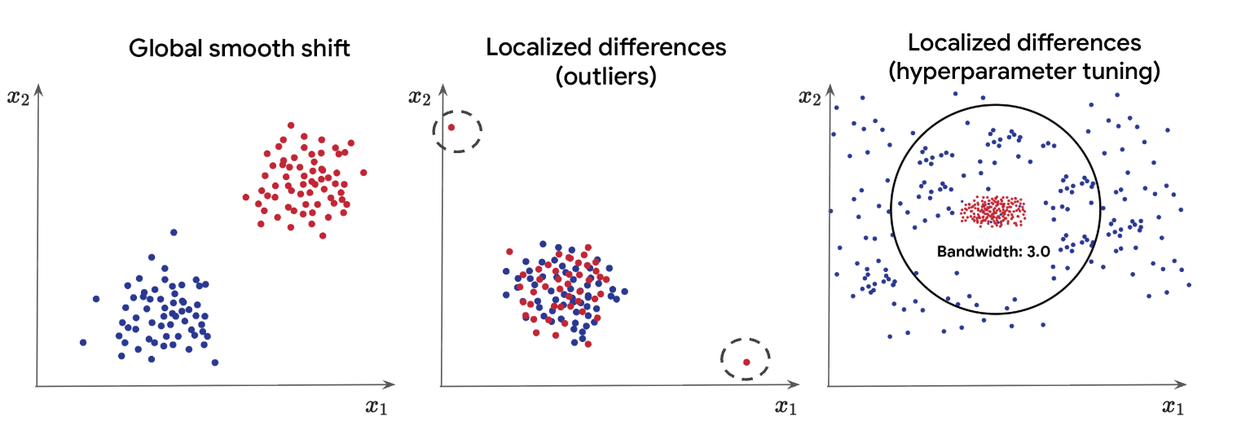
평균 이동(왼쪽)은 MMD가 잘 잡지만, 이상치(가운데)나 불연속 차이(오른쪽)는 놓치기 쉽습니다.
여기에 더 골치 아픈 함정이 있습니다. 재학습한 모델끼리도 분포가 미묘하게 다르다는 사실입니다. 같은 데이터로 학습해도 배치 크기나 셔플 순서가 달라지면 결과 분포는 살짝씩 흔들립니다. 그런데 감사자는 보통 자기 손에 있는 ‘표준’ 모델 분포와 비교하기 때문에, 안전하게 재학습한 모델조차 위반으로 판정되는 거짓 양성이 생기는 거죠.
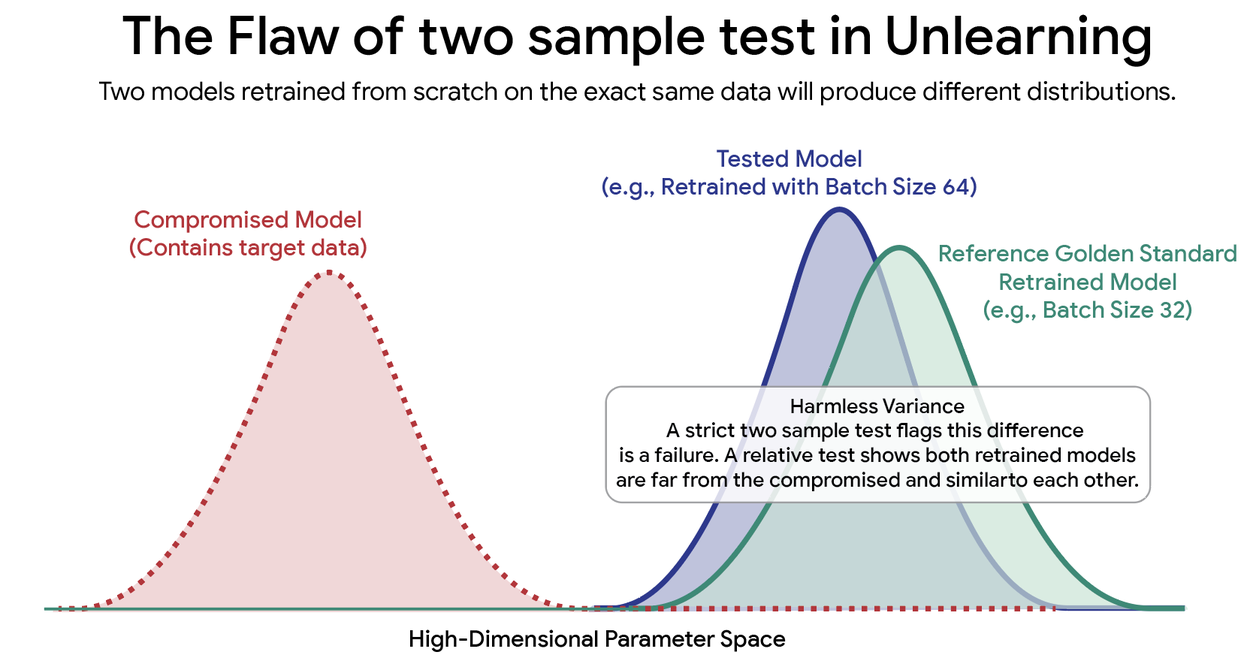
감사자가 가진 ‘표준’과 분포가 다르면, 두 표본 검정은 안전한 모델까지 위반으로 잡아버립니다.
게다가 최근 연구는 더 근본적인 사실을 짚고 있습니다. 한 번 학습된 모델이 단순한 가중치 보정만으로 데이터를 완전히 잊는 것은 불가능하다는 거죠. 처음부터 다시 학습하지 않는 한, 원래 데이터의 ‘발자국’은 반드시 어딘가에 남습니다. 그러니 ‘완벽한 재학습 등가성’을 잣대로 두 표본 검정을 돌리면, 이론적으로는 거의 항상 위반이 잡힐 수밖에 없습니다.
새 프레임워크 — ‘f-divergence + 세 표본’의 조합
구글 팀의 답은 두 갈래입니다.
첫째, 분포 차이를 종류별로 잡는 센서들을 모은다. f-divergence는 두 분포 사이의 거리를 정의하는 일반적인 함수족인데, 카이제곱과 KL은 매끄럽고 국소적인 차이에 강하고, 하키스틱 다이버전스는 차분 프라이버시 정의와 수학적으로 직접 맞물리는 형태라 프라이버시 임계값을 그대로 가져다 쓸 수 있습니다. 여기에 커널 정규화를 입혀, 고차원 데이터에서도 큰 연산 자원 없이 계산 가능한 형태로 바꿔 놓았습니다. 게다가 어떤 다이버전스와 어떤 하이퍼파라미터가 가장 안정적인지 자동으로 선택해 줘서, 손맛으로 튜닝하던 부분이 사라집니다.

세 표본 상대 거리 검정 — 의심 모델이 ‘안전 재학습’과 ‘오염 원본’ 중 어느 쪽에 더 가까운지를 본다.
둘째, ‘얼마나 다른가’가 아니라 ‘어느 쪽에 가까운가’를 묻는다. 이게 세 표본 상대 거리 검정의 핵심입니다. 의심되는 모델의 분포를 따로 떼어 절대 거리로 재는 대신, (a) 깨끗하게 재학습된 골드 스탠다드 모델, (b) 잊지 못한 오염 원본 모델 두 쪽을 함께 놓고 어디에 더 붙는지 본다는 발상이죠. 의심 모델이 오염 원본 쪽에 더 가까우면 언러닝 실패, 골드 스탠다드 쪽에 더 가까우면 통과. 이 한 줄 차이만으로 재학습 변동성에서 오는 거짓 양성이 사라집니다.
실험 결과 — 더 적은 샘플로, 더 정확하게
검정의 일반성을 확인하기 위해, 팀은 합성 벤치마크(perturbed uniforms)부터 **고에너지 물리 데이터(Expo1D)**까지 다양한 문제에서 돌려봤습니다. 표준모형 너머의 새로운 물리 현상을 찾을 때 가장 정밀한 ‘차이 탐지기’가 필요하다는 점을 떠올리면, 이건 일종의 스트레스 테스트입니다. 그다음에는 본업인 차분 프라이버시 감사와 머신 언러닝 평가에 본격 적용했습니다.
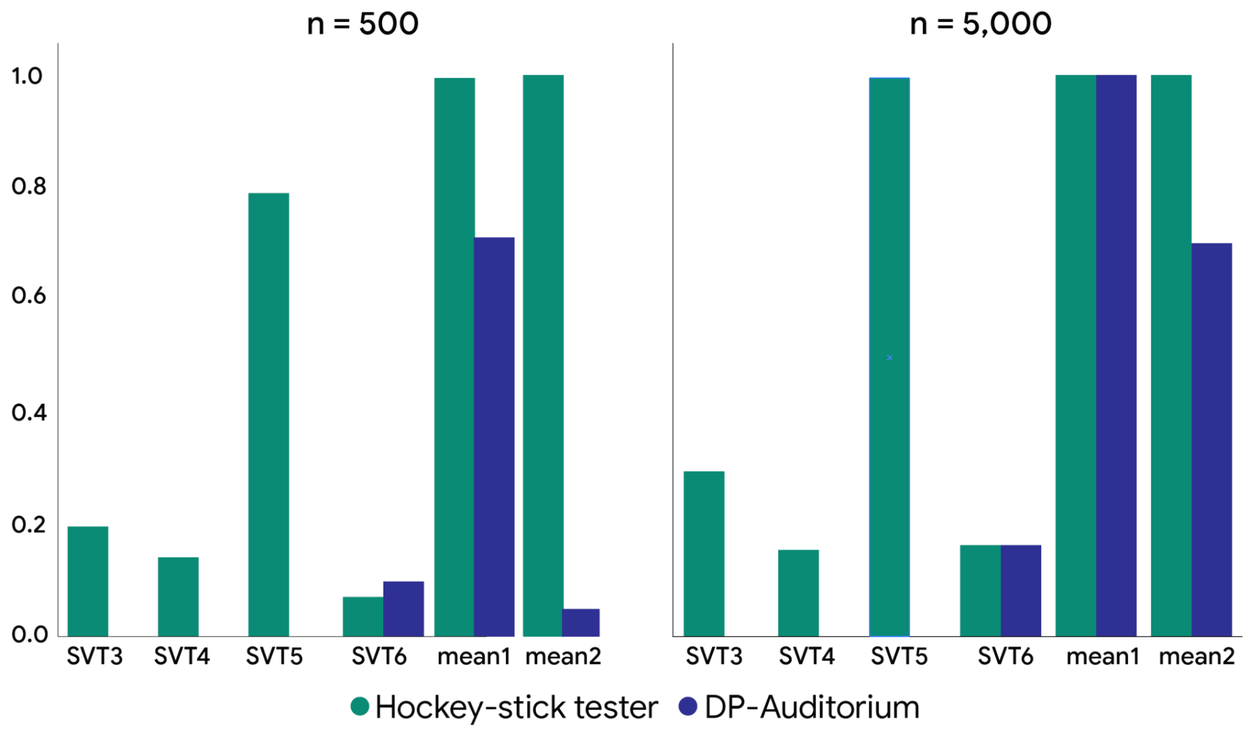
하키스틱 기반 검정(파란선)이 기존 DP-Auditorium보다 적은 샘플로 위반을 잡아냅니다.
차분 프라이버시 쪽에서 특히 인상적인 결과가 나왔습니다. 하키스틱 다이버전스 검정은 **SVT3(스파스 벡터 기법의 한 변형)**의 위반을 수천 샘플 수준에서 잡아낸 반면, 기존 DP-Auditorium은 비슷한 탐지율에 도달하는 데 수백만 샘플이 필요했습니다. 자릿수가 다르죠.
머신 언러닝 평가는 통념을 뒤집습니다. 시험대에 올린 근사 언러닝 기법들 — 파인튜닝, 가지치기(pruning), Selective Synaptic Dampening(SSD), 랜덤 라벨 — 가운데 두 표본 검정 기준을 통과한 건 단 하나도 없었습니다. 더 큰 문제는, 처음부터 다시 학습한 안전한 모델조차도 분포 차이 때문에 두 표본 검정에서는 위반으로 잡혔다는 점입니다. 반면 세 표본 상대 거리 검정은 재학습 모델을 정확하게 ‘안전’으로 분류했고, 근사 기법 중에서는 랜덤 라벨만 통과시켰습니다.
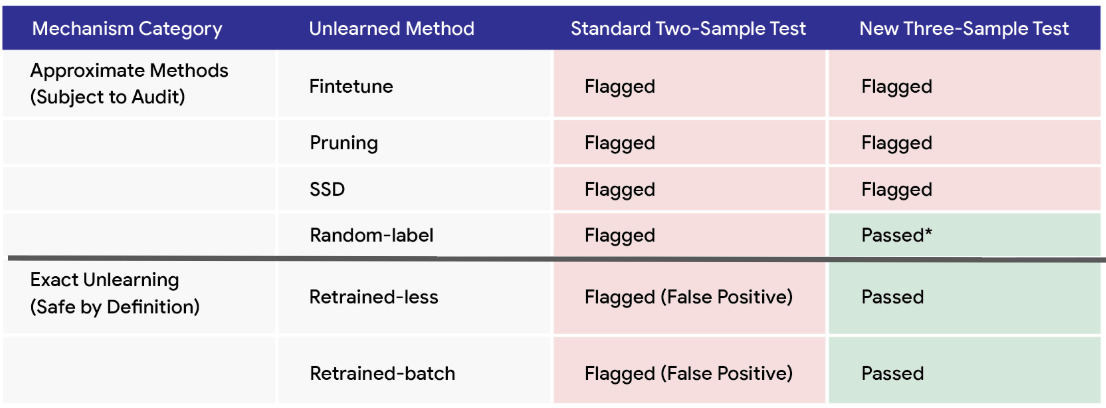
두 표본 검정은 안전한 재학습 모델까지 위반으로 잡지만, 세 표본 검정은 이를 올바르게 통과시킵니다.
원문에는 핵심 아이디어를 보여주는 짧은 애니메이션도 같이 실려 있습니다. 두 분포가 미세하게 어긋날 때 f-divergence가 어떤 식으로 ‘신호’를 키워 내는지를 시각적으로 보여주는 영상인데, 본문 도식만 보고 직관이 잘 안 잡힌다면 한 번 돌려보길 권합니다.
실무자가 볼 핵심 포인트
- 감사 도구 갈아끼우기. 차분 프라이버시 감사나 언러닝 검증 파이프라인을 운영 중이라면, MMD 기반의 두 표본 검정만 두고 있을 이유가 없습니다. 같은 위반을 자릿수 적은 샘플로 잡을 수 있다면 비용 그림이 달라집니다.
- ‘안전한 모델도 위반으로 잡힌다’를 의심하라. 기존 검정이 위반을 외쳐도, 그게 실제 데이터 누출인지 단순한 학습 변동성인지 분리해 보세요. 세 표본 상대 거리 검정이 그 분리의 출발점입니다.
- 언러닝 기법을 그대로 믿지 말 것. 가지치기·SSD·파인튜닝처럼 흔히 쓰이는 근사 기법은, 이 프레임워크 기준에서 대부분 실제로는 ‘잊지 못한’ 상태였습니다. 규제 대응용으로 도입할 거라면 자체 감사 단계를 반드시 끼우는 게 좋습니다.
- 하이퍼파라미터 손맛에서 벗어나기. 적응형 검정이 다이버전스 선택과 하이퍼파라미터 조정을 자동화해 줍니다. 운영팀이 통계 디테일까지 들고 있지 않아도 일관된 감사가 가능해진다는 의미입니다.
- 검정력 수렴 보장. 표본 수가 늘어나면 거짓 음성이 0으로 수렴한다는 이론적 보장은, ‘얼마나 모으면 충분한가’를 기획 단계에서 가늠해 보기 좋은 기준점이 됩니다.
원문 출처
- 구글 리서치 블로그 — New framework for auditing machine unlearning (Mónica Ribero, 2026-06-10)
- 논문 — Regularized f-Divergence Kernel Tests (AISTATS 2026, arxiv.org/abs/2601.19755)
- 공동 연구자 — Antonin Schrab, Arthur Gretton