핵심 요약
구글이 Gemma 4를 공개했습니다. 원문에서 가장 강조하는 표현은 “byte for byte”, 즉 같은 크기 대비 가장 강력한 오픈 모델이라는 주장입니다. 단순히 새 모델을 냈다는 소식보다 중요한 건, Gemma 4가 고급 추론과 에이전틱 워크플로우를 정면으로 겨냥했다는 점입니다.
Gemma 4가 노리는 자리
Gemma는 구글의 개방형 모델 제품군입니다. 구글에 따르면 Gemma는 첫 세대 출시 이후 4억 회 이상 다운로드됐고, 10만 개 이상의 변형 모델 생태계가 만들어졌습니다. 이번 Gemma 4는 그 흐름 위에서 Apache 2.0 라이선스로 공개됩니다.
흥미로운 점은 Gemma 4가 Gemini 3와 같은 연구·기술 기반에서 만들어졌다고 설명한다는 것입니다. Gemini가 구글의 폐쇄형 최고 성능 모델이라면, Gemma 4는 개발자가 직접 내려받아 로컬·엣지·클라우드 환경에서 다룰 수 있는 개방형 선택지에 가깝습니다.
네 가지 크기: E2B, E4B, 26B MoE, 31B Dense
Gemma 4는 네 가지 크기로 나옵니다. Effective 2B(E2B), Effective 4B(E4B), 26B MoE, 31B Dense입니다.
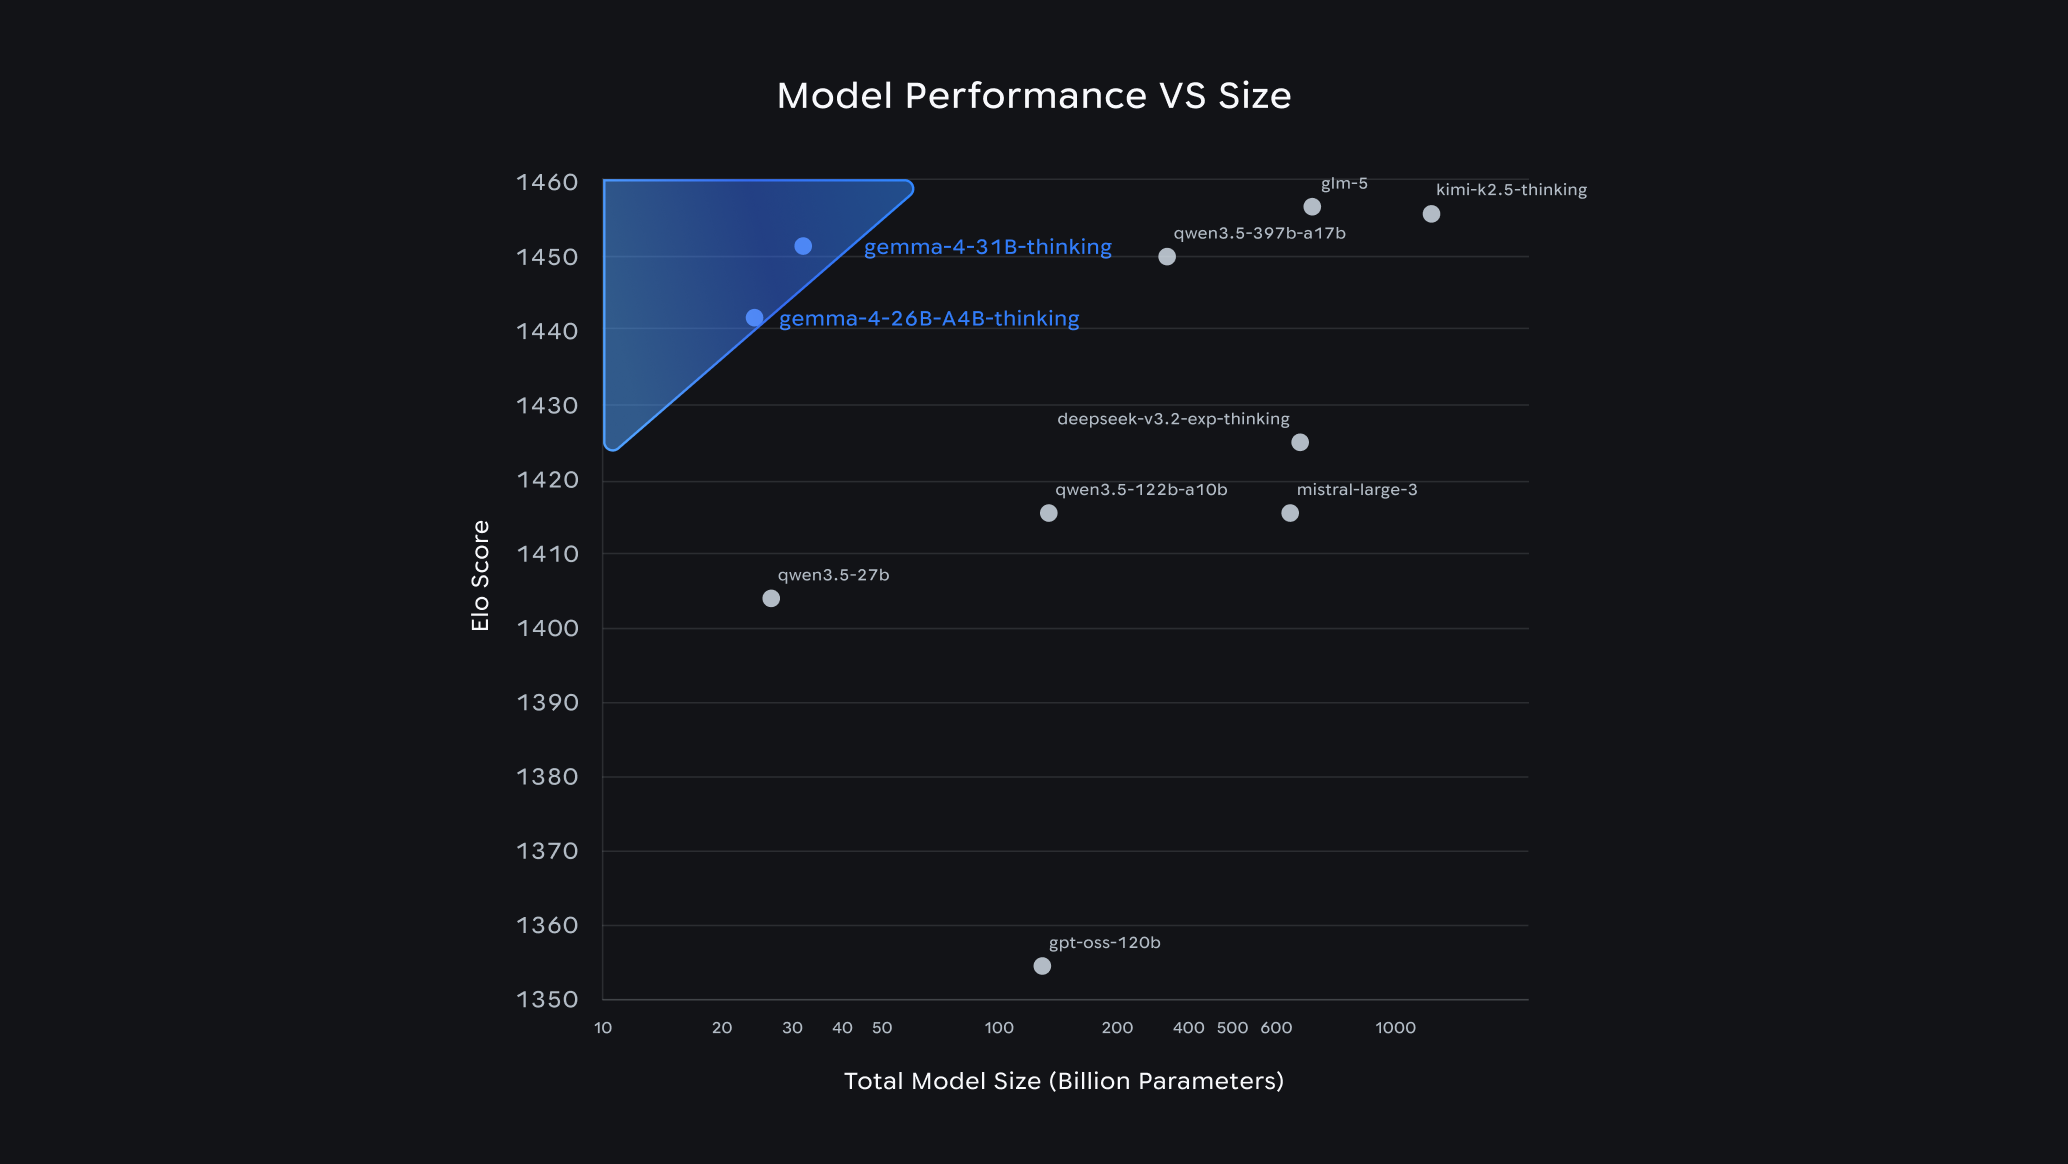
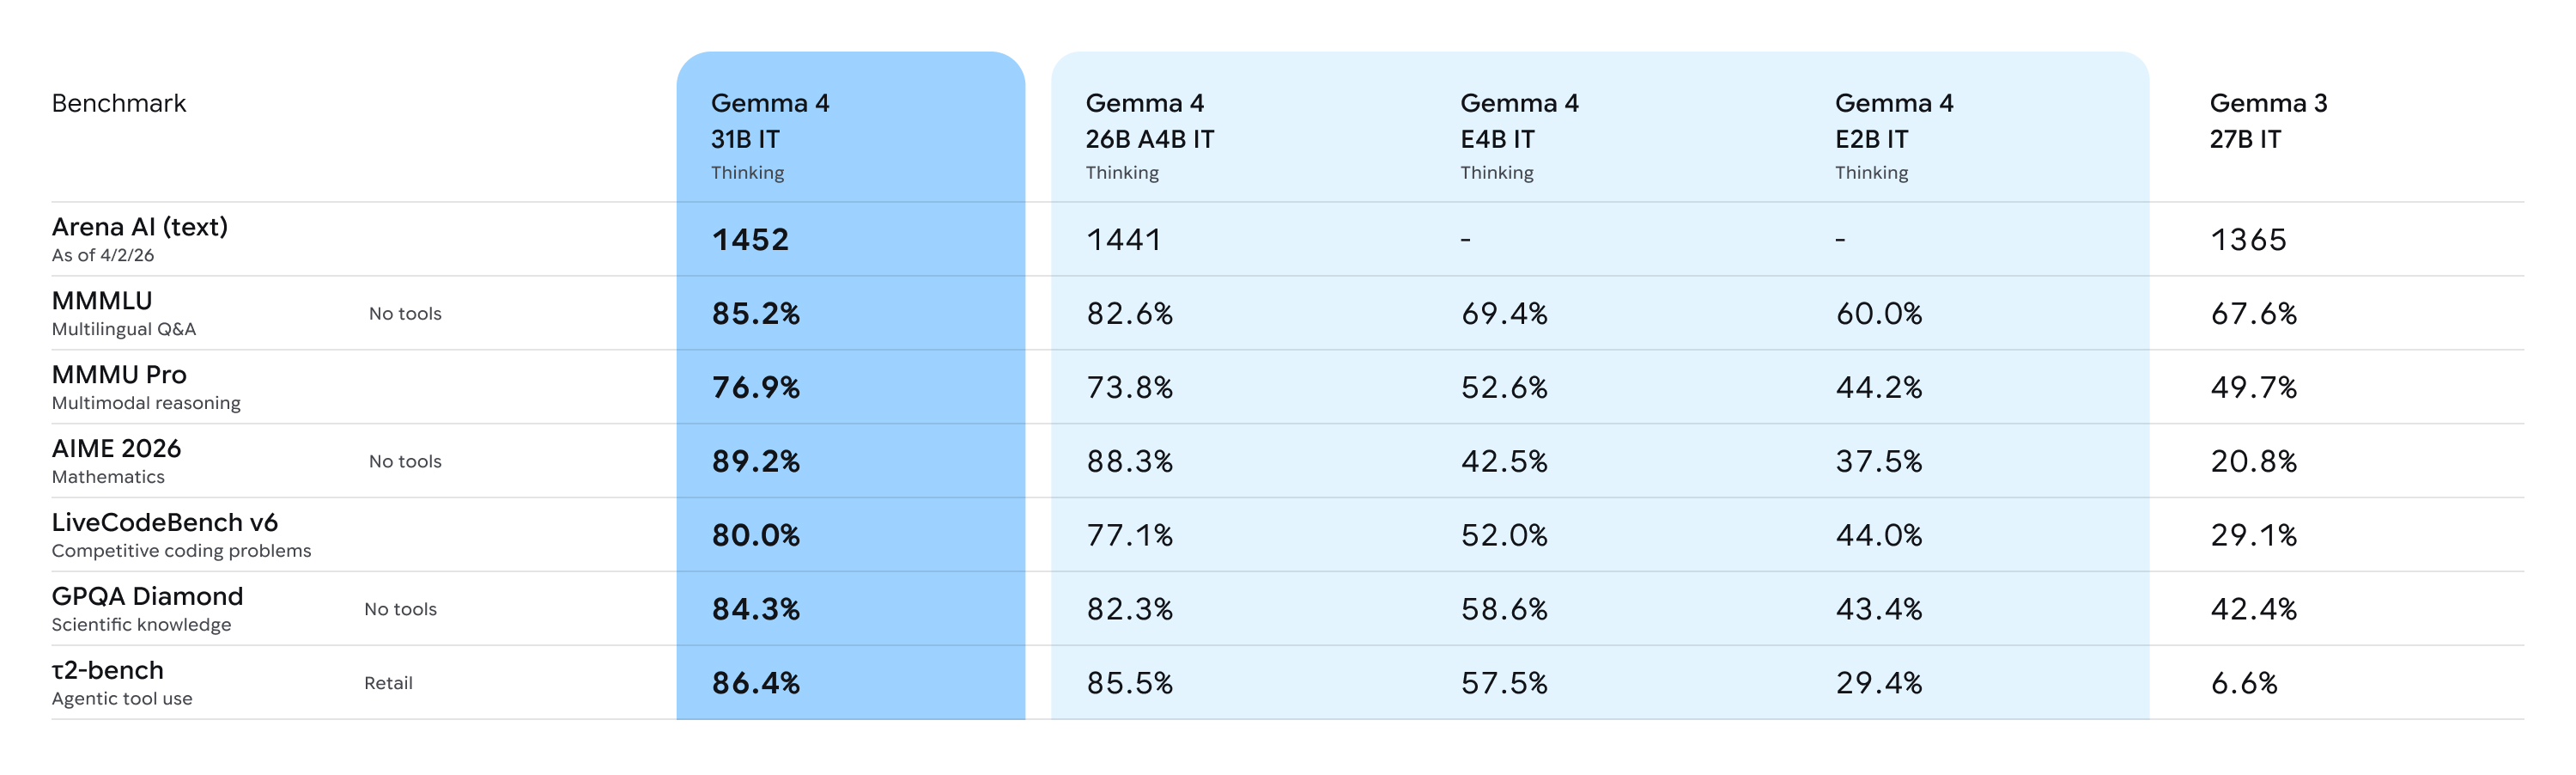
31B 모델은 Arena AI 텍스트 리더보드에서 공개 모델 기준 상위권에 올랐고, 26B MoE도 크기 대비 높은 성능을 강조합니다. 특히 26B MoE는 전체 파라미터를 모두 쓰는 대신 추론 시 약 38억 개 파라미터만 활성화해 지연 시간을 줄이는 방향입니다.
E2B와 E4B는 모바일과 IoT를 겨냥합니다. 구글은 Pixel 팀, Qualcomm, MediaTek과 협력해 온디바이스 추론, 낮은 지연 시간, 배터리 효율을 강조합니다. 휴대폰, Raspberry Pi, Jetson Orin Nano 같은 엣지 장치에서 오프라인으로 AI 기능을 돌리는 그림입니다.
에이전트 개발자를 위한 기능들
Gemma 4의 핵심은 단순 챗봇 성능이 아닙니다. 구글은 이 모델군이 다단계 계획, 논리 추론, 함수 호출, 구조화된 JSON 출력, 시스템 지시문을 지원해 자율 에이전트 개발에 적합하다고 설명합니다.
또 코드 생성도 중요한 축입니다. 로컬 워크스테이션에서 오프라인 코드 어시스턴트처럼 쓸 수 있고, 긴 컨텍스트도 지원합니다. 엣지 모델은 128K, 대형 모델은 최대 256K 컨텍스트를 제공해 긴 문서나 코드 저장소를 한 번에 다루는 사용 사례를 노립니다.
멀티모달도 포함됩니다. 모든 모델은 이미지와 비디오를 처리하고, E2B와 E4B는 오디오 입력까지 지원합니다. OCR, 차트 이해, 음성 인식처럼 실제 앱에 붙기 좋은 기능을 작은 모델군까지 확장하려는 의도가 보입니다.
실무자가 볼 포인트
이번 발표의 관전 포인트는 “큰 모델 하나”가 아니라 어디서 실행할 것인가입니다. Gemma 4는 Android 기기, 노트북 GPU, 개인 워크스테이션, H100, Google Cloud까지 이어지는 넓은 배포 선택지를 전면에 둡니다.
개발자 입장에서는 모델 선택 기준이 바뀝니다. 최고 성능만 볼 게 아니라, 지연 시간, 비용, 데이터 주권, 오프라인 동작, 파인튜닝 가능성까지 함께 봐야 합니다. 특히 Apache 2.0 라이선스는 상업적 활용과 내부 배포를 검토하는 팀에게 꽤 중요한 신호입니다.
결론
Gemma 4는 구글이 오픈 모델 시장에서 “작지만 강한 모델”과 “로컬·엣지 에이전트”를 본격적으로 밀겠다는 선언에 가깝습니다. 거대한 클라우드 모델이 모든 일을 맡는 시대에서, 필요한 장소에 맞는 모델을 고르고 조합하는 시대로 이동하고 있습니다.
겅허게 말하면, 앞으로의 AI 제품 경쟁력은 모델 크기보다 성능 대비 비용, 실행 위치, 에이전트 워크플로우 적합성에서 갈릴 가능성이 큽니다.