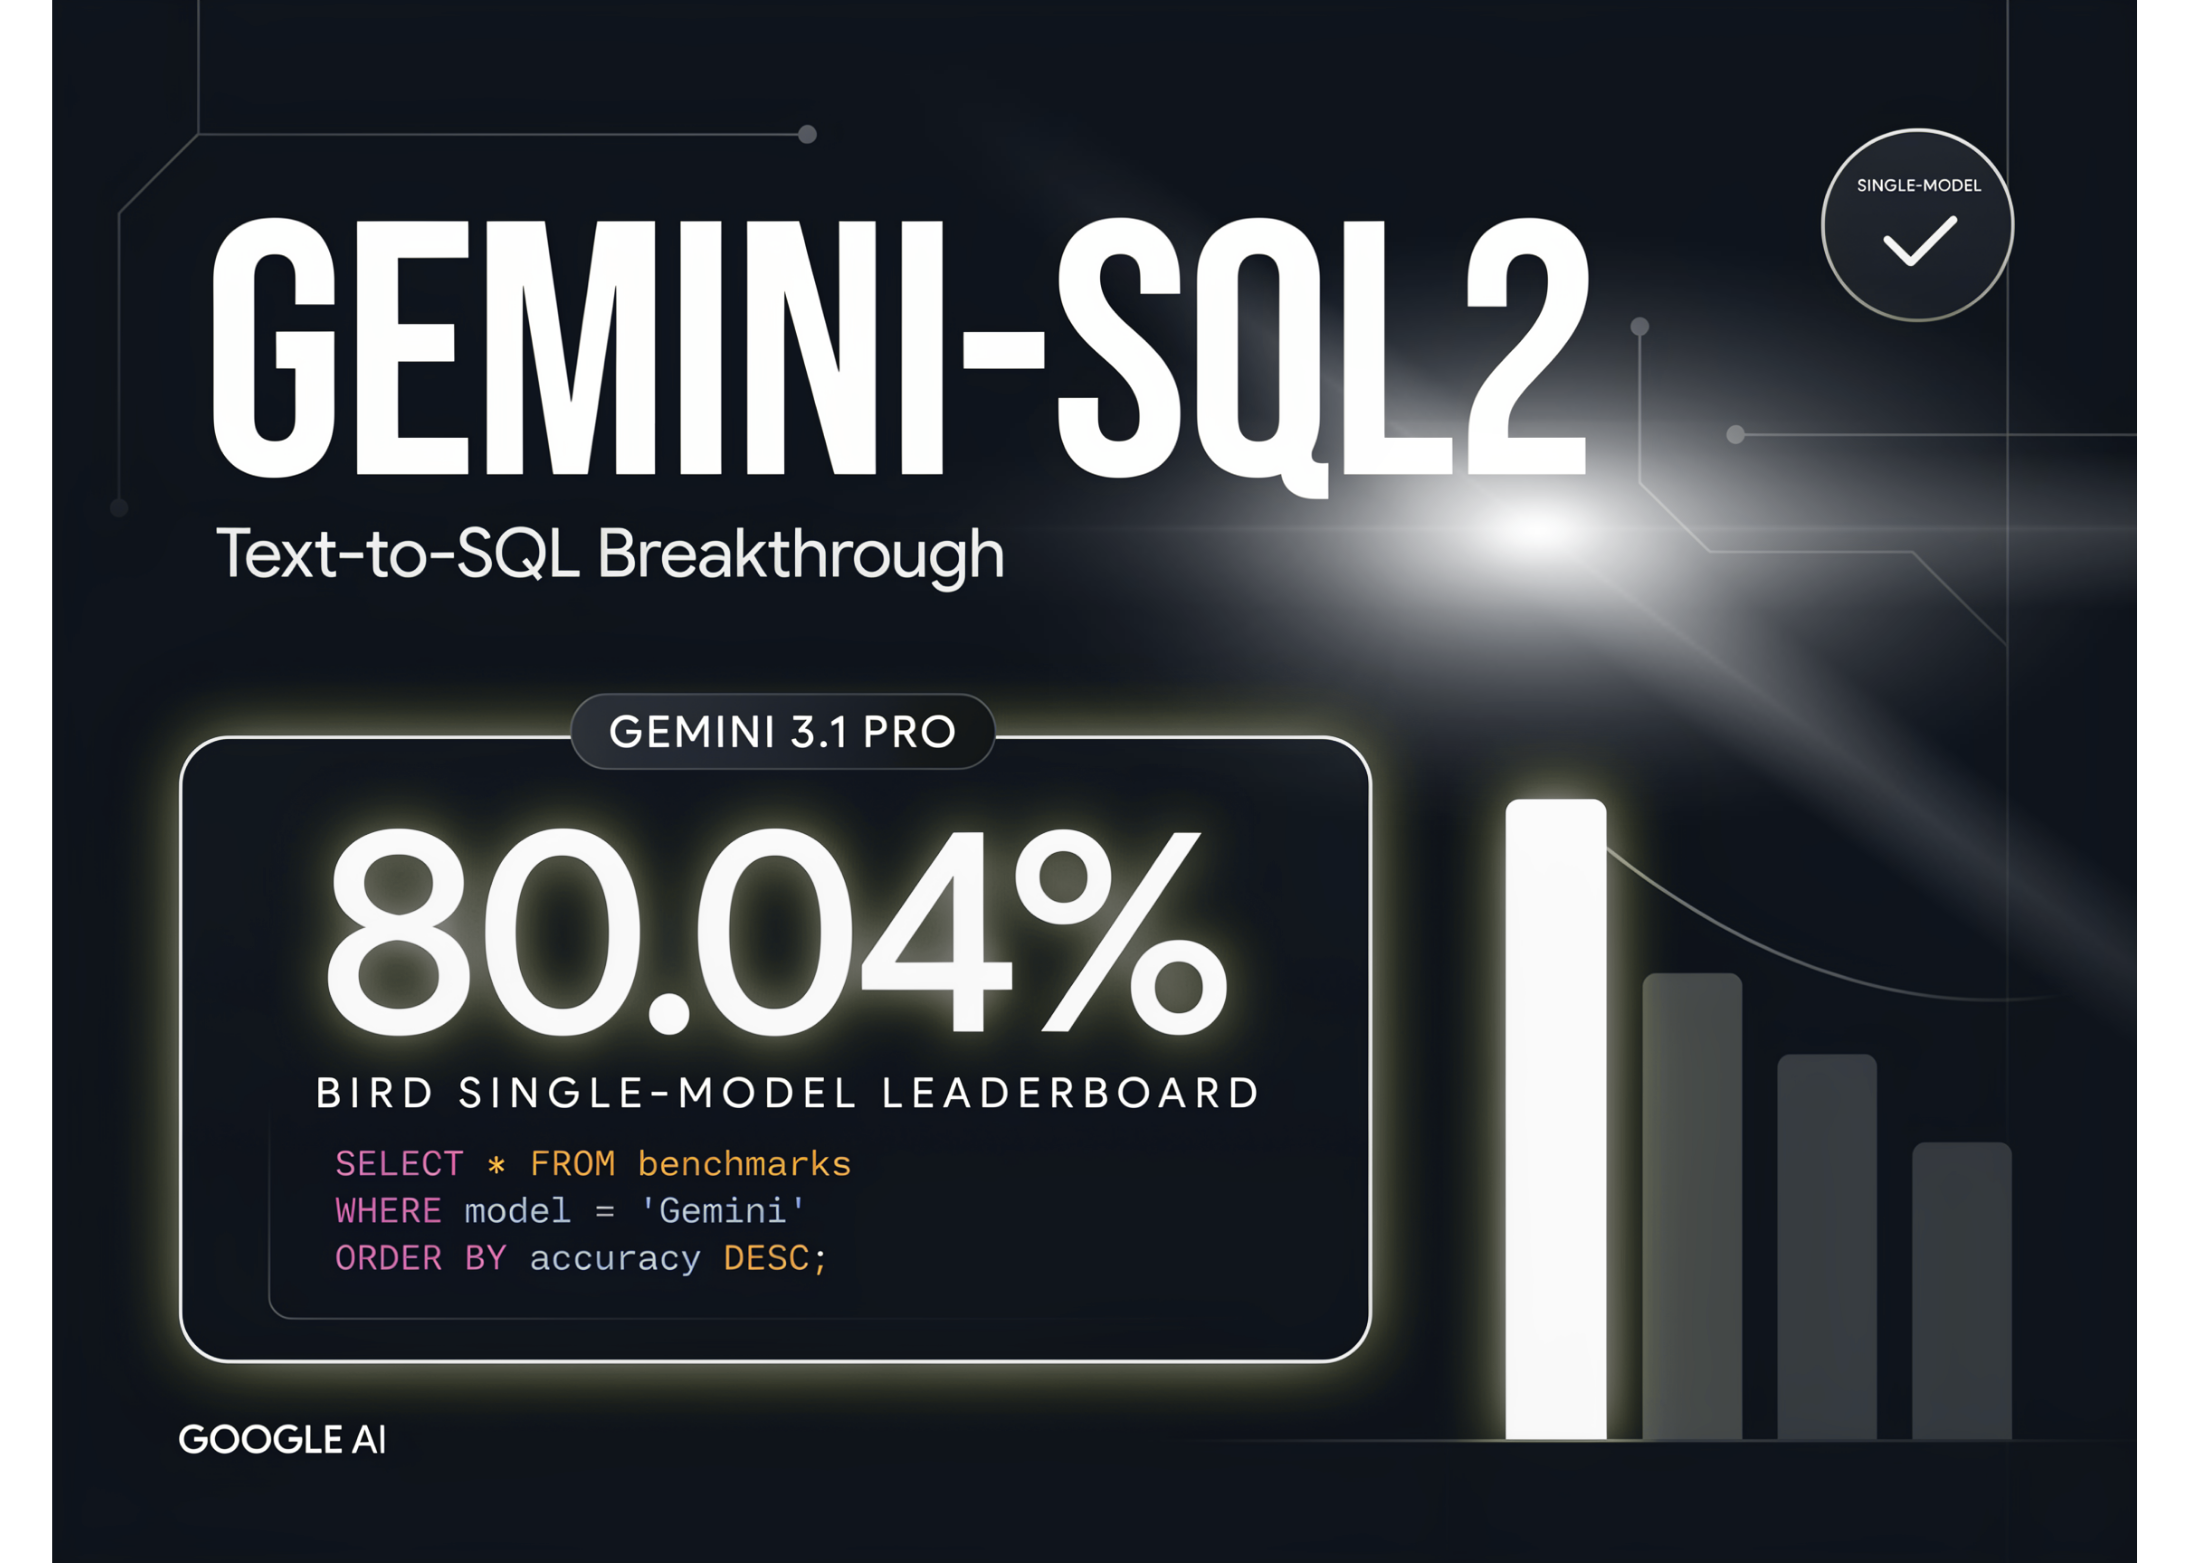
구글이 6월 12일 Gemini-SQL2를 공개했습니다. 이름만 보면 또 다른 신규 모델 같지만, 실상은 Gemini 3.1 Pro 위에 얹은 텍스트-투-SQL 전용 능력입니다. 자연어 질문을 받아 곧장 돌아가는 SQL을 만들어 주는 쪽에 무게를 둔 업데이트라고 보면 됩니다. 숫자가 화제입니다. 업계 표준 벤치마크인 BIRD의 단일 모델 부문에서 실행 정확도 80.04%를 찍었습니다. 7개월 전만 해도 같은 구글의 이전 기록이 76.13%였습니다.
핵심 요약
- Gemini-SQL2는 새 파운데이션 모델이 아니라 Gemini 3.1 Pro에 더해진 텍스트-투-SQL 능력입니다. 구글은 이걸 “execution-ready SQL queries(바로 실행 가능한 SQL)“라고 부릅니다.
- BIRD 단일 모델 리더보드에서 실행 정확도 80.04%를 기록했습니다. 사람의 92.96%와는 12.92점 차이고, 구글이 2025년 11월에 세웠던 76.13% 기록을 7개월 만에 약 4점 끌어올렸습니다.
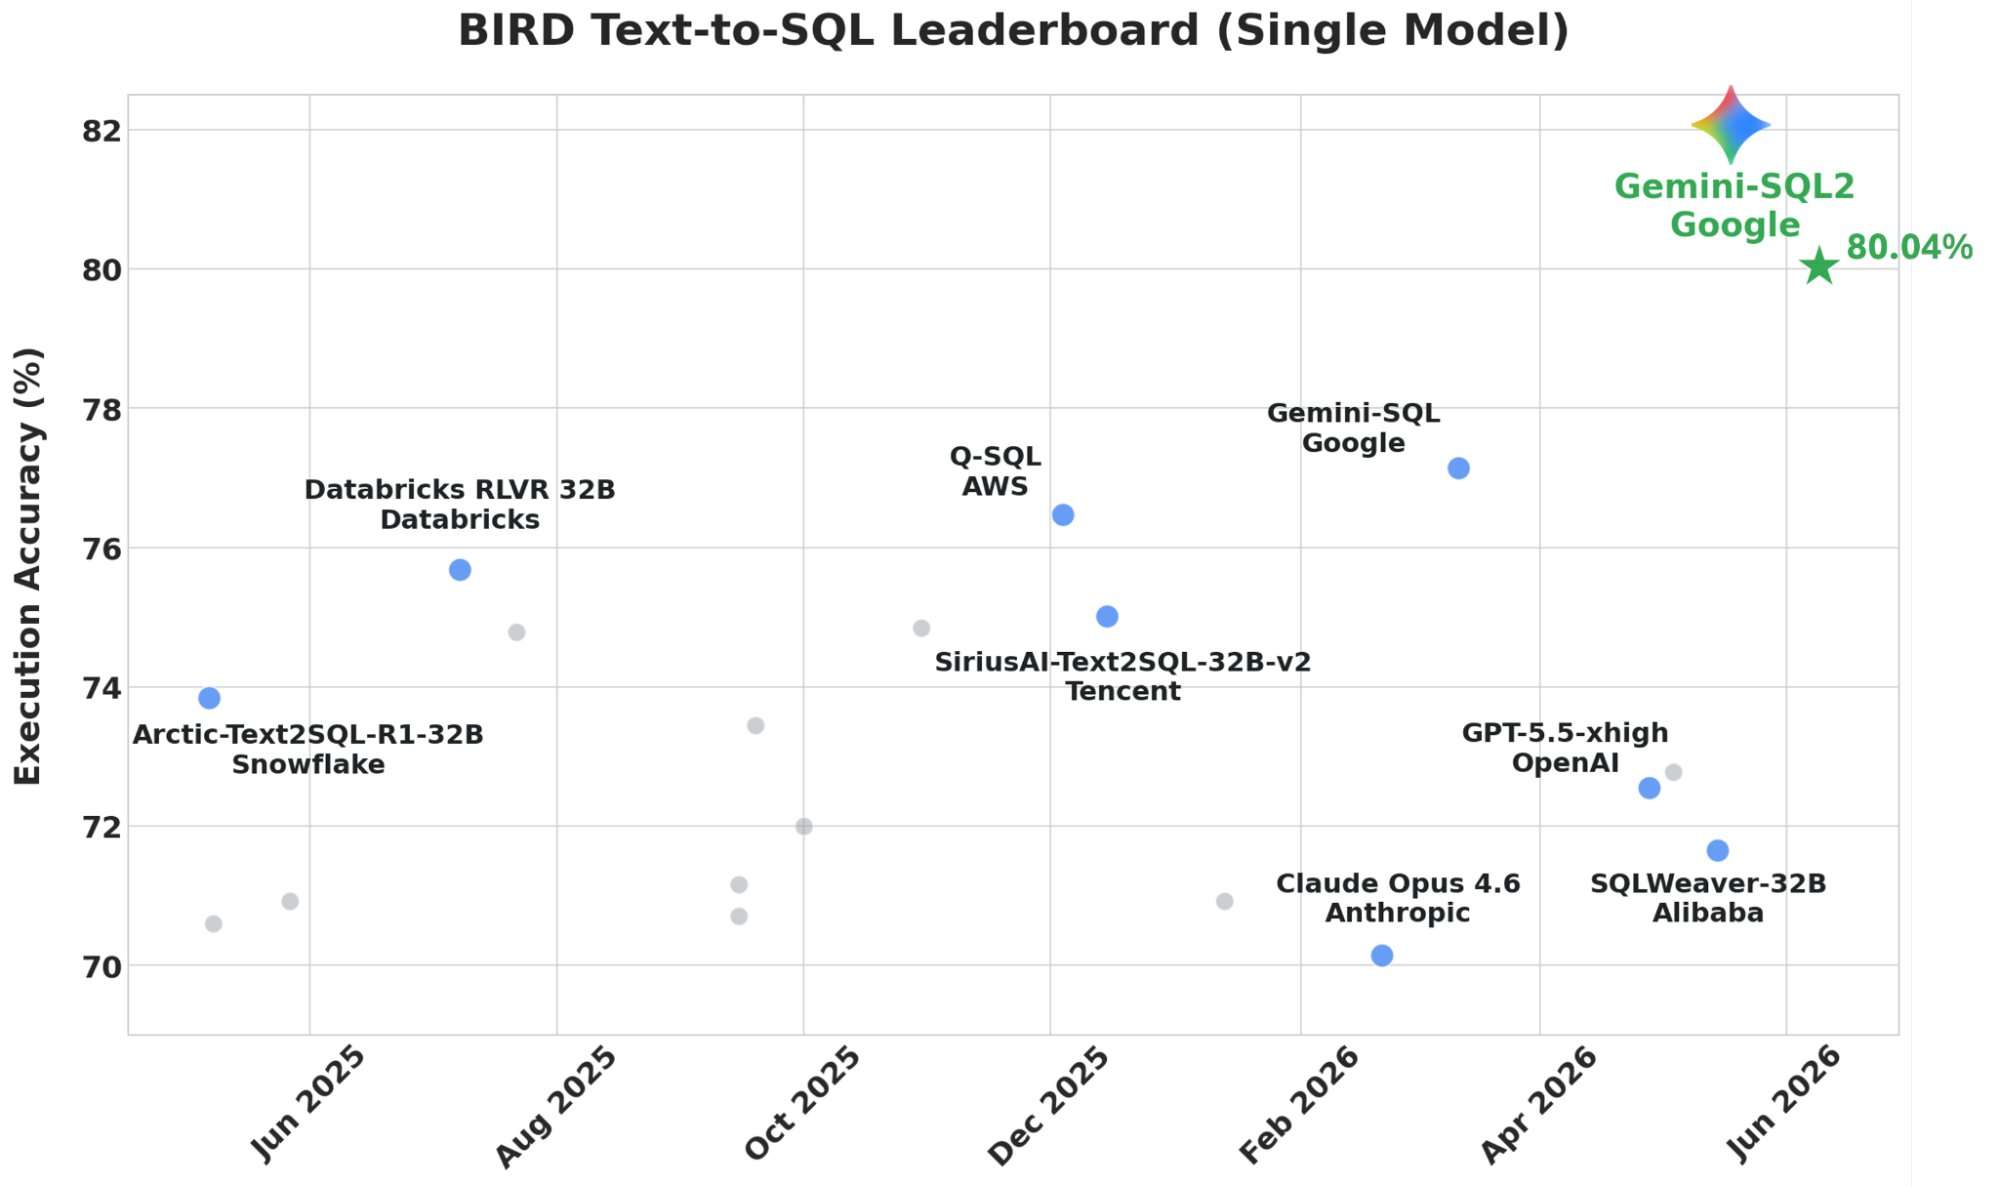
- 같은 트랙에서 AWS Q-SQL은 약 76.5%, Databricks RLVR 32B는 75.7%, OpenAI GPT-5.5-xhigh는 72.5%, Anthropic Claude Opus 4.6은 70.1% 수준입니다. 구글이 두 자리 다 차지한 모양새입니다.
- BIRD는 95개 데이터베이스, 37개 전문 도메인에 걸친 12,751개 질문-SQL 쌍으로 구성된 33.4GB 벤치마크입니다. 실행 정확도(EX)는 모델이 만든 SQL이 실제로 돌아가고 결과가 정답 쿼리와 일치해야 인정합니다.
- 정작 모델 문자열도, 공개 API도 아직 없습니다. BigQuery Studio·AlloyDB AI·Cloud SQL Studio 어디에 먼저 들어갈지도 미정입니다.
80.04%라는 숫자가 의미하는 것
텍스트-투-SQL은 한동안 “되긴 되는데 운영에서는 못 쓰겠다"는 평이 많았던 분야입니다. 데모로 보여 주는 질문은 잘 답하지만, 실제 데이터 웨어하우스에 붙이면 조인 방향이 틀리거나, 윈도 함수 인자가 깨지거나, 그냥 실행 자체가 안 되는 SQL이 쏟아졌습니다.
BIRD의 실행 정확도(Execution Accuracy)는 그 약점을 정조준한 지표입니다. 그럴듯해 보이는 SQL은 점수가 안 됩니다. 실제 데이터베이스에 던졌을 때 돌아가고, 결과 셋이 정답 쿼리와 일치해야 합니다. 12,751개 질문이 37개 도메인에 걸쳐 있으니, 우연으로 한 종류만 잘 푼다고 80%가 나오기 어렵습니다.
80.04%는 그래서 단순한 벤치 신기록 이상의 의미가 있습니다. 5번 던지면 4번은 그 자리에서 실행되는 SQL이 나온다는 뜻이고, 운영 파이프라인에서 사람이 한 번 더 다듬는 단계만 두면 충분히 쓸 만한 수준에 들어섰다는 뜻입니다.
리더보드 1·2위가 모두 구글
리더보드 상단을 보면 구도가 분명합니다.
| 순위 | 시스템 | 기관 | 정확도 |
|---|---|---|---|
| 1 | Gemini-SQL2 | 80.04% | |
| 2 | Gemini-SQL | ~77.2% | |
| 3 | Q-SQL | AWS | ~76.5% |
| 4 | Databricks RLVR 32B | Databricks | ~75.7% |
| 5 | SiriusAI-Text2SQL-32B-v2 | Tencent | ~75.0% |
| 6 | Arctic-Text2SQL-R1-32B | Snowflake | ~73.9% |
| 7 | GPT-5.5-xhigh | OpenAI | ~72.5% |
| 8 | SQLWeaver-32B | Alibaba | ~71.7% |
| 9 | Claude Opus 4.6 | Anthropic | ~70.1% |
1위와 2위가 모두 구글입니다. 1위는 80.04%, 2위는 그 자신의 이전 버전인 약 77.2%입니다. 빅테크 셋이 만든 일반 LLM(GPT, Claude)이 70%대 초반에 머무는 동안, 텍스트-투-SQL을 전용으로 깎은 32B급 모델들(Databricks, Tencent, Snowflake, Alibaba)이 그 윗줄을 잡고 있습니다. 일반 모델만으로는 운영 SQL 수준까지 가기 어렵다는 신호로 읽힙니다.
사람과의 격차도 인상적입니다. 같은 BIRD에서 사람은 평균 92.96%를 기록합니다. Gemini-SQL2가 그 격차를 12.92점까지 좁힌 셈입니다. “사람을 따라잡았다"고 말하기엔 이르지만, 이전 같은 트랙에서 20점이 넘게 벌어졌던 걸 생각하면 흐름은 분명합니다.
어디에 쓰겠다는 건가
구글이 직접 제시한 세 가지 시나리오가 있습니다.
첫째는 셀프서비스 분석입니다. 비개발자가 자연어로 던진 질문을 복잡한 조인이나 윈도 함수가 들어간 쿼리로 풀어 주는 용도입니다. 둘째는 데이터 엔지니어링 초안 생성입니다. BigQuery 변환 스크립트의 첫 버전을 모델이 깔아 두고, 엔지니어가 다듬는 흐름입니다. 셋째는 SaaS 제품 안에 자연어 질의 UI를 끼워 넣는 임베디드 용도입니다.
세 경우 모두 핵심은 “실행 가능한 SQL"입니다. 사용자가 결과 표를 보기 전에 SQL이 실제로 돌아야 합니다. 그래서 BIRD의 실행 정확도가 곧 제품 체감 품질이 됩니다.
그런데 모델 ID도, API도 아직 없다
여기서 한 가지 짚어 두면 좋습니다. 구글은 Gemini-SQL2의 모델 문자열도, API 엔드포인트도 아직 공개하지 않았습니다. 원문에 함께 실린 예제 코드도 google-genai SDK를 쓰는 뼈대만 보여 줄 뿐, 실제로 호출할 모델 이름은 비어 있습니다.
BigQuery Studio, AlloyDB AI, Cloud SQL Studio가 가장 자연스러운 합류 지점으로 거론되지만, 어디에 먼저 들어갈지는 확정되지 않았습니다. 발표 시점에 잡힌 X 게시물이 3시간 만에 14만 뷰를 넘긴 걸 보면 시장은 빠르게 반응했지만, 손에 잡히는 SKU가 나오기 전까지는 “곧 쓰게 될 기능"으로 분류하는 게 안전합니다.
실무자가 볼 핵심 포인트
- 벤치마크 점수보다 트랙을 먼저 본다. BIRD의 단일 모델 트랙은 외부 도구 호출, 앙상블, 검증기 루프 없이 한 모델이 한 번에 SQL을 뽑아야 합니다. 같은 80%여도 멀티-에이전트 트랙 점수와 같은 잣대로 비교하면 안 됩니다.
- GPT-5.5와 Claude Opus 4.6이 70% 초반에 머문다는 의미. 일반 LLM에 프롬프트만 잘 짜서 운영 SQL을 뽑으려는 접근은 한계가 분명합니다. 텍스트-투-SQL을 전용으로 깎은 모델이 따로 필요한 단계라고 봐야 합니다.
- GA 전까지의 대안. Gemini-SQL2가 풀리길 기다리는 동안이라면, 같은 트랙 상위 오픈 가중치 모델(Databricks RLVR 32B, Arctic-Text2SQL-R1-32B)을 자체 인프라에서 돌려 보는 게 합리적입니다. 75% 안팎 점수면 사내 분석 도구로는 충분히 쓸 만합니다.
- 사람이 한 번은 본다는 전제. 80%는 5번에 1번은 틀린다는 뜻이기도 합니다. 자동 실행 파이프라인보다, 자연어 입력 → SQL 초안 → 사람 확인 → 실행 단계를 두는 워크플로가 현재 점수대에 맞습니다.
- BigQuery 환경이 1순위 합류 후보다. 구글이 직접 호출하지는 않았지만, 학습 데이터·운영 워크로드·고객층이 가장 두꺼운 게 BigQuery입니다. 사내 데이터 스택을 BigQuery로 운영 중이라면 가장 먼저 알림을 받게 될 가능성이 큽니다.
원문 출처
- MarkTechPost, “Google Releases Gemini-SQL2: Gemini 3.1 Pro Text-to-SQL Scores 80.04% on BIRD Single-Model Leaderboard” by Asif Razzaq (2026-06-12) — 원문 링크
- BIRD Benchmark, “BIRD: BIg Bench for LaRge-scale Database Grounded Text-to-SQL Evaluation” — 공식 리더보드