핵심 요약
- 구글 딥마인드가 DiffusionGemma를 Apache 2.0으로 공개했다. Gemma 4 백본을 그대로 쓰면서, 디코딩만 자기회귀 → 텍스트 디퓨전으로 바꾼 실험적 모델이다.
- 구조는 26B MoE / 활성 파라미터 3.8B. 256K 컨텍스트, 140개 이상 언어, 텍스트·이미지·영상까지 받는 멀티모달 입력을 유지한다.
- 속도는 H100에서 1,000 tok/s 이상, RTX 5090에서도 700 tok/s를 넘긴다. 같은 Gemma 4 대비 약 4배 가까운 처리량이다.
- 대신 품질은 Gemma 4보다 한 단계 아래다. 구글이 직접 못 박았다. “속도가 우선, 최고 품질이 필요하면 그대로 Gemma 4를 써라.”
- vLLM이 처음부터 네이티브로 받는 첫 디퓨전 LLM이고, Transformers·MLX·Unsloth·NeMo도 동시에 지원한다. llama.cpp 지원은 곧 들어온다.
어디가 바뀐 모델인가
DiffusionGemma의 핵심은 출력 방식이다. 기존 LLM은 토큰을 하나씩, 앞 토큰이 정해져야 다음 토큰을 뽑는다. DiffusionGemma는 그렇게 안 한다. 256토큰짜리 캔버스를 통째로 펼쳐 놓고, 처음에는 전부 잡음 같은 자리표시 토큰으로 채운 다음 여러 번 갈고 닦으며 한 번에 확정한다. 이걸 구글은 Uniform State Diffusion이라고 부른다.
한 번 통과할 때 확신도가 높은 토큰만 약 15~20개씩 굳히고, 나머지는 다시 잡음으로 돌려 다음 패스에서 갈아엎는다. 이미 정해진 토큰을 다시 손볼 수 있다는 점이 자기회귀 모델과 가장 큰 차이다. 한 번 뱉으면 끝인 GPT 계열과 달리, 디퓨전은 자기 출력을 스스로 교정한다.
256토큰을 넘는 긴 응답에는 블록 단위 자기회귀 디퓨전이 붙는다. 완성된 블록은 KV 캐시에 박아놓고, 새 캔버스를 또 펼친다. 결국 블록 안에서는 병렬, 블록 사이는 순차다.
어텐션은 두 모드를 오간다. 프롬프트를 읽고 KV 캐시를 채우는 prefill 단계에서는 인과(causal) 어텐션, 캔버스를 갈고 닦는 디노이즈 단계에서는 양방향 어텐션을 쓴다. 모든 토큰이 모든 토큰을 본다.
속도와 품질의 맞교환
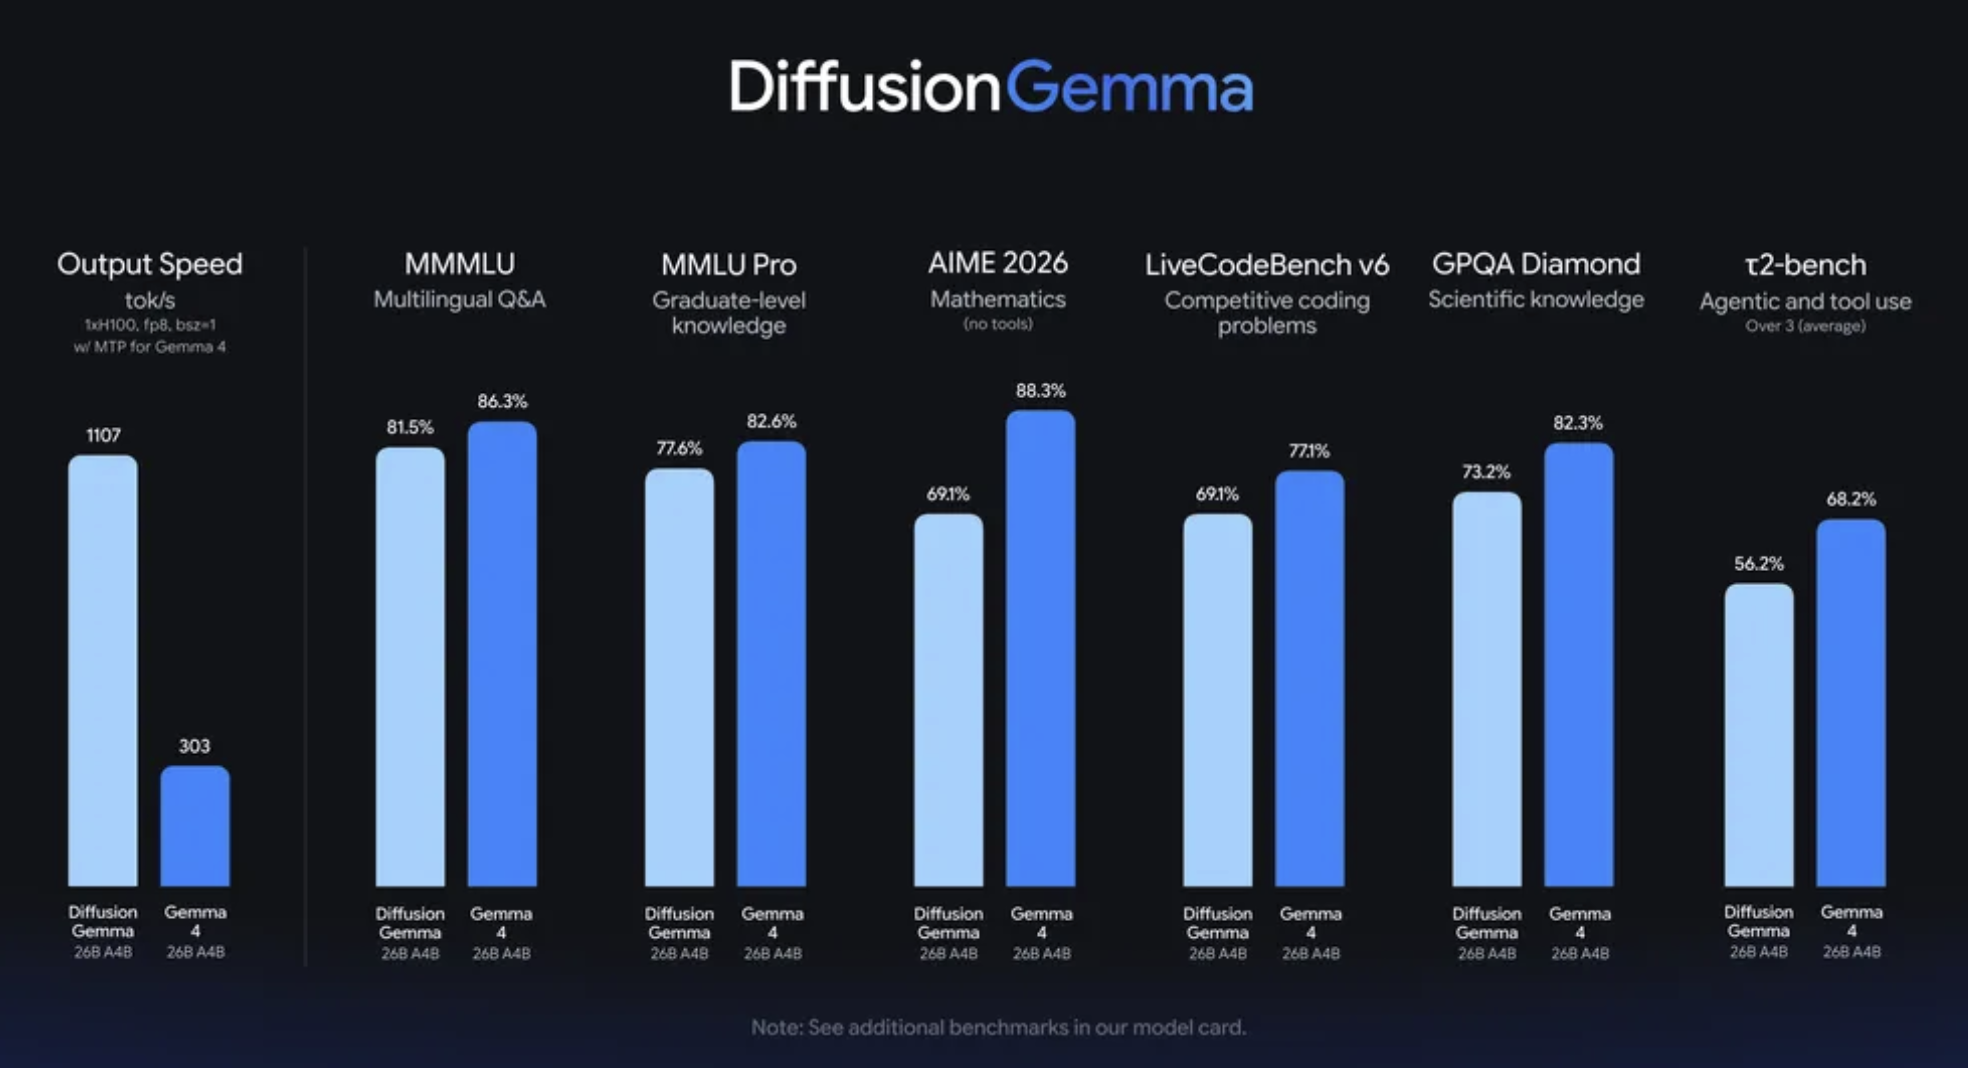
위 그래프가 이 모델의 정체를 가장 솔직하게 보여준다. 출력 속도는 DiffusionGemma 1,107 tok/s, Gemma 4 303 tok/s. 약 3.65배 차이다. 그런데 품질 지표는 전부 반대다.
- MMMLU (다국어): 81.5% vs 86.3%
- MMLU Pro (대학원급): 77.6% vs 82.6%
- AIME 2026 (수학): 69% vs 86.3%
- LiveCodeBench v6 (코딩): 69% vs 77%
- GPQA Diamond (과학): 73.2% vs 82.3%
- τ²-bench (에이전트/툴 사용): 56.2% vs 68.2%
수학과 에이전틱 벤치에서 차이가 가장 크게 벌어진다. 추론 깊이가 필요한 영역일수록 디퓨전 방식이 손해를 본다는 뜻이다. 반면 인라인 코드 채우기, 빠른 반복 수정, 비선형 편집 같은 시나리오는 속도가 무기다. 구글이 “로컬·단일 사용자·저동시성"을 명시적으로 가리키는 이유가 여기 있다.
흥미로운 사례 하나. 같은 모델을 스도쿠에 파인튜닝했더니 정답률이 **0%에서 80%**까지 올라갔다. 제약이 강한 구조적 출력에서 디퓨전 방식이 의외로 잘 먹힌다는 신호다.
왜 GPU에서 4배가 나오나
자기회귀 디코딩은 메모리 대역폭에 발목 잡히는 워크로드다. 매 스텝마다 KV 캐시를 읽어들이느라 GPU 코어가 놀게 된다. 디퓨전은 그림이 다르다. 한 번 forward pass에 토큰 한 무더기를 동시에 처리하니까, 같은 메모리 읽기 비용으로 연산을 더 빡빡하게 쓴다. 병목이 메모리에서 컴퓨트로 옮겨가는 것이다.
그래서 단일 사용자가 H100 하나를 통째로 쓰는 로컬 환경에서는 효과가 극대화된다. 단, 클라우드에서 동시 요청 수백 개를 묶어 처리하는 고QPS 서빙으로 가면 이야기가 달라진다. 거기서는 자기회귀 모델도 배치로 GPU를 충분히 채우기 때문에, 디퓨전의 병렬 이득이 묽어진다. 구글도 “클라우드 서빙 환경에서는 오히려 비용이 더 들 수 있다"고 같이 명시했다.
메모리 요구사항은 양자화 시 VRAM 18GB. 4090·5090급 한 장이면 로컬 추론이 가능하다는 이야기다.
어디로 보낼 수 있나
생태계는 처음부터 넓게 잡혔다.
- Hugging Face:
google/diffusiongemma-26B-A4B-it - vLLM: 디퓨전 LLM으로는 첫 네이티브 지원
- Transformers · MLX · Unsloth · NeMo: 학습·파인튜닝 모두 가능
- llama.cpp: 지원 준비 중
- 배포: Google Cloud Model Garden, NVIDIA NIM 양쪽으로
라이선스가 Apache 2.0이라는 점이 크다. Gemma 자체 라이선스를 쓰는 표준 Gemma 4와 다르게, 상업·재배포 부담이 거의 없다. 디퓨전 방식 자체를 후속 연구로 가져가려는 팀에게 진입 장벽이 낮아진다.
실무자가 볼 핵심 포인트
- 이건 Gemma 4의 대체가 아니다. 디코딩 전략을 바꿔본 실험 라인이다. 품질이 필요한 프로덕션에는 그대로 Gemma 4를 써야 한다는 게 구글의 공식 입장이다.
- 로컬·인터랙티브 용도면 검토 가치가 충분하다. 인라인 코드 보조, 텍스트 편집기 안의 즉시 제안, 빠른 OCR·문서 파싱 같은 단일 사용자 워크플로에서는 체감 속도가 다르다.
- 고QPS 서빙은 추천 안 한다. 배치가 깊어질수록 자기회귀와의 격차가 줄어든다. 비용 효율을 따져야 하는 API 서비스 백엔드라면 권장 시나리오가 아니다.
- 구조적 출력 파인튜닝의 가능성. 스도쿠 사례처럼, 제약이 명확한 도메인에서 디퓨전 방식의 자기 교정 특성이 의외로 잘 통한다. 코드 인필링이나 폼 채우기 같은 작업은 직접 파인튜닝을 시도해볼 만하다.
- 첫 단추를 vLLM이 잡았다. 디퓨전 LLM을 표준 추론 스택에서 그대로 굴릴 수 있다는 의미라, 후속 모델들이 같은 길을 따라 들어올 가능성이 높다.
원문 출처
- Google AI Releases DiffusionGemma, a 26B MoE Open Model Using Text Diffusion for Up to 4x Faster Generation (MarkTechPost, 2026-06-10)
- Hugging Face 모델 카드:
google/diffusiongemma-26B-A4B-it