RAG(검색 증강 생성)를 구축할 때 가장 큰 벽은 비정형 데이터다. PDF 수백 장, 이미지 수천 장이 섞인 기업 자료에서 원하는 정보를 정확히 찾고, 출처까지 명확하게 표시하는 것 — 지금까지는 직접 파이프라인을 쌓아야 했다.
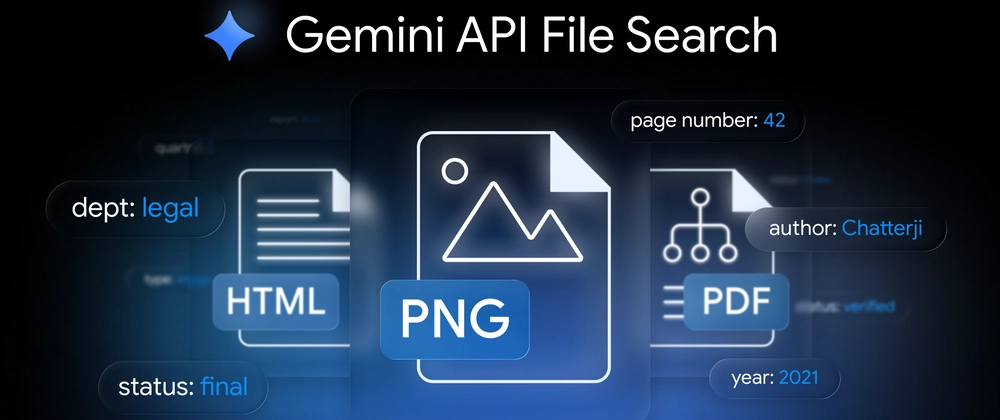
2026년 5월 5일, 구글이 Gemini API File Search에 세 가지 업데이트를 추가했다. 멀티모달 검색, 커스텀 메타데이터 필터링, 페이지 단위 인용이다. 인프라 구축 없이 프로덕션급 RAG를 바로 붙일 수 있게 됐다.
핵심 요약
- 멀티모달 검색: 이미지와 텍스트를 함께 인덱싱·검색 — Gemini Embedding 2 모델 기반
- 커스텀 메타데이터: 파일에
department: Legal,status: Final같은 키-값 태그 부착, 쿼리 시 필터 적용 - 페이지 단위 인용: 모델 응답에 원본 PDF의 정확한 페이지 번호를 연결해 팩트체킹 가능
- 대상: 주말 프로토타입부터 수천 명이 쓰는 프로덕션까지 동일한 API로 커버
업데이트 1: 멀티모달 검색 — 이미지도 언어로 찾는다
기존 File Search는 텍스트만 처리했다. 이제 Gemini Embedding 2 모델을 기반으로 이미지와 텍스트를 함께 인덱싱하고 검색한다.
실용적으로 어떤 의미인가? 크리에이티브 에이전시가 수천 장의 캠페인 이미지 아카이브를 가지고 있다고 하자. 지금까지는 파일명이나 태그에 의존해야 했다. 이제는 “따뜻한 감성의 가족 장면” 같은 자연어 브리프로 시각적 자산을 검색할 수 있다.
키워드가 아닌 의미 기반 검색이다. 문서의 텍스트와 이미지가 동일한 임베딩 공간에 놓이기 때문에, 쿼리 하나로 텍스트 섹션과 관련 다이어그램을 동시에 찾아올 수 있다.
업데이트 2: 커스텀 메타데이터 — 대규모 데이터에서 노이즈를 제거한다
파일을 벡터 DB에 던져놓는 건 쉽다. 수천 개 파일 중에서 맞는 걸 빠르게 꺼내는 게 어렵다.
커스텀 메타데이터는 비정형 파일에 키-값 레이블을 붙이는 기능이다.
department: Legal
status: Final
region: APAC
year: 2025
이렇게 태그를 달아두면, 쿼리 시 필터를 적용해 해당 슬라이스만 검색한다. 관련 없는 문서에서 오는 노이즈가 줄고, RAG 워크플로의 속도와 정확도가 함께 올라간다.
기업 환경에서 특히 중요하다. 수만 개의 계약서, 보고서, 기술 문서가 혼재할 때, 부서·상태·기간으로 검색 범위를 좁히는 것만으로 결과의 품질이 크게 달라진다.
업데이트 3: 페이지 단위 인용 — “어디서 나온 말인가"를 증명한다
AI가 수백 페이지 PDF에서 끌어낸 답변을 사용자가 어떻게 신뢰할 수 있을까? 답이 맞다는 것도 중요하지만, 어디서 나온 것인지를 확인할 수 있어야 한다.
File Search는 이제 모델 응답에 원본 소스의 정확한 페이지 번호를 연결한다. 인덱싱 시 모든 정보의 페이지 위치를 기록해두고, 답변 생성 시 해당 페이지를 인용으로 반환한다.
사용자는 “3페이지를 보세요"라는 구체적인 안내를 받는다. 팩트체킹이 가능해지고, 결과에 대한 신뢰도가 높아진다. 법률, 컴플라이언스, 의료 같은 고위험 도메인에서 특히 유효하다.
기술 스택: Gemini Embedding 2
멀티모달 검색의 기반은 Gemini Embedding 2 모델이다. 텍스트와 이미지를 동일한 임베딩 공간에 표현해, 단일 쿼리로 두 모달리티를 함께 검색할 수 있다.
File Search는 이 인프라를 추상화해서 제공한다. 개발자는 임베딩 모델 선택, 벡터 DB 운영, 청킹 전략을 직접 설계할 필요 없이 파일 업로드와 쿼리 API만 다루면 된다.
# 파일 업로드 (텍스트 + 이미지 혼합 가능)
file = client.files.upload(path="document.pdf", metadata={"department": "Legal"})

# 자연어 쿼리로 검색
results = client.files.search(query="따뜻한 가족 사진", filters={"department": "Marketing"})
실무자가 볼 핵심 포인트
멀티모달 RAG의 진입 장벽이 낮아졌다 — 이미지 임베딩 파이프라인을 별도로 구축하지 않아도, Gemini Embedding 2 기반으로 텍스트·이미지 혼합 검색이 가능하다. 특히 시각 자료가 많은 기업 문서(연구 보고서, 기술 매뉴얼, 제품 카탈로그)에 직접 적용할 수 있다.
메타데이터 필터는 멀티테넌트 앱의 핵심이다 — 여러 부서나 고객이 공유하는 지식 베이스를 운영할 때, 접근 범위를 메타데이터로 제어하면 단일 인덱스로 격리된 경험을 제공할 수 있다. 별도 테넌트별 인덱스를 만들지 않아도 된다.
페이지 인용은 엔터프라이즈 수용성의 열쇠다 — AI 도입을 막는 주요 장애물 중 하나가 “출처 확인 불가"다. 페이지 번호가 반환되면 감사(Audit) 요구사항을 충족하고, 최종 사용자의 거부감을 낮출 수 있다.
인프라 복잡도를 API가 흡수한다 — Pinecone, Weaviate, pgvector 같은 별도 벡터 DB 설정 없이 File Search API 하나로 인덱싱·검색·인용 파이프라인이 완성된다. 프로토타입 속도를 프로덕션에서도 유지할 수 있다.
Gemini Embedding 2와 직접 통합된 강점 — 제3자 임베딩 모델을 연결할 때 생기는 버전 불일치, 스케일링 이슈가 없다. Google 인프라 안에서 임베딩과 생성이 함께 최적화된다.
자주 묻는 질문 (FAQ)
Q: 기존 텍스트 전용 RAG 파이프라인을 멀티모달로 전환하려면 어떻게 해야 하나요? File Search API의 업로드 엔드포인트에 이미지 파일을 추가하면 됩니다. 별도의 임베딩 모델 설정 없이 Gemini Embedding 2가 자동으로 처리합니다. 기존 텍스트 파일과 혼합해 동일한 인덱스에 넣을 수 있습니다.
Q: 커스텀 메타데이터는 어떤 형식으로 지원되나요?
키-값 문자열 쌍을 지원합니다. department: Legal, status: Final, region: APAC 같은 형태입니다. 쿼리 시 하나 이상의 필터를 조합해 검색 범위를 좁힐 수 있습니다.
Q: 페이지 인용은 PDF 외에 다른 파일 형식에도 작동하나요? 현재 Google 발표 기준으로 PDF가 주요 대상입니다. 페이지 개념이 있는 문서 형식에 적용됩니다. 최신 지원 형식은 Gemini API 공식 문서에서 확인하세요.
Q: Gemini API 유료 플랜이 있어야 하나요? File Search는 Gemini API를 통해 제공됩니다. Google AI Studio에서 무료 티어로 시작할 수 있으며, 프로덕션 규모에서는 유료 플랜이 필요합니다. 구체적인 가격은 Google AI Studio 페이지에서 확인하세요.
원문 출처: Ivan Solovyev, Kriti Dwivedi, “Gemini API File Search is now multimodal: build efficient, verifiable RAG”, Google Blog, 2026년 5월 5일 — https://blog.google/innovation-and-ai/technology/developers-tools/expanded-gemini-api-file-search-multimodal-rag/