LLM은 이제 검색창, 업무 도구, 코딩 보조, 보고서 작성까지 정보 전달의 앞단에 서 있다. 그래서 다음 질문은 더 중요해졌다. “이 모델이 그럴듯하게 말하는가”가 아니라, “정확히 말하는가”다.
핵심 요약
- Google DeepMind가 Kaggle과 함께 LLM 사실성 평가용 FACTS Benchmark Suite를 공개했다.
- 평가는 Grounding v2, Parametric, Search, Multimodal 네 축으로 나뉜다.
- 공개 예시는 총 3,513개이며, 비공개 held-out 세트는 Kaggle이 관리한다.
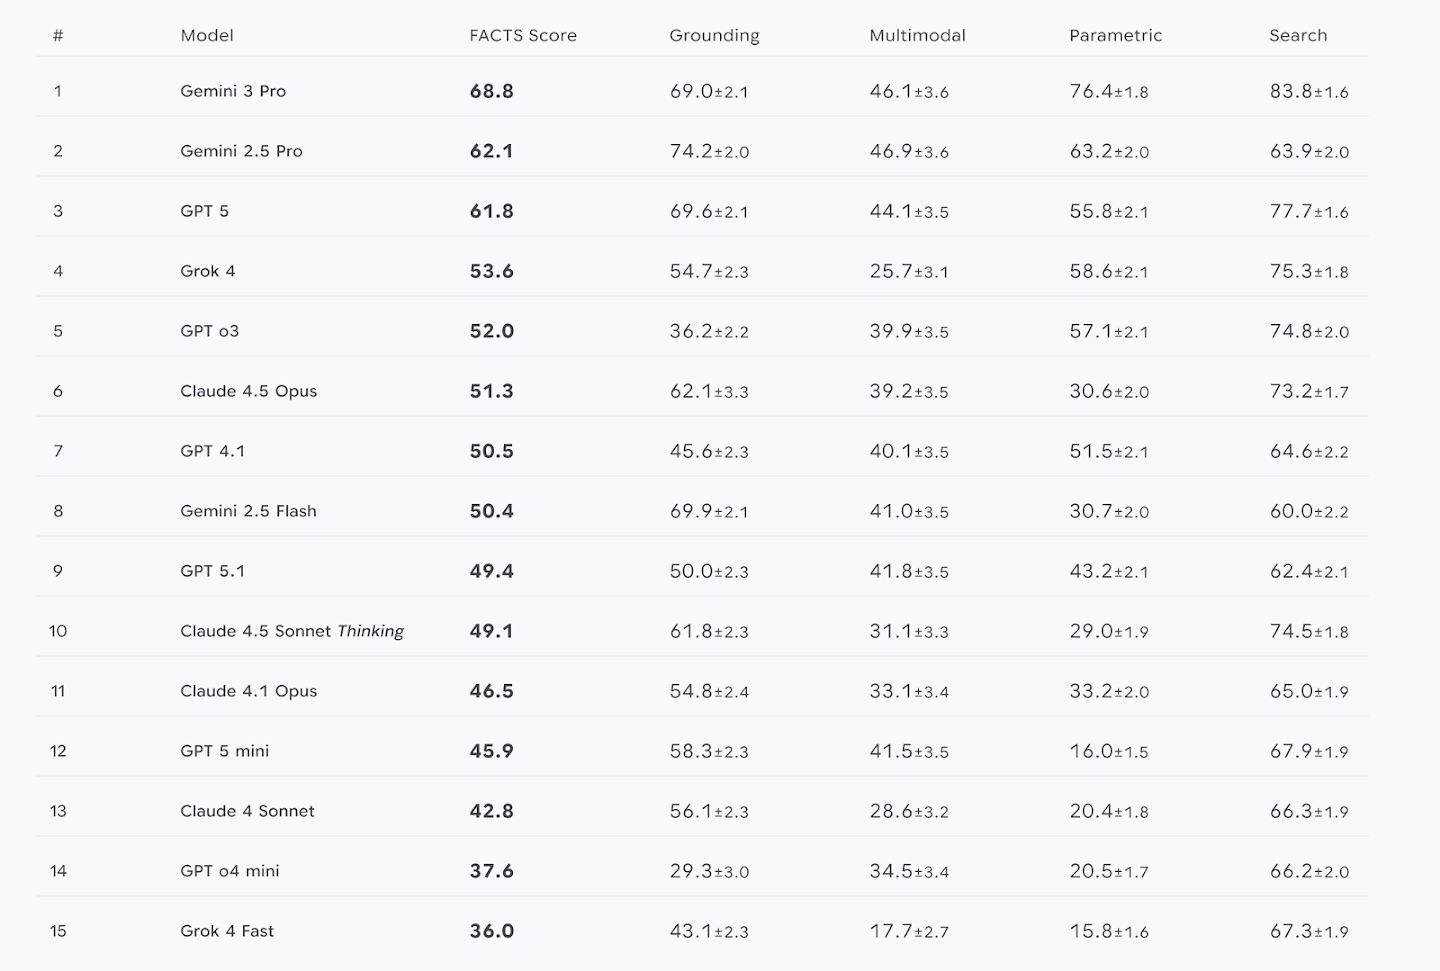
- Gemini 3 Pro가 FACTS Score 68.8%로 1위를 기록했지만, 평가된 모든 모델은 70%를 넘지 못했다.
- Multimodal 영역은 전반적으로 가장 낮은 점수를 보여, 이미지 기반 사실성 평가가 아직 어렵다는 점을 드러냈다.
FACTS는 무엇을 다르게 보나
기존 LLM 평가는 종종 “문제를 얼마나 잘 푸는가”에 초점이 맞춰졌다. 하지만 실제 사용자는 조금 다르게 묻는다. 모델이 답을 모를 때도 자신 있게 틀린 말을 하는지, 검색 결과를 제대로 합성하는지, 주어진 문서 안에서만 답하는지, 이미지를 보고 사실에 맞는 설명을 하는지가 더 중요하다.
FACTS Benchmark Suite는 이 문제를 한 덩어리로 보지 않는다. 사실성을 네 가지 상황으로 나눠 측정한다. 내부 지식만으로 답하는 상황, 웹 검색을 도구로 쓰는 상황, 이미지 입력을 해석하는 상황, 주어진 문맥에 근거해 답해야 하는 상황이다. 이 구분이 중요하다. LLM의 환각은 한 가지 원인으로만 생기지 않기 때문이다.
예를 들어 내부 지식 문제에서 틀리는 모델과, 검색 결과를 찾고도 합성을 잘못하는 모델은 개선 방법이 다르다. 전자는 학습 데이터와 지식 갱신의 문제에 가깝고, 후자는 도구 사용·출처 선택·중간 추론의 문제에 가깝다. 문맥 근거 답변에서 실패한다면 RAG 파이프라인의 검색 품질보다 답변 생성 단계의 근거 준수 능력을 봐야 할 수도 있다. 그래서 FACTS의 가치는 단순한 점수표보다 “어디서 틀리는지”를 나눠 보여주는 데 있다.
네 가지 사실성 평가 축
첫째는 Grounding Benchmark v2다. 모델이 주어진 문맥에 충실하게 답하는지 본다. 문서에 없는 내용을 덧붙이거나, 근거를 벗어나 추론하면 불리하다.
둘째는 Parametric Benchmark다. 외부 도구 없이 모델 내부 지식만으로 사실형 질문에 답하는 능력을 평가한다. 위키피디아로 답할 수 있는 트리비아형 질문이 중심이며, 공개 세트와 비공개 세트가 각각 1,052개씩 구성됐다.
셋째는 Search Benchmark다. 모델이 같은 웹 검색 도구를 사용해 여러 정보를 순차적으로 찾아내고, 이를 정확히 합성하는지 본다. 단순 검색 한 번으로 끝나는 문제가 아니라 여러 사실을 연결해야 하는 질문이 포함된다.
넷째는 Multimodal Benchmark다. 이미지 기반 질문에 사실적으로 답하는 능력을 평가한다. 단순히 이미지를 설명하는 수준이 아니라, 시각적 단서와 모델의 세계 지식을 결합해 정확하고 완전한 답을 내야 한다.
결과가 말하는 불편한 현실
DeepMind가 공개한 결과에서 Gemini 3 Pro는 FACTS Score 68.8%로 전체 1위를 기록했다. Gemini 2.5 Pro와 비교하면 Search 영역 오류율은 55%, Parametric 영역 오류율은 35% 줄었다. 별도 사실성 벤치마크인 SimpleQA Verified에서도 Gemini 3 Pro는 54.5%에서 72.1%로 개선됐다.
하지만 더 중요한 메시지는 “1위”보다 “아직 70% 미만”이라는 점이다. 평가된 모든 모델이 전체 정확도 70%를 넘지 못했다. 특히 Multimodal 영역은 전반적으로 가장 낮은 점수를 보였다. 이미지 이해가 강해졌다고 해도, 그것을 사실적으로 설명하고 필요한 지식과 연결하는 일은 여전히 어렵다는 뜻이다.
이 결과는 LLM을 업무에 쓰지 말라는 신호가 아니다. 오히려 반대다. LLM을 더 넓게 쓰려면, 어떤 상황에서 틀리는지 더 정교하게 나눠 봐야 한다. FACTS가 의미 있는 이유는 모델 순위를 매기는 데서 끝나지 않고, 실패 유형을 분해해 개선 방향을 보여주기 때문이다.
실무에서는 이 차이가 바로 운영 정책으로 이어진다. 내부 지식 답변은 최신성이 필요한 질문에 제한을 걸 수 있고, 검색 기반 답변은 출처 표시와 다중 검증을 강제할 수 있다. 이미지 기반 답변은 의료·법률·보안처럼 오판 비용이 큰 영역에서 사람 검토를 붙이는 식이다. 결국 좋은 벤치마크는 “어떤 모델이 이겼나”보다 “어떤 안전장치를 어디에 둬야 하나”를 결정하게 해준다.
실무자가 볼 핵심 포인트
- 사실성은 단일 점수가 아니다: 내부 지식, 검색, 문맥 근거, 이미지 이해는 서로 다른 실패 모드를 가진다.
- 검색 연결만으로 환각이 사라지지 않는다: Search Benchmark는 웹을 써도 여러 사실을 잘못 합성할 수 있음을 전제로 한다.
- RAG 시스템도 Grounding 평가가 필요하다: 문서를 넣었다고 답변이 자동으로 근거 기반이 되는 것은 아니다.
- 멀티모달 도입은 더 조심해야 한다: 이미지 설명은 쉬워 보여도, 사실성과 완전성을 동시에 만족시키기 어렵다.
- 벤치마크 순위는 맥락 안에서 봐야 한다: Gemini 3 Pro의 1위는 FACTS 기준의 결과이며, 모든 사용 사례의 절대 순위는 아니다.
원문 출처
원문: FACTS Benchmark Suite: Systematically evaluating the factuality of large language models — The FACTS team, Google DeepMind