개요
LLM 학습에는 왜 이렇게 많은 GPU 메모리가 필요할까? fp16으로 3GB면 충분해 보이는 GPT-2 1.5B 모델이 실제로는 32GB GPU로도 학습이 안 된다. HuggingFace 커뮤니티에 올라온 Daniil Suhoi의 종합 가이드를 바탕으로, 데이터 타입 기초부터 메모리 구조 분석, 양자화 원리까지 핵심만 추려 정리했다.
핵심 요약
- fp16 파라미터 3GB → Adam 혼합 정밀도 학습 시 실제 필요량 24GB — 옵티마이저 상태가 메모리의 대부분을 잡아먹는다
- BFloat16은 Float32의 지수부 8비트를 그대로 유지해 오버플로우 위험 없이 fp16 속도를 낸다
- 양자화는 “정보 손실이 있는 압축"이며, 대칭/비대칭, PTQ/QAT, 세분화 수준이 품질을 결정한다
- 활성화 체크포인팅으로 60GB 활성화 메모리를 8GB로 줄일 수 있지만 **재연산 오버헤드 33%**가 따라온다
본문
데이터 타입부터 이해해야 한다
최적화 이야기를 시작하기 전에 숫자 표현 방식을 짚고 가야 한다. 딥러닝에서 자주 쓰이는 부동소수점 타입들은 구조가 미묘하게 다르고, 그 차이가 학습 안정성과 메모리 소비에 직접 영향을 준다.
- Float32: 부호 1비트, 지수 8비트, 가수 23비트. 표준 정밀도.
- Float16: 부호 1비트, 지수 5비트, 가수 10비트. 최댓값이 65,504로 제한돼 활성화 텐서에서 오버플로우가 잦다.
- BFloat16: 부호 1비트, 지수 8비트, 가수 7비트. Google Brain이 개발했다. 지수부가 Float32와 같아서 표현 범위가 동일하고, 두 포맷 간 변환이 단순하다. 현대 딥러닝에서 fp16보다 BF16이 선호되는 이유다.
- TensorFloat32(TF32): NVIDIA가 Ampere(A100)에서 도입한 19비트 타입. 지수 8비트(BF16 수준)에 가수 10비트(fp16 수준)를 결합해 범위와 정밀도를 절충했다.
- FP8(E4M3, E5M2): NVIDIA, ARM, Intel이 공동 제안한 8비트 부동소수점. 현대 LLM과 이미지 네트워크를 FP8로 학습·추론하는 실험이 성공적으로 진행됐다.
메모리는 어디로 사라지는가
GPT-2 1.5B 모델의 fp16 가중치 크기는 단순 계산으로 3GB다. 그런데 왜 32GB GPU에서 학습이 불가능할까?
학습 중 메모리는 두 종류로 나뉜다.
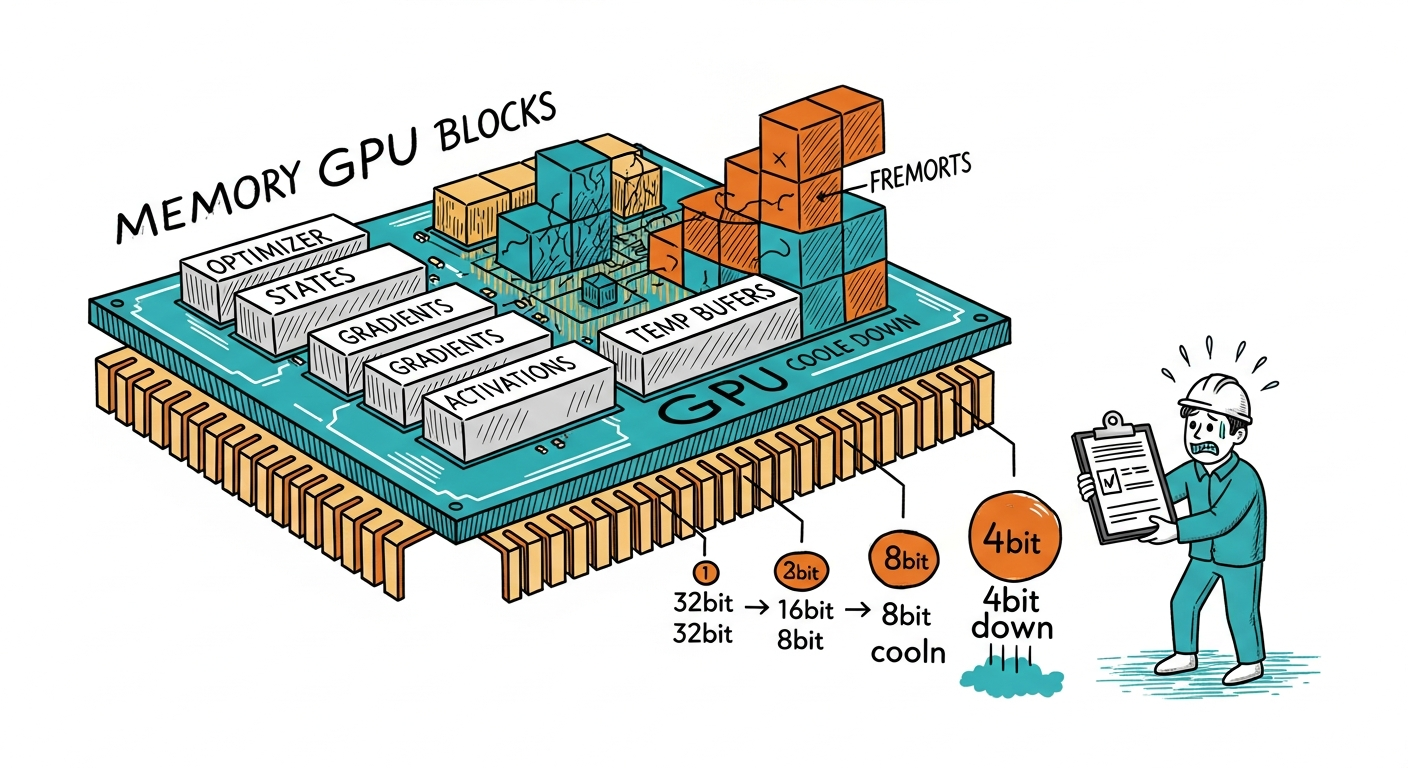
모델 상태(Model States): 옵티마이저 상태, 기울기, 파라미터가 여기 속한다. Adam처럼 주요 옵티마이저는 각 파라미터에 대해 모멘텀과 분산을 저장한다. 혼합 정밀도 학습을 적용하면 구체적으로 다음을 보관해야 한다.
| 항목 | 정밀도 | 메모리(Φ = 파라미터 수) |
|---|---|---|
| fp16 파라미터 | 2바이트 | 2Φ |
| fp16 기울기 | 2바이트 | 2Φ |
| fp32 파라미터 사본 | 4바이트 | 4Φ |
| fp32 모멘텀 | 4바이트 | 4Φ |
| fp32 분산 | 4바이트 | 4Φ |
| 합계 | 16Φ |
1.5B 파라미터 모델이면 16 × 1.5B = 24GB. 가중치만 3GB였던 모델이 실제로는 여덟 배가 넘는 메모리를 요구한다.
잔여 메모리(Residual States): 활성화값, 임시 버퍼, 메모리 단편화가 여기 해당한다. GPT-2 1.5B를 시퀀스 길이 1K, 배치 사이즈 32로 학습하면 활성화값만 약 60GB를 차지한다. 이를 줄이는 방법이 활성화 체크포인팅이다. 중간 활성화를 저장하지 않고 역전파 시 재연산해 메모리를 8GB까지 낮출 수 있다. 단, 재연산 비용으로 학습 시간이 약 33% 늘어난다.
메모리 단편화도 간과할 수 없다. 이론적으로 여유 메모리가 있어도 연속 블록이 없으면 할당에 실패한다. 초대형 모델 학습에서는 가용 메모리의 30% 이상이 남아있어도 OOM이 발생하는 사례가 보고된다.
양자화: 정밀도를 줄여 속도를 얻다
양자화는 모델의 가중치·연산을 FP32에서 FP16, INT8, 심지어 4비트 정수로 압축하는 과정이다. 목표는 모델 크기 감소, 메모리 절약, 추론 가속이다.
대칭 vs 비대칭 선형 양자화
실수 범위를 정수 범위로 매핑할 때 두 방식이 있다. 대칭 양자화는 영점(Z)이 항상 0이라 구현이 단순하고 역양자화가 스칼라 곱 하나로 끝난다. 비대칭 양자화는 데이터 분포가 한쪽으로 치우쳐 있을 때 더 정확하다.
언제 양자화하나: PTQ vs QAT
- 후처리 양자화(PTQ): 학습 완료된 모델을 캘리브레이션 데이터셋으로 통계를 수집한 뒤 양자화한다. 빠르고 쉽지만 정확도 손실이 있다.
- 양자화 인식 학습(QAT): 학습 중에 양자화 효과를 시뮬레이션한다. 연산 비용이 높지만 양자화된 환경에 적응한 모델이 나온다.
세분화(Granularity)가 품질을 결정한다
전체 모델에 스케일 팩터 하나를 쓰면 품질이 떨어진다. 텐서 단위, 나아가 행·열 단위로 스케일 팩터를 분리할수록 정밀도가 높아진다. 텐서를 작은 블록으로 나눠 블록별 스케일 팩터를 쓰는 방식은 이상값(outlier)의 영향을 국소화해 전체 품질을 보호한다.
실무자가 볼 핵심 포인트
- BF16을 기본으로 삼아라 — A100, H100 등 현세대 GPU에서 fp16보다 BF16이 안전하다. 오버플로우 없이 Float32 수준의 범위를 fp16 속도로 쓸 수 있다.
- Adam + 혼합 정밀도면 메모리 × 8을 예상해라 — 가중치 크기만 보고 GPU를 선택하면 반드시 OOM을 만난다. 옵티마이저 상태 포함 16Φ가 실질 기준선이다.
- 활성화 체크포인팅은 메모리 vs 속도 트레이드오프 — 메모리가 병목이면 켜라. 학습 시간 33% 증가를 감수할 수 있는지 먼저 계산하라.
- PTQ는 빠르고 QAT는 정확하다 — 프로덕션 배포 전 속도만 필요하면 PTQ로 충분하다. 정확도가 중요한 작업이라면 QAT를 쓰되 학습 비용을 확보해야 한다.
- 블록 단위 양자화가 이상값에 강하다 — LLM 가중치 행렬에는 분포 이탈값이 많다. 텐서 전체에 단일 스케일을 쓰면 이 이상값이 전체 정밀도를 왜곡한다.