개요
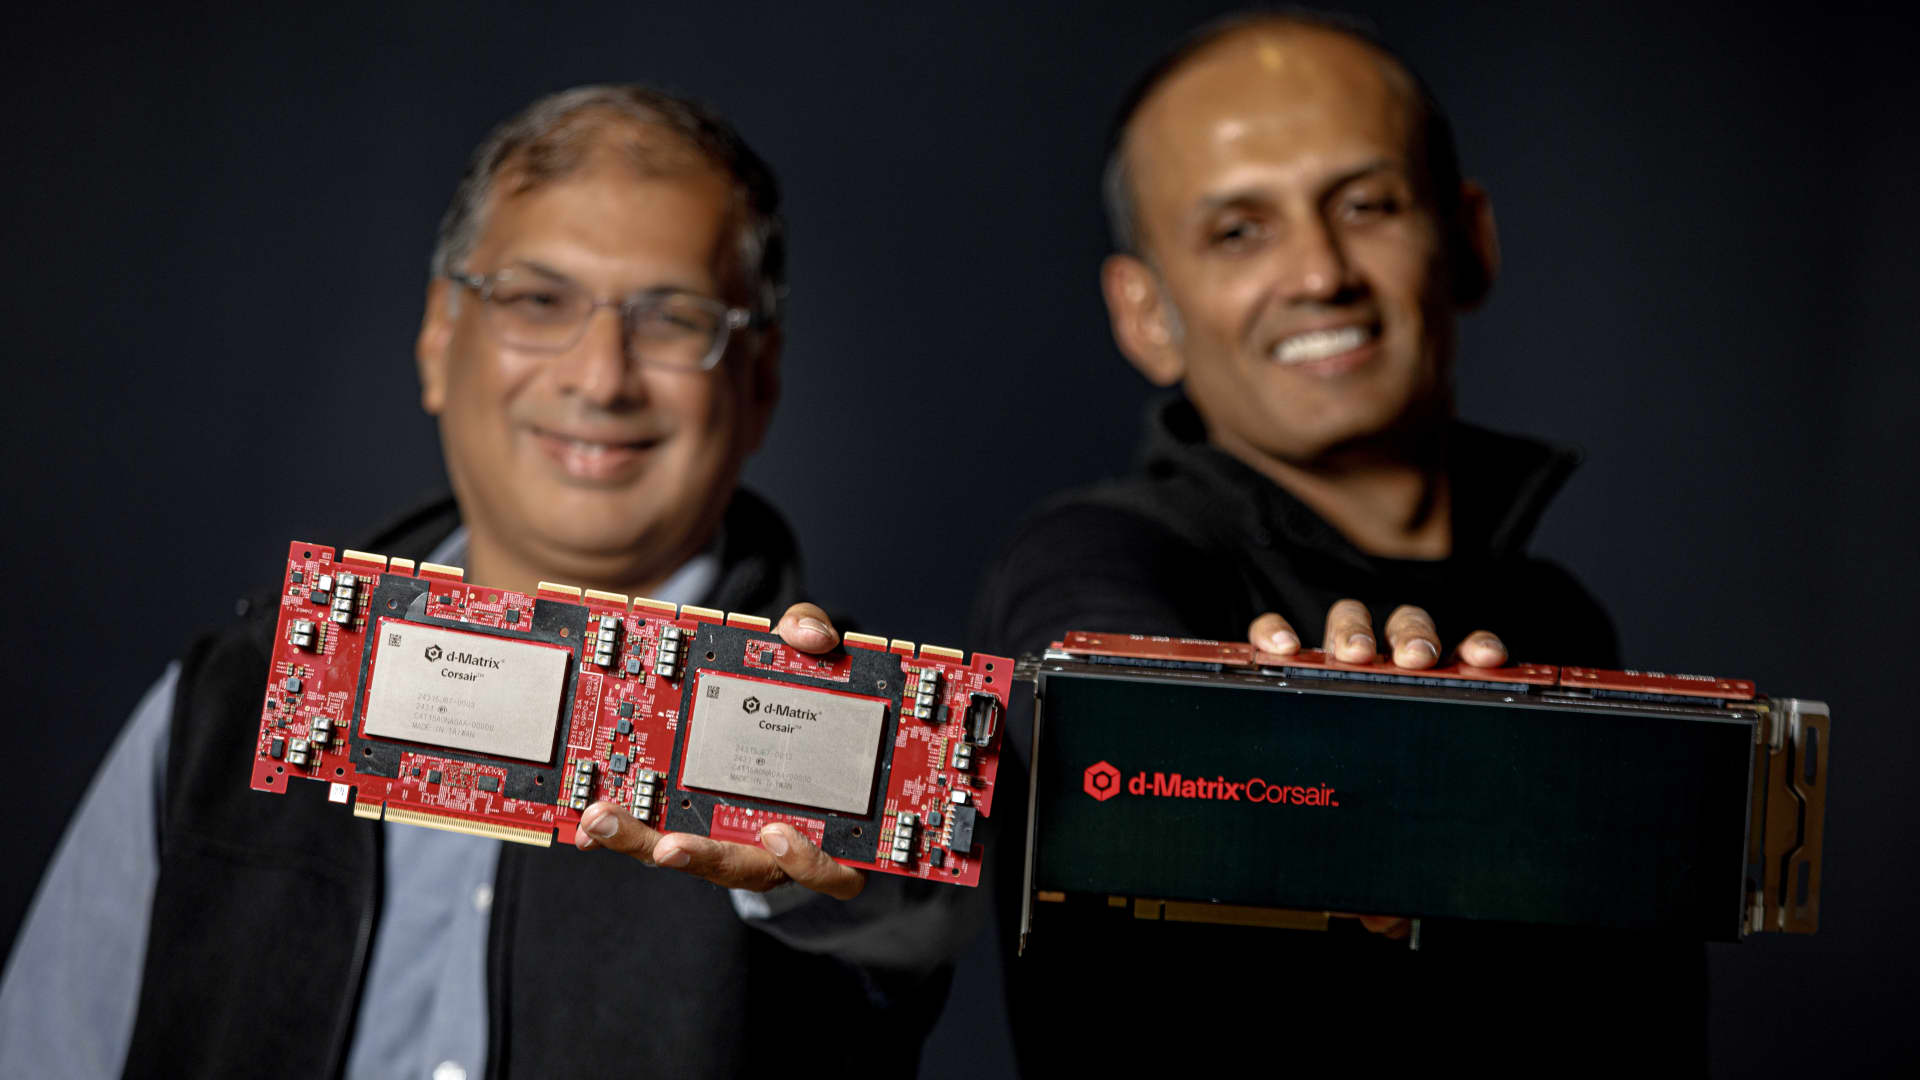
CNBC가 2026년 6월 9일 공개한 단독 영상에서 d-Matrix는 자사 첫 양산 제품 Corsair를 “단일 GPU보다 AI 추론을 10배 빠르게 돌리는 칩"으로 못 박았다. 같은 영상에 나온 CEO 시드 셰스(Sid Sheth)는 Corsair의 차별점이 HBM 같은 외부 DRAM 의존을 끊고 칩 위 SRAM으로 데이터를 처리하는 구조라고 설명했다. DRAM 공급난을 정면으로 우회하면서 데이터 전송에 드는 에너지는 5분의 1 수준으로 떨어진다는 게 회사 주장이다.

핵심 요약
- 양산 단계 진입 — Corsair는 시제품 단계를 지나 본격 양산 중이며, 하이퍼스케일러·네오클라우드·프런티어 AI 랩에서 도입 의사를 확보했다고 d-Matrix는 밝혔다.
- 칩 위 SRAM 구조 — HBM·외부 DRAM이 아니라 다이 안 SRAM을 메모리로 사용해, 메모리 대역폭 병목과 DRAM 공급 부족을 함께 우회한다.
- 속도/에너지 주장 — 동일 추론 워크로드에서 단일 GPU 대비 약 10배 처리량, 데이터 이동에 드는 전력은 약 5배 절감된다는 것이 회사 설명이다.
- 포지셔닝 — 학습이 아니라 추론 전용 가속기로, Nvidia·AMD가 학습 시장을 장악한 사이 추론 비용·전력 곡선을 깎는 전략을 잡았다.
- 컨텍스트 — 영상 공개 시점은 메모리·HBM 가격이 다시 한 번 흔들리고, AI 데이터센터 전력 소비가 정치 의제로 떠오른 시기였다.
Corsair는 GPU와 무엇이 다른가
전통적인 GPU 추론은 모델 가중치와 활성값을 HBM에 두고 코어가 매 토큰마다 외부 메모리를 두드린다. HBM은 빠르지만 칩 바깥 메모리라는 사실은 변하지 않고, 데이터가 다이 경계를 넘는 그 순간 지연과 전력이 함께 솟는다. 지금 AI 데이터센터의 발열·전력 곡선은 사실상 이 “외부 메모리 왕복” 비용 위에 서 있다.
Corsair가 택한 길은 단순하다. 메모리를 칩 안으로 끌어들이고, 외부로 나가지 못하게 막는다. 다이 위에 충분한 SRAM을 깔고, 모델 가중치와 KV 캐시를 그 위에서 처리한다. SRAM은 한 비트당 면적과 가격이 DRAM보다 훨씬 비싸지만, 한 번 다이 안에 들어오면 접근 지연은 ns 단위로 떨어지고 전송 에너지는 비교가 안 될 만큼 낮아진다. d-Matrix가 인터뷰에서 강조한 “5배 적은 에너지"는 이 구조의 직접적인 산물이다.
이 선택은 두 가지 시장 신호와 맞물려 있다. 첫째, HBM 공급은 여전히 빠듯하고, 학습용 GPU가 HBM을 빨아들이는 한 추론 인프라는 늘 같은 줄에 서야 한다. 둘째, 추론 워크로드는 학습과 형태가 다르다. 작은 토큰을 끊임없이 흘려보내는 일이 많고, 그때마다 외부 메모리를 두드리는 구조는 비효율이 누적된다. SRAM 중심 아키텍처는 이 두 약점을 동시에 건드린다.
양산과 고객, 그리고 Nvidia를 넘지 않는 선
d-Matrix는 Corsair가 시제품이나 평가 보드 단계가 아니라고 명확히 했다. CNBC 영상에서 회사는 하이퍼스케일러, 네오클라우드, 프런티어 AI 랩에서 도입 약속을 받았다고 말했다. 각 고객사 이름은 영상에서 공개되지 않았지만, “추론 비용·전력을 당장 깎아야 하는 사업자"가 1차 고객이라는 그림은 분명하다.
전략 면에서 Corsair는 Nvidia를 정면으로 들이받지 않는다. 학습은 여전히 H100·B200 계열이 지배하는 영역이고, d-Matrix는 그 싸움에 들어가지 않는다. 대신 추론 단가라는 별도의 전선을 연다. 모델은 어디서 학습하든, 사용자가 실제로 부르는 순간은 추론이고, 그 부분에서만이라도 GPU를 빼낼 수 있다면 Nvidia가 통째로 지배하는 그림은 흔들린다. Groq, Cerebras, Tenstorrent가 비슷한 결의 주장을 내건 적이 있지만, d-Matrix는 SRAM-온-다이라는 단일 메시지로 차별화를 시도한다.
영상 안에서 회사가 회피한 항목도 있다. 모델 정확도, 지원 모델 범위(Llama·Mistral·Qwen 같은 오픈 가중치 모델 한정인지, 폐쇄형 모델까지 커버하는지), 그리고 칩당 메모리 용량이다. 추론 칩의 실사용 가치는 결국 “어느 크기의 모델까지 다이 위에 올라가느냐"로 결정되는데, 이 숫자가 공개되지 않은 점은 도입을 검토하는 쪽에서 가장 먼저 물어야 할 항목이다.
시장 맥락 — HBM·전력·추론 비용
Corsair가 등에 업은 메시지는 결국 시장의 세 가지 압력과 맞물린다. HBM은 학습용 GPU가 다 가져가 추론 인프라까지 도달하지 못하고, 데이터센터 전력은 점점 비싸지고 까다로워지고, 추론 비용은 LLM 서비스 사업자의 마진을 가장 직접적으로 누른다. SRAM 중심 추론 칩이 갑자기 관심을 끄는 이유는 기술적 우아함보다 이 압력 때문이다.
d-Matrix의 주장이 모두 사실이라면, 같은 와트당 더 많은 토큰을 뽑아내는 구조가 된다. 반대로 SRAM 용량 한계 안에 모델을 욱여넣어야 하는 제약은 분명히 존재한다. 70B급 모델을 단일 보드에 올릴 수 있는지, 여러 카드를 묶을 때 인터커넥트 비용이 얼마나 솟는지 같은 항목은 영상 밖에서 확인해야 한다.
실무자가 볼 핵심 포인트
- 추론 인프라 의사결정의 기본 가정이 흔들린다 — “HBM이 곧 추론 메모리"라는 전제는 SRAM-온-다이 설계가 양산에 들어선 시점에서 더 이상 안전한 가정이 아니다. 차세대 인프라 RFP에 SRAM 기반 가속기 항목을 추가해야 한다.
- 단일 칩 메모리 용량이 진짜 도입 조건이다 — d-Matrix가 영상에서 밝히지 않은 칩당 SRAM 용량과 지원 모델 크기는 도입 검토의 1번 질문이다. 70B 이상 모델을 단일 보드로 처리 가능한지, 분산 시 대역폭 저하는 얼마인지부터 확인해야 한다.
- 추론 단가가 마진 곡선이다 — Corsair가 약속한 “GPU 대비 5배 낮은 전송 에너지"가 절반만 실현되어도, LLM 서비스 사업의 토큰당 마진 곡선이 바뀐다. 가격표가 공개되는 즉시 자체 워크로드로 TCO를 재계산해야 한다.
- 학습/추론 분리 전략을 준비해야 한다 — 학습은 GPU, 추론은 전용 가속기로 나누는 이원화 인프라가 다시 현실 옵션이 된다. 운영 복잡도가 커지는 만큼 모델 배포 파이프라인과 관측 체계도 함께 손봐야 한다.
원문 출처
This Nvidia challenger says its AI chip is 10x faster than a GPU — CNBC (Katie Tarasov, Darren Geeter, Jeniece Pettitt), 2026-06-09. 원문: https://www.cnbc.com/video/2026/06/09/nvidia-challenger-d-matrix-says-its-ai-chip-is-10x-faster-than-a-gpu.html