개요
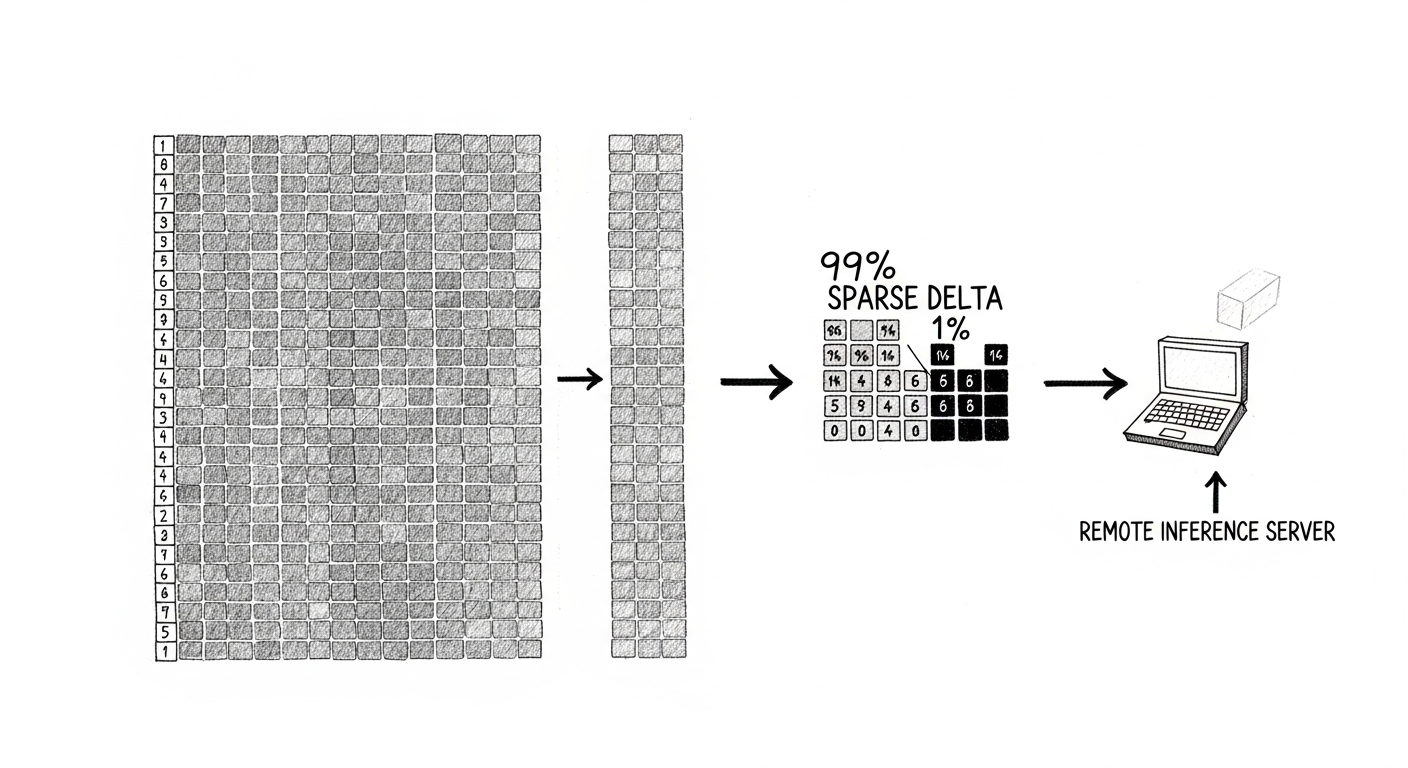
비동기 강화학습(Async RL)에는 근본적인 문제가 있다. 매 최적화 단계마다 업데이트된 모델 가중치를 추론 엔진으로 전송해야 한다. 7B 모델이면 단계당 14GB, 1T 파라미터 모델이면 매 단계 1TB다. 비현실적이다. HuggingFace TRL 팀이 이 문제를 수학적으로 풀었다. BF16 가중치의 99% 이상은 한 옵티마이저 단계에서 실제로 변하지 않는다. 변경된 부분만 희소(sparse) 인코딩으로 전송하면 1.2GB → 20~35MB가 된다.
핵심 요약
- 문제: Async RL에서 매 단계 전체 모델 가중치 전송 → 1T 모델 = 1TB/단계
- 발견: BF16 가중치 99% 이상이 한 단계에서 변하지 않음
- 해결: 변경된 파라미터만 희소 safetensors로 인코딩 → HF Bucket 경유 전송
- 결과: 1.2GB → 20~35MB (30~60배 감소), 추론 중단 ~1.1초
- Llama-405B 적용 시: 810GB → ~6GB 예상 (130배)
- 클러스터 불필요: GPU 1개 + HF 계정만으로 분산 Async RL 가능
본문
왜 비동기 RL이 문제인가
강화학습으로 LLM을 훈련할 때 GRPO 같은 알고리즘은 두 가지 역할이 필요하다. 새로운 데이터를 생성하는 추론과, 그 데이터로 모델을 업데이트하는 훈련이다.
동기 방식에서는 훈련이 끝날 때까지 추론이 멈춘다. 비동기 방식에서는 추론이 계속 돌아가지만, 매 훈련 단계마다 최신 가중치를 추론 엔진으로 보내야 한다.
문제는 이 전송 비용이다. 7B 모델 bf16 = 14GB. 단계마다 14GB를 전송한다. 1T 파라미터 모델이라면 매 단계 1TB다. 현실적으로 불가능한 수치다.
BF16 가중치의 수학적 성질
TRL 팀이 발견한 핵심은 BF16 표현의 수학적 특성이다.
BF16은 7비트 mantissa를 갖는다. 인접한 두 거듭제곱 사이에 128개의 표현값만 가능하다. 가중치 |w| 근처에서 인접한 두 값 사이의 간격은 |w| × 2^-7이다.
Adam 옵티마이저의 업데이트 크기는 대략 η × m̂/(√v̂ + ε)다. RL 학습률 η ≈ 3×10^-6, 일반적인 가중치 크기 0.01~0.1을 대입하면 업데이트 크기가 BF16의 표현 간격보다 작아진다.
결과적으로 업데이트가 반올림으로 흡수된다. 수백만 개의 파라미터에 이 효과가 적용되면 >99% 스파시티가 나온다. 실제로 Qwen2.5, Llama-3.2, Gemma-3에서 400단계를 측정한 결과 평균 스파시티는 99%, 최악의 경우도 98% 이상이었다.
구현: Delta와 Anchor
변경된 파라미터만 인코딩하는 두 가지 파일 형식이 있다.
Anchor (10단계마다): 전체 모델 스냅샷. 희소 업데이트가 누적되며 생기는 드리프트를 방지한다.
Delta (매 단계): 변경된 파라미터의 인덱스와 값만 담은 희소 파일.
deltas/step_000011.safetensors
├── layer.0.q_proj.weight.indices  (변경된 위치)
└── layer.0.q_proj.weight.values   (새 값)
metadata: sparse=True, sparsity=0.9938
변경 감지는 BF16ChangeDetector가 옵티마이저 단계 전후로 BF16 텐서를 직접 비교한다. Adam의 m, v 통계로 예측을 시도했지만 재현율이 30%에 그쳤다. 직접 바이트 비교가 정답이었다.
아키텍처: Hub Bucket이 중간 저장소
전체 구조는 세 부분이다.
[Trainer] → delta 생성 → [HF Bucket] ← 다운로드 ← [vLLM]
트레이너와 vLLM이 직접 통신하지 않는다. HF Bucket만 공유된다. vLLM 측 구현은 약 30줄이다. /update_weights 엔드포인트를 통해 동기화를 트리거하고, 희소 파일을 받아 스냅샷에 패치를 적용한다.
4단계 동기화 프로토콜:
- delta 업로드 (추론은 계속 실행)
- vLLM 일시 중지 (~100ms HTTP 호출)
/update_weights신호 전송- vLLM 재개
실측 결과
Qwen3-0.6B로 측정한 결과다.
| 항목 | 수치 |
|---|---|
| 단계당 페이로드 | 1.2GB → 20~35MB |
| 추론 중단 시간 | ~1.1초 |
| 백그라운드 업로드 | 8.3초 (추론과 병렬) |
Llama-3.1-405B에 외삽하면 810GB → ~6GB 예상, 중단 시간은 NCCL 경로 8초 대비 Bucket 경로 ~2초다.
완전 분산 Wordle 학습 데모
세 개의 독립적인 머신에서 동작하는 데모를 공개했다.
- Trainer: 로컬 GPU
- vLLM: HF Space (L4 GPU)
- Wordle 환경: HF Space (CPU, 256 동시)
공유 클러스터 없이 HTTPS만으로 연결된다. vLLM Space Dockerfile에 30줄 확장을 추가하고, 트레이너에서 --delta-sync-repo-id만 지정하면 된다.
결과: 보상 상승, 단계당 델타 20~35MB 유지, 동기화 중단 ~1초.
의미: 클러스터 없는 Async RL
이 기술이 열어주는 가능성이 있다.
GPU 1개와 HF 계정만으로 분산 Async RL이 가능해진다. 이전에는 공동 배치된 클러스터나 고속 네트워크 인프라가 필요했다. 멀티 복제본 추론도 같은 Bucket에서 각자 다운로드하면 되고, HF Bucket의 콘텐츠 기반 중복 제거로 전송 비용도 줄어든다.
실무자가 볼 핵심 포인트
- RL 훈련 인프라 재검토: Async GRPO나 유사한 알고리즘을 사용 중이라면, 가중치 동기화 병목이 실제로 있는지 측정해볼 것. Delta Weight Sync가 직접 적용 가능한 시나리오일 수 있다.
- BF16 스파시티는 공짜 점심이다: 학습률이 충분히 낮은 RL 파인튜닝 단계에서 이 성질이 자동으로 나타난다. 별도의 압축 알고리즘 없이 99% 희소성이 생긴다.
- HF Bucket이 중간 저장소로 유효: 트레이너와 추론 엔진이 같은 클러스터에 있지 않아도 된다. 서로 다른 클라우드, 서로 다른 지역에 분산 배포가 가능하다.
- safetensors 포맷의 디버깅 이점: NCCL 기반 전송과 달리 safetensors 파일은 직접 열어볼 수 있다. 어떤 파라미터가 얼마나 변했는지 추적이 가능하다.
- 현재 한계: CPU 스냅샷 중복, 고정 anchor 주기(10단계), multi-node FSDP2 미지원. 프로덕션 적용 전 이 제약사항을 확인할 것. PR #5417 진행 상황을 모니터링하면 된다.