DeepSeek V4 Preview 공개: 1M 컨텍스트를 전면에 내세운 AI 모델 업데이트
문서유형: 원문 기반 번역·해설
해시태그: #DeepSeek #DeepSeekV4 #DeepSeekAPI #1MContext #AI모델업데이트 #ReasoningModel #중국AI
핵심 요약
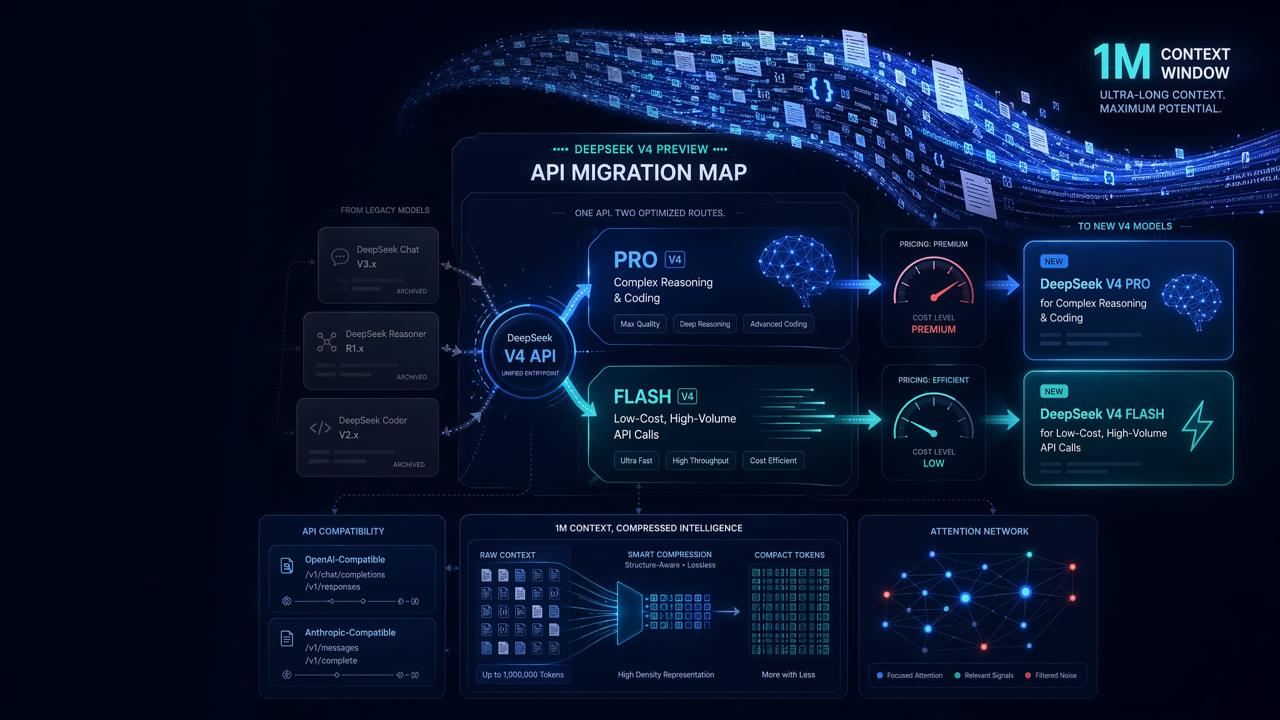
DeepSeek가 DeepSeek V4 Preview를 공개하며 API 사용자에게 중요한 변화를 예고했다. 이번 업데이트의 핵심은 deepseek-v4-pro와 deepseek-v4-flash의 이원화, 1M context window, OpenAI·Anthropic 호환 API, 그리고 기존 deepseek-chat·deepseek-reasoner의 종료 일정이다.
특히 DeepSeek V4 Flash는 낮은 API 비용과 긴 컨텍스트 처리 효율을 전면에 내세운다. 반면 DeepSeek V4 Pro는 복잡한 reasoning, agentic coding, 고난도 문서 분석에 맞춘 모델로 포지셔닝된다. 개발자 입장에서는 “어떤 모델이 더 좋은가”보다 “어떤 요청을 Flash로 보내고, 어떤 요청을 Pro로 승격할 것인가”가 더 중요한 문제가 됐다.
DeepSeek가 DeepSeek V4 Preview를 공식 공개했습니다. 이번 발표는 단순히 새 모델이 하나 더 추가됐다는 이야기로 보기 어렵습니다. 핵심은 훨씬 분명합니다. DeepSeek는 이번 V4 Preview를 통해 1M context, 즉 최대 100만 토큰 수준의 긴 컨텍스트 처리를 공식 서비스 전반의 중요한 기준으로 끌어올렸습니다.
최근 AI 모델 경쟁에서 성능만큼 중요해진 것이 있습니다. 바로 API 비용, 긴 문맥 처리 능력, reasoning model 성능, 그리고 agentic coding입니다. DeepSeek V4는 이 네 가지를 꽤 직접적으로 겨냥한 업데이트에 가깝습니다.
특히 DeepSeek API를 이미 쓰고 있는 개발자라면 이번 변화는 꽤 실무적으로 다가옵니다. 기존 base_url은 유지하면서 모델명만 바꾸면 새 모델을 호출할 수 있고, OpenAI Chat Completions 형식과 Anthropic API 형식도 함께 지원합니다.
DeepSeek V4 Preview 핵심 요약
이번 DeepSeek V4 Preview는 크게 두 가지 모델로 제공됩니다.
| 모델 | 전체 파라미터 | 활성 파라미터 | 핵심 포지션 |
|---|---|---|---|
deepseek-v4-pro | 1.6T | 49B | 고성능 추론, agentic coding, 복잡한 작업 |
deepseek-v4-flash | 284B | 13B | 빠른 응답, 낮은 비용, 대량 API 호출 |
쉽게 말하면 DeepSeek V4 Pro는 품질과 추론 성능을 우선하는 모델이고, DeepSeek V4 Flash는 속도와 비용 효율을 우선하는 모델입니다.
흥미로운 점은 Flash가 단순한 “저가형 모델”로만 소개되지 않았다는 것입니다. DeepSeek는 V4 Flash가 간단한 agent 작업에서는 V4 Pro에 가까운 성능을 낼 수 있다고 설명합니다. 즉, 모든 요청을 Pro로 보내는 방식보다, 작업 난이도에 따라 Flash와 Pro를 나눠 쓰는 전략이 더 현실적입니다.
왜 1M context가 중요한가
AI 모델에서 컨텍스트 길이는 단순히 “긴 글을 넣을 수 있다”는 의미를 넘습니다.
개발자 입장에서는 다음과 같은 작업이 훨씬 쉬워집니다.
- 대규모 코드베이스를 한 번에 분석하기
- 긴 기술 문서, 계약서, 리포트, PDF를 통째로 처리하기
- 여러 로그와 이슈 히스토리를 함께 넣고 디버깅하기
- 장기 대화 기반의 agent workflow 구성하기
- RAG에서 잘게 쪼갠 chunk에 덜 의존하고 큰 문맥을 직접 활용하기
기존에도 긴 컨텍스트를 지원하는 모델은 있었습니다. 문제는 비용과 지연 시간이었습니다. 입력 토큰이 길어질수록 API 비용은 빠르게 늘어나고, 긴 문맥을 자주 쓰는 서비스에서는 운영 부담이 커질 수밖에 없습니다.
DeepSeek V4 Preview는 이 지점을 정면으로 겨냥합니다. 공식 발표에서 DeepSeek는 “cost-effective 1M context length”를 강조했고, 이는 이번 업데이트의 가장 중요한 메시지라고 볼 수 있습니다.
구조적 변화: Sparse Attention과 압축 기반 효율화
DeepSeek V4에서 눈에 띄는 기술적 포인트는 긴 컨텍스트를 더 효율적으로 처리하기 위한 구조 개선입니다.
공식 발표와 기술 보고서에서 확인되는 핵심 키워드는 다음과 같습니다.
- token-wise compression
- DSA, DeepSeek Sparse Attention
- hybrid attention
- CSA + HCA
- mHC
- Muon optimizer
DeepSeek는 V4가 1M context 처리에서 기존 DeepSeek V3.2 대비 계산량과 KV cache 사용량을 크게 줄였다고 설명합니다.
| 모델 | V3.2 대비 FLOPs | V3.2 대비 KV cache |
|---|---|---|
| DeepSeek V4 Pro | 27% | 10% |
| DeepSeek V4 Flash | 10% | 7% |
여기서 중요한 것은 단순히 “더 빠르다”는 말이 아닙니다. 긴 컨텍스트를 실제 서비스에서 반복적으로 쓰려면 계산 비용과 메모리 비용을 낮춰야 합니다. DeepSeek V4는 이 병목을 줄이기 위해 attention 구조와 압축 방식을 적극적으로 손본 모델에 가깝습니다.
개발자 입장에서 무엇이 바뀌는가
이번 DeepSeek V4 업데이트에서 개발자가 가장 먼저 봐야 할 부분은 API 변경 사항입니다.
다행히 기존 DeepSeek API를 사용 중이라면 큰 구조 변경은 필요하지 않습니다. 공식 문서 기준으로 기존 base_url은 유지하고, 모델명만 다음 중 하나로 바꾸면 됩니다.
deepseek-v4-pro
deepseek-v4-flash
DeepSeek API는 OpenAI Chat Completions 형식과 Anthropic API 형식을 모두 지원합니다.
OpenAI 형식의 기본 base URL은 다음과 같습니다.
https://api.deepseek.com
Anthropic API 형식의 base URL은 다음과 같습니다.
https://api.deepseek.com/anthropic
지원 사양도 꽤 큽니다.
- 최대 컨텍스트: 1M tokens
- 최대 출력: 384K tokens
- Thinking / Non-thinking 모드 지원
- OpenAI Chat Completions 호환
- Anthropic API 호환
- Tool Calls 지원
- JSON Output 지원
실무적으로는 다음과 같은 전략을 생각해볼 수 있습니다.
일반 챗봇, 요약, 분류, 대량 호출
deepseek-v4-flash우선 검토
복잡한 reasoning, 코드 에이전트, 장문 분석
deepseek-v4-pro선택적 사용
기존 deepseek-chat 사용 서비스
deepseek-v4-flashnon-thinking 모드로 이전 테스트
기존 deepseek-reasoner 사용 서비스
deepseek-v4-flashthinking 모드 또는 난이도에 따라 Pro 검토
개인적으로는 “일단 Flash로 시작하고, 실패 비용이 큰 작업만 Pro로 올리는 방식”이 가장 현실적인 운영 전략에 가까워 보입니다.
DeepSeek pricing: Flash와 Pro 가격 비교
이번 업데이트에서 많은 개발자가 가장 먼저 볼 부분은 역시 DeepSeek pricing입니다.
공식 가격은 1M tokens 기준입니다.
| 모델 | 1M input cache hit | 1M input cache miss | 1M output |
|---|---|---|---|
| DeepSeek V4 Flash | $0.028 | $0.14 | $0.28 |
| DeepSeek V4 Pro | $0.145 | $1.74 | $3.48 |
가장 눈에 띄는 것은 DeepSeek V4 Flash의 입력 비용입니다. 특히 cache hit 기준 1M input이 $0.028이라는 점은 긴 컨텍스트를 반복적으로 사용하는 서비스에 꽤 공격적인 가격입니다.
물론 실제 API 비용은 캐시 적중률, 출력 길이, 호출 패턴, 동시성, 재시도 횟수에 따라 달라집니다. 하지만 긴 문서를 반복 분석하거나, 고정된 대형 컨텍스트를 기반으로 여러 질문을 처리하는 서비스라면 cache hit를 얼마나 잘 활용하느냐가 비용 최적화의 핵심이 될 가능성이 큽니다.
반대로 DeepSeek V4 Pro는 Flash보다 훨씬 비쌉니다. 대신 복잡한 추론, agentic coding, 고난도 reasoning model이 필요한 작업에서는 더 적합한 선택지가 될 수 있습니다.
정리하면, 이번 가격 구조는 “무조건 Pro를 쓰자”가 아니라 작업별 모델 라우팅이 더 중요해졌다는 신호에 가깝습니다.
Thinking Mode 사용 시 주의할 점
DeepSeek V4는 Thinking Mode와 Non-thinking Mode를 모두 지원합니다. 그런데 Thinking Mode에는 몇 가지 중요한 주의사항이 있습니다.
먼저, 공식 문서 기준으로 Thinking Mode는 기본 enabled입니다.
OpenAI 형식에서는 다음과 같은 설정을 사용할 수 있습니다.
{
  "thinking": {
    "type": "enabled"
  },
  "reasoning_effort": "high"
}
reasoning_effort는 high 또는 max 수준을 사용할 수 있습니다. 다만 Thinking Mode에서는 일반적으로 사용하는 샘플링 파라미터가 기대처럼 동작하지 않습니다.
공식 문서에 따르면 Thinking Mode에서는 다음 파라미터가 효과를 갖지 않습니다.
temperaturetop_ppresence_penaltyfrequency_penalty
기존 Chat Completions 방식에 익숙한 개발자라면 “temperature를 바꿨는데 왜 결과가 비슷하지?”라는 혼란이 생길 수 있습니다. Thinking Mode에서는 샘플링 조절보다 reasoning 설정이 더 중요합니다.
또 하나 중요한 부분은 tool calls입니다.
DeepSeek V4의 Thinking Mode는 tool calls를 지원하지만, 도구 호출이 포함된 멀티턴 흐름에서는 reasoning_content를 올바르게 이어서 전달해야 합니다. 이 처리가 빠지면 API가 400 오류를 반환할 수 있습니다.
단순 채팅에서는 문제가 없어 보여도, 실제 agent workflow에서는 이 부분이 오류의 원인이 될 수 있습니다. LangChain, 자체 agent runtime, OpenAI 호환 wrapper를 쓰고 있다면 반드시 별도 테스트가 필요합니다.
deepseek-chat, deepseek-reasoner 사용자는 마이그레이션 필요
이번 발표에서 놓치면 안 되는 부분이 하나 더 있습니다. 기존 모델 종료 일정입니다.
DeepSeek는 deepseek-chat과 deepseek-reasoner가 2026년 7월 24일 15:59 UTC 이후 완전히 종료되어 접근할 수 없게 된다고 안내했습니다.
현재 호환성 차원에서의 매핑은 다음과 같습니다.
| 기존 모델 | 현재 대응 |
|---|---|
deepseek-chat | deepseek-v4-flash non-thinking |
deepseek-reasoner | deepseek-v4-flash thinking |
즉, 기존 DeepSeek API 기반 서비스를 운영 중이라면 아직 시간은 있지만 마이그레이션 계획을 세워야 합니다.
추천 흐름은 간단합니다.
- 기존 요청/응답 로그 샘플을 수집합니다.
deepseek-v4-flash로 동일 요청을 테스트합니다.- reasoning이 필요한 요청은 thinking 모드와 비교합니다.
- 품질이 부족하거나 실패 비용이 큰 요청만
deepseek-v4-pro로 라우팅합니다. - 비용, 지연 시간, 오류율, 429 발생률을 함께 모니터링합니다.
- 종료일 전에 프로덕션 전환을 완료합니다.
Rate Limit과 연결 처리도 확인해야 한다
DeepSeek API는 서버 부하에 따라 사용자 concurrency를 동적으로 제한합니다. 제한에 도달하면 HTTP 429 응답을 받을 수 있습니다.
따라서 대량 호출이 있는 서비스라면 다음 처리가 필요합니다.
- 429 발생 시 재시도 로직
- 지수 백오프
- 동시 요청 수 제한
- 요청 큐 관리
- 긴 컨텍스트 요청의 별도 타임아웃 정책
- 모델별 라우팅과 fallback 설계
또한 요청이 서버로 전송된 뒤 응답을 기다리는 동안, 비스트리밍 요청에서는 빈 줄이 계속 반환될 수 있고 스트리밍 요청에서는 SSE keep-alive comment가 반환될 수 있습니다.
클라이언트가 응답을 직접 파싱한다면 이 빈 줄이나 keep-alive comment를 안전하게 처리해야 합니다. JSON만 엄격하게 기대하는 파서라면 여기서 문제가 생길 수 있습니다.
공식 문서에 따르면 요청 후 10분 이내에 inference가 시작되지 않으면 서버가 연결을 종료할 수 있습니다. 특히 1M context와 복잡한 reasoning 작업을 조합하는 경우라면 timeout, retry, idempotency 설계를 함께 점검하는 것이 좋습니다.
DeepSeek V4 Pro vs DeepSeek V4 Flash: 어떤 모델을 써야 할까
실무 기준으로 보면 선택은 비교적 명확합니다.
DeepSeek V4 Flash가 적합한 경우
- 일반 챗봇
- 문서 요약
- 텍스트 분류
- 간단한 코드 수정
- 짧은 agent task
- 비용 민감도가 높은 서비스
- 대량 API 호출
- 긴 컨텍스트를 자주 재사용하는 워크로드
DeepSeek V4 Pro가 적합한 경우
- 복잡한 코드베이스 분석
- agentic coding
- 고난도 reasoning
- 긴 문서 기반 의사결정
- 정확도가 중요한 업무 자동화
- 실패 비용이 큰 작업
- 품질이 비용보다 중요한 요청
대부분의 서비스에서는 Flash를 기본 모델로 두고, 난이도가 높거나 실패 비용이 큰 요청만 Pro로 승격하는 방식이 적합해 보입니다.
이 방식은 API 비용을 줄이면서도 품질을 확보할 수 있는 현실적인 전략입니다.
중국 AI 모델 경쟁에서 DeepSeek V4가 갖는 의미
공식 발표에서 확인되는 DeepSeek V4의 방향은 분명합니다. DeepSeek는 성능 경쟁뿐 아니라 긴 컨텍스트를 더 싸고 효율적으로 처리하는 API 모델을 전면에 내세우고 있습니다.
시장 관점에서 보면 이 부분이 중요합니다.
AI 모델 경쟁은 점점 두 갈래로 나뉘고 있습니다.
하나는 최고 성능 경쟁입니다.
다른 하나는 실제 서비스에 넣었을 때 감당 가능한 비용 구조입니다.
DeepSeek V4 Preview는 후자에 꽤 강하게 베팅한 업데이트로 볼 수 있습니다. 특히 1M context를 실사용 가능한 가격대와 API 호환성 안으로 끌어오려는 시도는 개발자와 기업 사용자에게 실질적인 의미가 있습니다.
물론 Preview 단계인 만큼 실제 품질, 안정성, latency, rate limit은 직접 테스트가 필요합니다. 공식 벤치마크나 발표만 보고 바로 프로덕션 전체를 이전하기보다는, 기존 워크로드 샘플로 비교 평가하는 과정이 필요합니다.
그럼에도 가격 구조와 API 호환성만 놓고 보면, 기존 DeepSeek 사용자뿐 아니라 OpenAI 호환 API를 쓰는 개발자들도 한 번쯤 검토해볼 만한 업데이트입니다.
정리: DeepSeek V4는 “긴 컨텍스트의 비용”을 겨냥한 업데이트
DeepSeek V4 Preview의 핵심은 명확합니다.
- 1M context 지원
- DeepSeek V4 Pro / DeepSeek V4 Flash 이원화
- 긴 컨텍스트 처리 비용 절감
- OpenAI / Anthropic API 호환
- Thinking / Non-thinking 모드 지원
- 기존 deepseek-chat, deepseek-reasoner 마이그레이션 필요
- Flash 중심의 비용 최적화 가능성
DeepSeek V4가 모든 영역에서 최고 모델이라고 단정하기는 이릅니다. 하지만 개발자 관점에서 보면 이번 업데이트는 꽤 실용적입니다.
특히 긴 문서, 대규모 코드베이스, agent workflow, reasoning model을 API로 운영해야 하는 팀이라면 DeepSeek V4 Flash와 Pro를 함께 테스트해볼 가치가 있습니다.
앞으로 AI 모델 경쟁은 단순히 “누가 더 똑똑한가”에서 끝나지 않을 가능성이 큽니다. 실제로는 “누가 더 긴 컨텍스트를 더 싸고 안정적으로 처리할 수 있는가”가 점점 더 중요해질 것입니다.
그 기준에서 DeepSeek V4 Preview는 분명히 주목할 만한 AI 모델 업데이트입니다.