DeepSeek V4 1.6T가 공개된 지 43일이 지났습니다. SemiAnalysis가 이 기간 동안 NVIDIA, AMD, 화웨이 진영의 추론 스택이 어떻게 진화했는지 추적한 보고서를 내놓았는데, 숫자가 흥미롭습니다. 같은 모델, 같은 하드웨어인데 26일 만에 처리량이 100배 늘어난 경우도 있었습니다. 오늘은 그 보고서를 한국어로 정리합니다.
핵심 요약
- AMD MI355X는 26일 만에 처리량 100배가 뛰었습니다. 출시 첫날에는 “기술적으론 돌긴 도는데 운영에 못 넣을 수준”이었는데, AITER·Triton·TileLang 커널을 새로 깔고 FP4 MoE를 붙이면서 H200과 어깨를 나란히 하는 구간이 생겼습니다.
- NVIDIA TensorRT-LLM은 첫날부터 사고가 있었습니다. hidden size 4096이 하드코딩돼 있는 상황에서 V4 Pro는 7168이라, 가드를 그냥 빼버리는 바람에 일주일 넘게 깨진 토큰을 뱉었습니다.
- GB300 NVL72는 SGLang 기준으로 모든 인터랙티비티 구간에서 1위를 차지했고, B300은 MegaMoE 덕분에 일주일 만에 처리량이 3배 늘었습니다.
- CSA(Compressed Sparse Attention)와 HCA를 교대로 끼우면 1M 토큰 컨텍스트에서 KV 캐시가 50배 줄어듭니다. 백만 토큰이 처음으로 “실제로 굴릴 만한” 영역에 들어왔다는 뜻입니다.
- 화웨이 Ascend 950DT는 코드네임이 “David”입니다. 골리앗인 NVIDIA를 의식하고 붙인 이름인데, AIC·AIV·CCU를 분리한 듀얼 코어 설계로 연산과 통신을 따로 돌리는 구조가 인상적입니다.
출시 첫날, 누가 굴렸고 누가 못 굴렸나
DeepSeek 같은 거대 MoE가 떨어지면 가장 먼저 시험대에 오르는 건 추론 프레임워크입니다. 이번 V4 1.6T에서 “Day 0에 바로 돌았다”고 부를 수 있는 스택은 두 개뿐이었습니다. CUDA 위의 vLLM·SGLang, 그리고 화웨이 CANN.
NVIDIA의 다른 한 축인 TensorRT-LLM은 첫날부터 사고가 났습니다. 코드 어딘가에 hidden size 4096이 상수로 박혀 있었는데, V4 Pro의 hidden size는 7168이었습니다. 정공법으로 가변 처리하지 않고 가드 클로즈를 빼버리는 선택을 했고, 그 결과 일주일 넘게 hidden state가 깨져 의미 없는 토큰이 쏟아졌습니다. SemiAnalysis 팀이 외부에서 수정 패치를 만들어 보내준 끝에 정상화됐다는 대목은, NVIDIA 진영도 단일하지 않다는 걸 잘 보여줍니다.
AMD ROCm/ATOM은 “돌긴 도는데 사람이 읽는 속도보다 느렸다”는 식의 첫 인상이었습니다. 다만 여기부터 이야기가 재미있어집니다.
AMD의 26일, 100배 향상은 어떻게 가능했나
AMD 엔지니어링 팀이 한 일을 한 줄로 줄이면 “PyTorch fallback을 죄다 걷어내고, 직접 짠 커널로 갈아끼웠다”입니다. 구체적으로는 세 가지가 동시에 들어갔습니다.
- AITER·Triton·TileLang 커널 교체. 느리지만 호환성 좋은 PyTorch 백업 경로를 빼고, MI355X용 전용 커널을 깔았습니다.
- FP4 가중치 MoE 지원. 메모리 대역폭이 발목을 잡는 MoE에서 FP4를 굴리는 건 단순한 양자화 이상의 작업입니다. dispatch·combine 경로까지 같이 손봐야 합니다.
- 어텐션 경로 최적화. CSA·HCA의 복합 컨텍스트를 받아내는 커널을 정리했습니다.
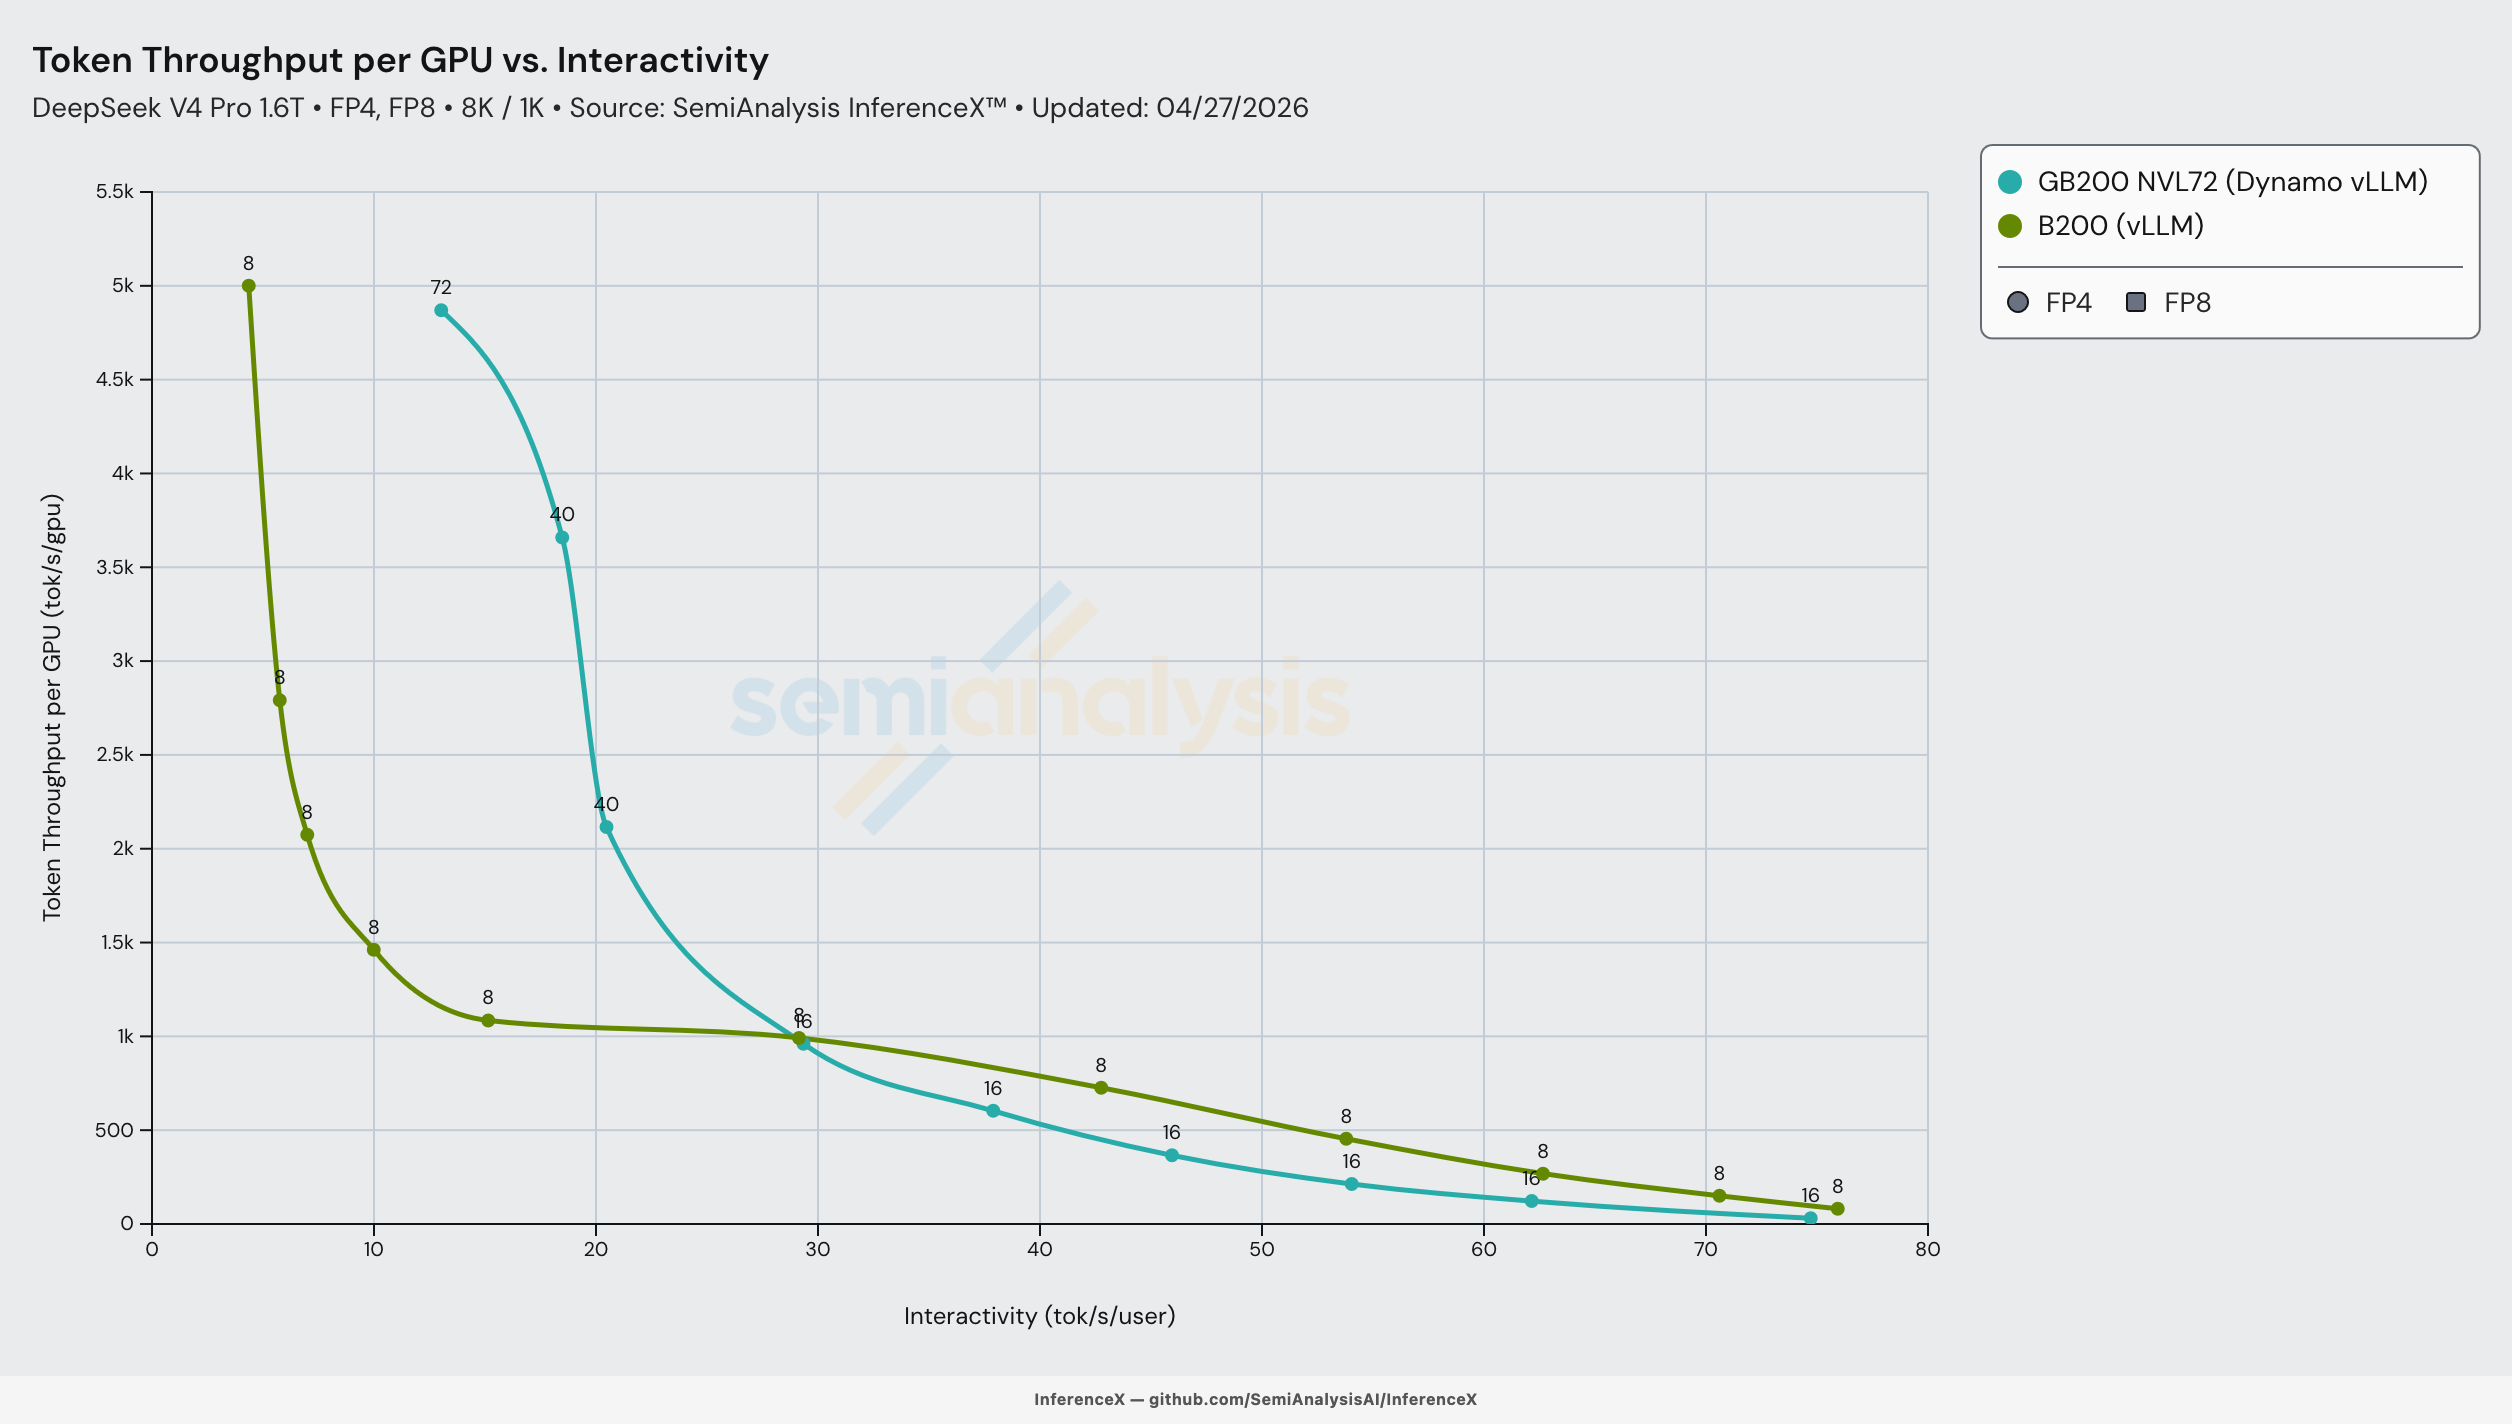
결과적으로 낮은 인터랙티비티 구간에서 MI355X가 H200과 비슷하거나 더 나은 성능을 내는 지점이 생겼습니다. “하드웨어가 약한 게 아니라 소프트웨어가 못 따라가고 있었다”는 오래된 가설이, DeepSeek V4라는 시험지 위에서 다시 한 번 입증된 셈입니다.
NVIDIA B200, 와트당 토큰이 60% 늘었다
같은 NVIDIA B200·vLLM 조합에서도 가만히 있으면 손해입니다. 출시 첫날과 6월 5일을 비교하면 메가와트당 초당 토큰이 약 30만에서 50만 가까이까지 올라갔습니다. 전력은 그대로인데 소프트웨어만 바뀐 “순수 SW 이득”입니다.
B300에서는 MegaMoE 커널 덕분에 일주일 만에 처리량이 3배가 됐고, GB300 NVL72는 SGLang 위에서 사실상 압도적인 1위 자리를 가져갔습니다. 같은 NVIDIA 진영 안에서도 세대 차가 큰 시점이라, 데이터센터 운영 입장에서는 “재고 B200을 더 짜낼지, 신규 GB300을 사들일지”를 다시 계산해야 하는 국면입니다.
MegaMoE: dispatch·combine 50% 비용을 깎는 커널
V4와 함께 등장한 새 MoE 커널이 MegaMoE입니다. 일반적인 MoE 구현은 실행 시간의 절반 가까이를 토큰을 expert에 보내고(dispatch) 다시 모으는(combine) 통신·재정렬에 쓰는데, 이게 바로 MoE의 고질적인 손해 구간입니다.
MegaMoE는 expert를 “파도(wave)” 단위로 스케줄해서, 한 expert가 연산하는 동안 다음 expert의 dispatch가 미리 흘러가도록 파이프라인을 잘게 쪼갭니다. 논문상 이론적 가속이 1.92배인데, 실제 GB300·B300에서 측정한 값도 비슷한 수준으로 나옵니다. 인프라 운영팀 입장에서는 “같은 모델, 같은 카드인데 커널만 갈아도 거의 두 배”라는 뜻이라 무시할 수 없습니다.
CSA·HCA, 100만 토큰을 실제로 돌리려는 시도
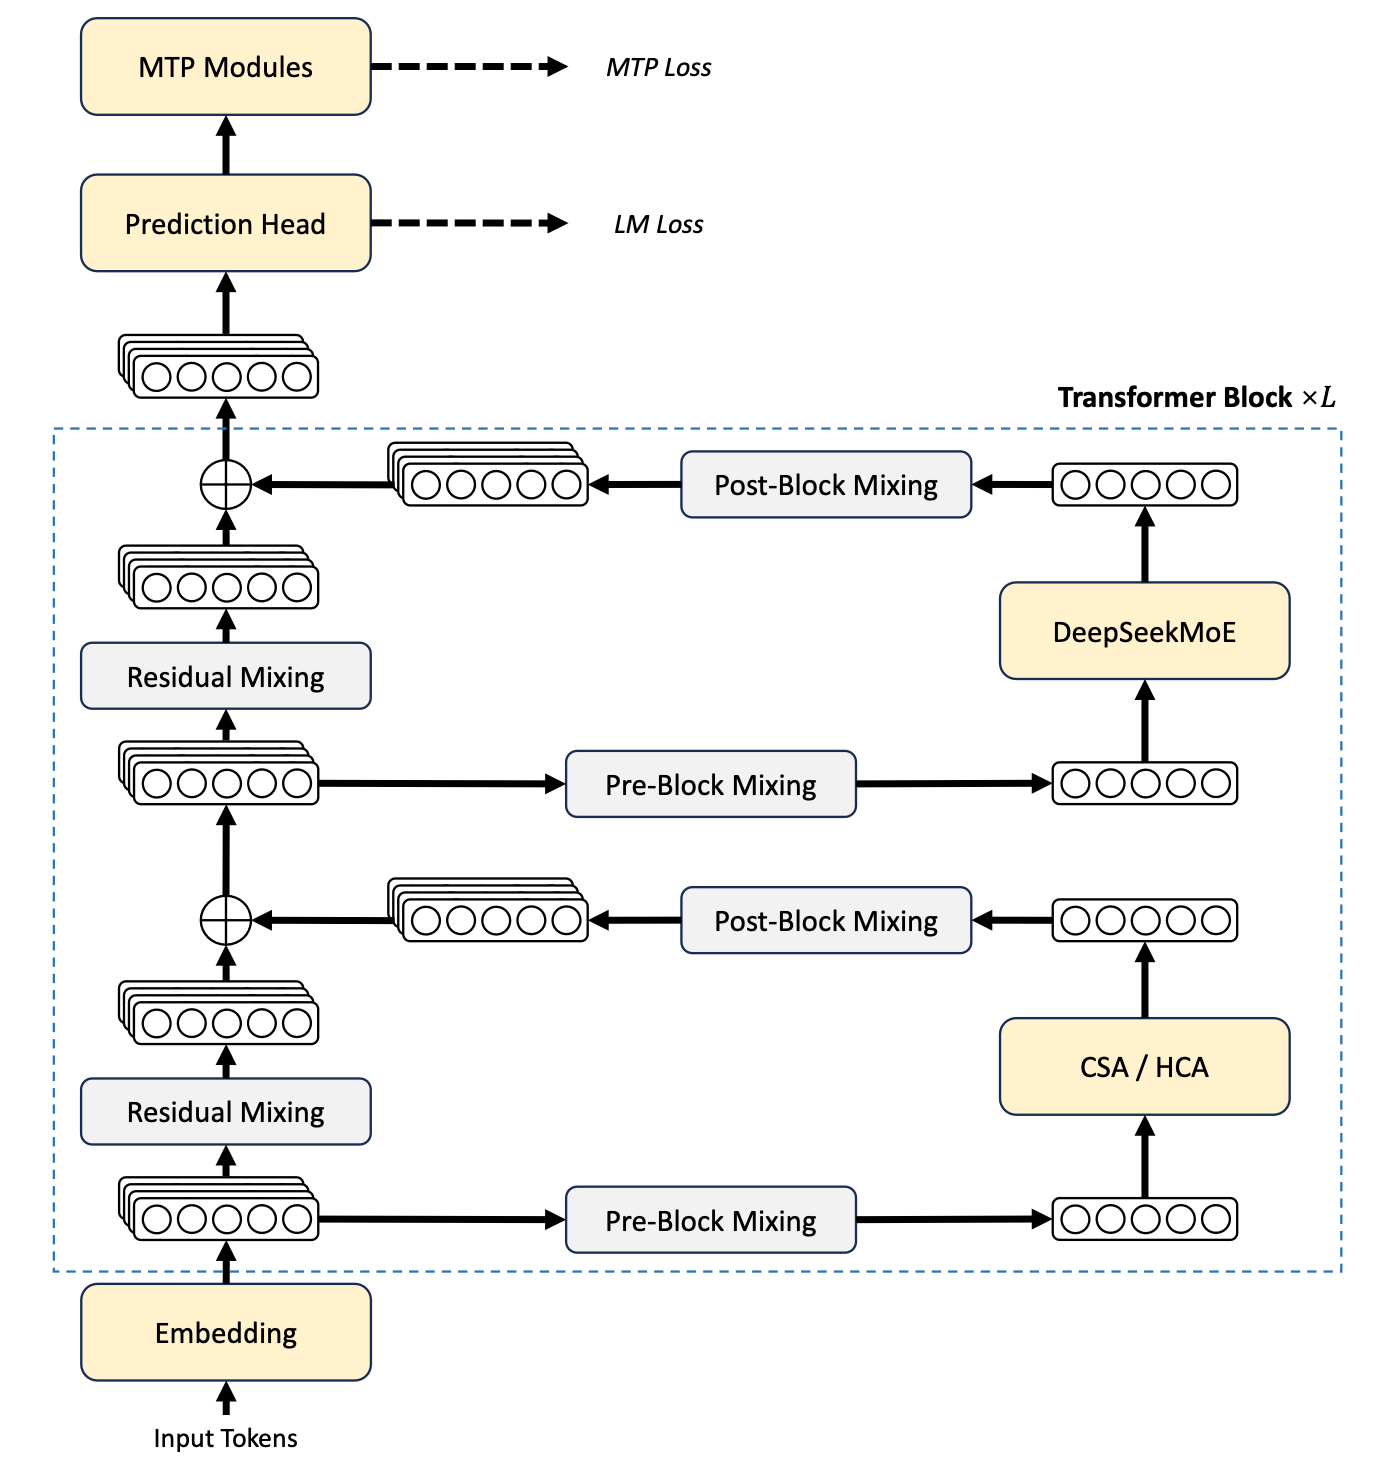
DeepSeek V4의 어텐션은 두 갈래입니다. **CSA(Compressed Sparse Attention)**와 **HCA(Heavily Compressed Attention)**를 레이어 단위로 교차시킵니다. 압축률은 각각 m=4와 m’=128. 두 가지가 같이 있어야 의미가 살아남으면서 메모리가 줄어듭니다.
결과만 보면 1M 토큰 컨텍스트 기준으로 KV 캐시가 50배 줄어듭니다. 100만 토큰이 백서 속의 마케팅 수치가 아니라, GPU 한 대에서 실제로 굴릴 수 있는 영역으로 들어왔다는 얘기입니다. 다만 vLLM 같은 추론 서버 입장에서는 페이지 크기 버킷팅·논리 블록 사이즈를 두 압축률의 공약수로 맞춰야 해서, 단순히 모델을 “얹는” 작업이 아니라 메모리 매니저까지 같이 고치는 작업이 됩니다.
화웨이 Ascend 950DT, “David”라는 이름
화웨이가 Ascend 950에 붙인 코드네임이 “David”라는 점은 상징적입니다. 골리앗을 향해 던지는 돌 한 개라는 의미인데, 설계상의 결정도 그 이름값을 합니다.
- AIC(AI Cube): 행렬 연산 전용 코어.
- AIV(AI Vector): 활성화·정규화 같은 elementwise 연산용.
- AI CPU: 동적 shape·제어 흐름을 처리하는 온칩 ARM64.
- CCU: collective 통신을 따로 도는 통신 엔진.
핵심은 CCU가 연산 코어와 독립적으로 동작한다는 점입니다. 압축기(compressor)와 인덱서(indexer)가 본 연산과 다른 스트림에서 동시에 돌아가니, 통신이 연산을 막는 구조가 줄어듭니다. CANN이 Day 0 지원을 해냈다는 사실도, 이런 하드웨어 분할 설계와 무관하지 않아 보입니다.
가려진 비용: 결정론과 KV 캐시 관리
좋은 숫자만 있는 건 아닙니다. DeepSeek는 RL 학습 안정성을 위해 모든 연산에서 batch-invariant 커널을 강제했습니다. 같은 입력이면 배치 크기와 상관없이 같은 출력을 보장하라는 뜻인데, 이게 성능을 깎습니다. 흔히 쓰는 빠른 알고리즘 기법이 막히기 때문입니다. 운영 입장에서는 “결정론을 풀면 성능이 더 나오지만, RL 파이프라인이 다시 깨질 수 있다”는 트레이드오프를 그대로 떠안게 됩니다.
KV 캐시 관리도 만만치 않습니다. CSA와 HCA의 압축률이 다르다 보니, vLLM은 두 압축률을 모두 나눠 떨어뜨릴 수 있는 논리 블록 크기를 새로 잡아야 했습니다. 페이지 크기 버킷팅이 안 맞으면 메모리 단편화가 그대로 성능 손실로 돌아옵니다.
실무자가 볼 핵심 포인트
- 신규 모델 추론 평가는 “Day 0 숫자”로 끝내지 말 것. AMD 사례에서 보듯, 한 달 뒤 같은 카드의 성능이 100배 좋아질 수 있습니다. 의사결정 기간을 최소 30일은 잡는 게 안전합니다.
- vLLM·SGLang은 사실상 기본값. 두 스택 모두 Day 0 지원을 안정적으로 보여주고 있어, 새 모델을 우선 검증할 때 가장 먼저 들어가야 할 후보입니다.
- TensorRT-LLM 같은 폐쇄형 스택은 “검증된 모델”에만 쓰자. hidden size 가정처럼 숨은 상수 때문에 출시 직후 모델에서 깨진 토큰을 받을 수 있습니다. 외부 패치가 도착할 때까지 운영 라인에 올리지 않는 편이 안전합니다.
- MoE 추론에서 dispatch·combine을 측정하지 않으면 절반을 놓친다. MegaMoE 도입 전에 이 구간 비율을 먼저 재 두면, 커널 교체로 얻을 이득을 정량적으로 잡을 수 있습니다.
- 100만 토큰 컨텍스트는 이제 “KV 캐시 관리 문제”다. 모델 차원에서는 CSA·HCA로 해결됐지만, 추론 서버의 페이지·블록 정책을 같이 손대지 않으면 메모리 단편화로 성능이 무너집니다.
- AMD·화웨이 옵션을 진지하게 다시 보자. 가격·전력 협상 카드를 만들고 싶다면, MI355X와 Ascend 950DT를 PoC 후보에 넣는 비용이 한 달 전보다 훨씬 낮아졌습니다.
정리하면
DeepSeek V4의 43일은 “하드웨어 경쟁”이 아니라 “커널 경쟁”이었습니다. 같은 카드를 들고 누가 빨리 dispatch·combine을 정리했느냐, 누가 KV 캐시 매니저를 다시 깎았느냐가 성능 곡선을 갈랐습니다. NVIDIA는 여전히 GB300으로 정상에 있지만 일주일 단위로 흔들리는 구간이 있고, AMD는 처음으로 “선택지”라는 단어가 어색하지 않은 자리에 올라왔습니다. 화웨이는 다음 모델 출시에서도 Day 0 지원을 해내는지가 관전 포인트가 될 겁니다.
원문: DeepSeekV4 1.6T Day 0 to Day 43 Performance Over Time — GB300 NVL72, Huawei, MI355X, B200, SemiAnalysis Newsletter (Bryan Shan, Cam Quilici, Kimbo Chen 외)