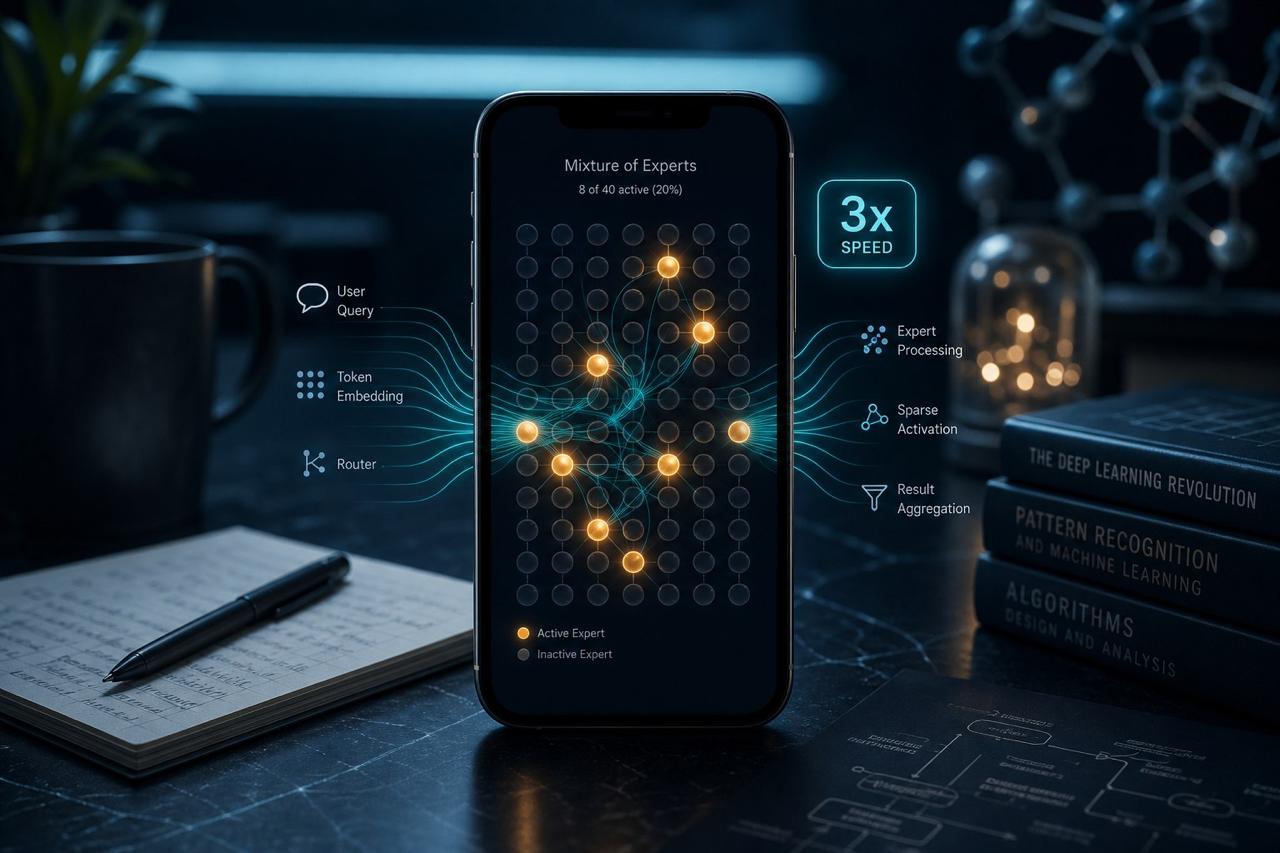
핵심 요약
- 새로 공개된 DECO는 sparse MoE를 dense Transformer 성능에 매칭시키는 아키텍처다 — 동일 total parameter 예산·학습 토큰 조건에서.
- 핵심은 세 가지: ① 학습 가능한 expert-wise scaling이 결합된 ReLU 기반 라우팅, ② SiLU 앞에 normalize를 두는 NormSiLU 활성화, ③ non-gated MLP expert + ReLU 라우팅 조합.
- 전체 expert 중 20%만 활성화해도 dense 모델 성능을 따라잡고, 기존 MoE baseline을 능가했다.
- 전용 가속 커널 적용 시 실제 하드웨어에서 dense 추론 대비 3.00× speedup.
- 코드와 체크포인트가 공개 예정이라 온디바이스 LLM에 MoE를 진지하게 적용해볼 첫 실용적 후보가 될 가능성이 있다.
MoE는 왜 온디바이스에서 잘 안 됐나
Mixture-of-Experts(MoE)는 LLM 효율화의 단골 후보다. 전체 capacity는 크게, 한 번 추론에 쓰는 계산은 작게. 클라우드 환경에서는 이 트레이드오프가 매력적이지만, 휴대폰·노트북·임베디드 같은 end-side(온디바이스) 환경으로 옮기면 다른 문제가 튀어나온다.
문제는 storage와 memory-access다. sparse activation으로 GPU 계산은 적게 쓰더라도, MoE 모델은 전체 expert 파라미터를 메모리에 올려두거나 빠르게 접근할 수 있어야 한다. 디바이스 측에서는 이게 사실상 큰 모델 한 번 통째로 올리는 비용과 다르지 않다. 결과적으로 “온디바이스 + 고성능 + 작은 storage 오버헤드"라는 세 조건을 동시에 만족시키는 MoE 설계는 빈자리로 남아 있었다.
이건 단순한 엔지니어링 이슈가 아니다. MoE의 본래 가정은 “expert별 전문화 + sparse activation으로 한 번 추론에 필요한 계산만 쓰기"인데, end-side 환경에서는 그 전문화 효과가 살아남기 전에 메모리·디스크 I/O가 먼저 병목을 만든다. 그래서 모바일·노트북 LLM에서는 dense 모델로 후퇴하거나, distillation으로 모델을 줄이거나, MoE를 아예 포기하는 것이 일반적이었다. DECO는 이 우회로 대신 MoE 자체를 손봐서 같은 자리에 도달하려 한다.
DECO가 풀어낸 세 가지
DECO는 이 빈 자리를 메우기 위해 다음 세 요소를 한 묶음으로 제시한다.
1. ReLU 기반 라우팅 + expert-wise scaling
기존 MoE의 top-k 라우터는 미분 가능하지만 경직돼 있다. DECO는 ReLU 기반 라우팅을 채택해 미분 가능성과 유연성을 모두 확보한다. 거기에 learnable expert-wise scaling을 더해 routed expert와 shared expert의 기여도를 적응적으로 균형 잡는다. 라우팅 자체가 학습 신호에 따라 sparsity 정도와 expert 선택 패턴을 함께 조정하는 셈이다.
2. NormSiLU — SiLU 앞의 정규화
활성화 함수 자체도 손봤다. NormSiLU는 SiLU 연산 이전에 입력을 normalize한다. 효과는 두 가지로 보고됐다.
- routed expert의 활성화 비율 추이가 더 안정적.
- 모델의 intrinsic sparsity가 더 높아짐 — 외부에서 강제하지 않아도 자체적으로 더 적은 expert를 쓰는 경향.
이 두 효과는 sparse MoE의 고질적 불안정성(라우팅 collapse, hot expert 편중)을 누르는 방향으로 작용한다.
3. Non-gated MLP expert + ReLU 라우팅
저자는 expert 내부를 gated MLP(SwiGLU 류) 대신 non-gated MLP로 가져갈 때 ReLU 라우팅과 결합 시 경험적 이점이 있음을 관찰했다. 흔히 MoE expert는 dense Transformer의 gated MLP를 그대로 가져다 쓰는데, DECO 결과는 이 관행이 sparse 환경에서는 최적이 아닐 수 있음을 시사한다. MoE 아키텍처 단순화 가능성을 여는 발견이다.
결과 — 20% expert로 dense 매칭, 3배 가속
수치는 단순하지만 강하다.
- 동일 total parameter 예산과 학습 토큰 조건에서 DECO는 dense Transformer 성능을 매칭했다.
- 한 번 추론에 활성화되는 expert는 전체의 20%.
- 기존 MoE baseline들을 능가.
- 특수 가속 커널이 결합된 실제 하드웨어 추론에서 dense 대비 3.00× speedup.
여기서 핵심은 “활성화 20%“가 단순한 압축 비율이 아니라 실제 메모리 접근과 계산을 함께 줄였다는 점이다. 가속 커널이 sparse activation 패턴을 하드웨어 측에서 효율적으로 처리하기 때문에, 이론적 FLOPs 절감이 실측 latency 단축으로 옮겨졌다. 논문 자체도 14페이지·11개 그림·11개 표 분량으로 ablation과 hyperparameter sweep을 충실히 포함하고 있어, 단일 수치 자랑이 아니라 설계 선택지마다의 비교가 따라붙는다.
시사점 — MoE를 다시 보게 만드는 결과
DECO 자체보다 방향성이 더 의미 있다. 지난 몇 년간 MoE 연구는 expert를 늘리고 routing을 정교화하는 방향으로 흘러왔다. DECO는 그 반대다.
- gated MLP를 단순화한 non-gated MLP.
- top-k 대신 ReLU 라우팅.
- 활성화 함수 한 줄(NormSiLU)로 sparsity 안정화.
복잡도를 늘려 성능을 짜내는 게 아니라 구조를 단순화하고 활성화·라우팅을 정렬해 dense 수준에 도달한다. 온디바이스 배포라는 분명한 사용 사례가 있고 가속 커널까지 동반된 상태로 공개되기에, 후속 연구·산업 적용이 빠르게 따라붙을 가능성이 높다.
이 흐름은 최근 LLM 분야 전반의 “단순화 회귀” 경향과 맞물린다. Transformer attention의 단순화(linear·hybrid attention) 시도, MoE 라우팅의 단순화, 활성화 함수와 normalization 자리 재배치 — 모두 같은 시기에 일어나는 흐름이다. 모델을 더 크게 쌓는 것보다, 이미 쌓은 구조에서 불필요한 복잡도를 걷어내 효율을 회수하는 방향이 새로운 경쟁선이 되고 있다.
실무자가 볼 핵심 포인트
| 구분 | 시사점 |
|---|---|
| 온디바이스 LLM 후보 | dense 매칭 + 3× 가속 + 20% 활성화 → 휴대폰·노트북 추론 엔진의 새 후보 |
| MoE 단순화 가능성 | gated MLP·top-k 라우팅 관행을 재검토할 실증 근거 |
| NormSiLU 채택성 | 활성화 함수만 바꿔도 sparsity 안정화 효과 — 기존 모델 ablation에 적용 가능 |
| 가속 커널 의존도 | 3× speedup은 전용 커널 전제 — 일반 추론 엔진에서는 효과 다를 수 있음 |
| 재현 가능성 | 코드·체크포인트 공개 예정 — 발표 후 첫 검증 라운드 빠를 것 |
| 연구 흐름 위치 | “MoE를 더 복잡하게” 흐름과 갈라지는 단순화 라인의 신호탄 |
dense 모델로 가는 길과 sparse MoE로 가는 길이 사실상 갈라져 있던 온디바이스 LLM 영역에서, DECO는 두 길이 같은 곳에서 만날 수 있음을 처음으로 정량 입증한 결과에 가깝다.
원문 출처
원문: DECO: Sparse Mixture-of-Experts with Dense-Comparable Performance on End-Side Devices — Chenyang Song, Weilin Zhao, Xu Han, Chaojun Xiao, Yingfa Chen, Zhiyuan Liu, arXiv:2605.10933, 2026.05.11