출처: Databricks
문서유형: 번역·해설
#Databricks #AgentMemory #AIAgent #MemAlign #LLMOps
핵심 요약
Databricks는 AI 에이전트 성능을 키우는 새로운 축으로 memory scaling을 제안합니다. 더 큰 모델이나 더 긴 추론만으로는 부족하고, 에이전트가 과거 대화, 피드백, 성공·실패한 실행 궤적, 조직 지식을 얼마나 잘 저장하고 꺼내 쓰는지가 성능을 좌우한다는 관점입니다.

메모리 스케일링이란 무엇인가
메모리 스케일링은 에이전트의 외부 메모리가 커질수록 성능이 좋아지는 현상을 말합니다. 여기서 메모리는 모델 가중치도 아니고, 지금 프롬프트에 넣은 긴 컨텍스트도 아닙니다. 에이전트가 추론 시점에 검색하고 활용할 수 있는 지속적인 정보 저장소입니다.
이 접근은 continual learning과도 다릅니다. 모델 파라미터를 계속 업데이트하는 대신, 모델은 그대로 두고 외부 상태를 키웁니다. 한 사용자의 성공적인 작업 패턴이 저장되면, 같은 환경의 다른 사용자에게도 바로 도움을 줄 수 있습니다. 재학습 없이 경험이 쌓이는 구조입니다.
긴 컨텍스트가 메모리를 대체하지 못하는 이유
긴 컨텍스트 창은 편리해 보이지만 비용과 latency가 큽니다. 관련 없는 토큰까지 함께 들어오면 모델의 집중도도 떨어집니다. Databricks가 말하는 메모리 스케일링은 “많이 넣기”가 아니라 “필요한 것만 골라 넣기”에 가깝습니다.
메모리도 종류가 나뉩니다. 과거 대화와 tool-call 기록 같은 episodic memory, 반복되는 규칙과 패턴을 추출한 semantic memory, 개인 선호와 조직 공통 지식을 구분하는 범위 설정이 모두 필요합니다.
MemAlign 실험: 기억이 많아질수록 더 정확하고 빨라졌다
Databricks는 MemAlign을 Genie Spaces에 적용해 실험했습니다. Genie Spaces는 사용자가 자연어로 데이터 질문을 던지면 SQL 기반 답변을 받는 환경입니다.
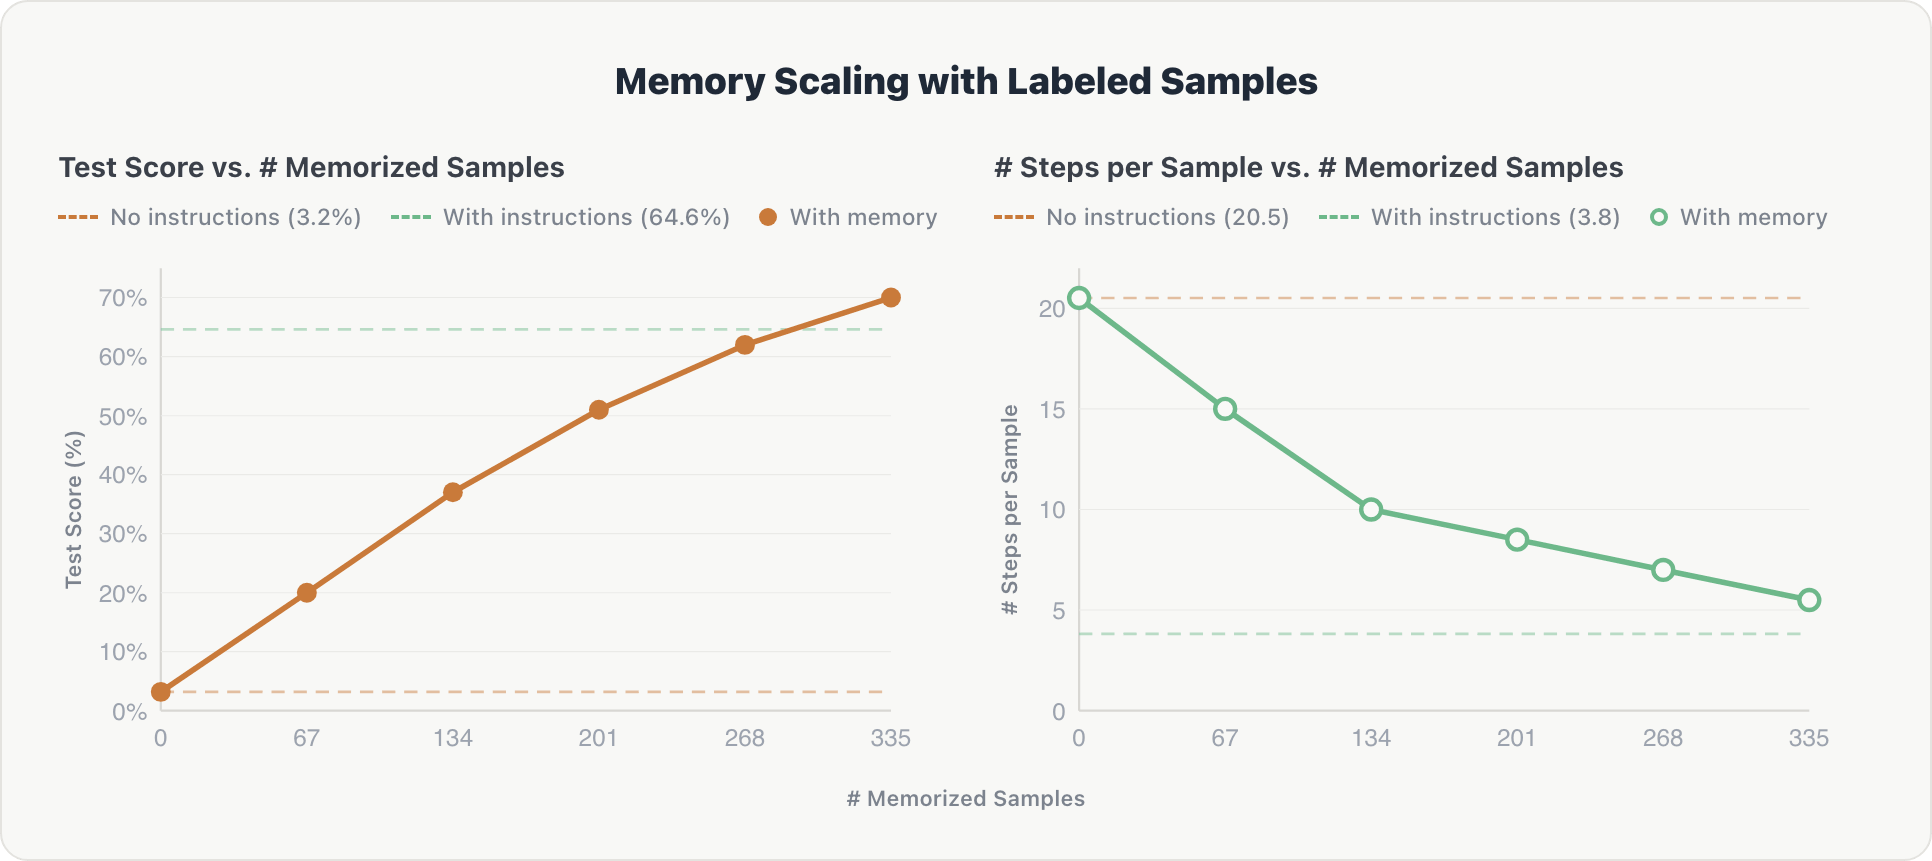
라벨링된 예시를 메모리에 단계적으로 추가하자 테스트 점수는 거의 0%에서 70%까지 올라갔고, 전문가가 직접 작성한 baseline보다 약 5% 높아졌습니다. 동시에 평균 reasoning step은 약 20단계에서 5단계로 줄었습니다. 에이전트가 매번 데이터베이스를 처음부터 탐색하지 않고, 이전에 쌓인 맥락을 바로 찾았기 때문입니다.
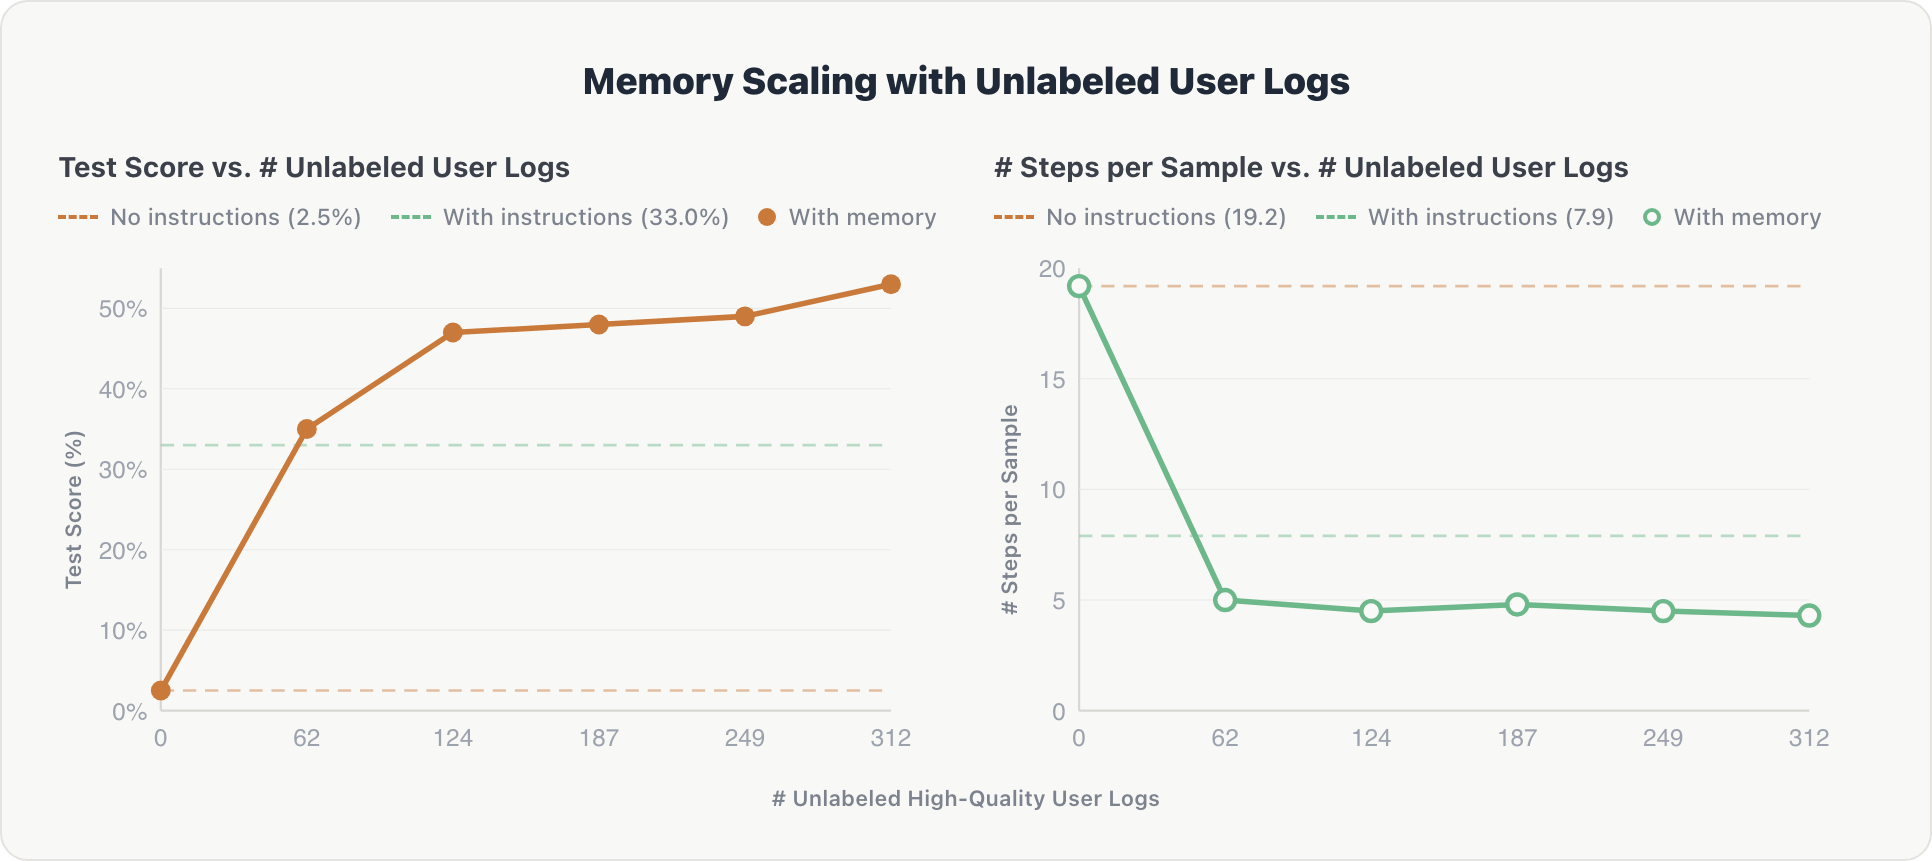
더 흥미로운 건 라벨 없는 사용자 로그 실험입니다. LLM judge가 유용한 로그만 골라 메모리에 넣었는데, 첫 번째 로그 shard 이후 성능이 2.5%에서 50% 이상으로 뛰었습니다. 비싼 수작업 지침 없이도 실제 사용 흔적이 좋은 메모리가 될 수 있다는 뜻입니다.
조직 지식 저장소와 보안
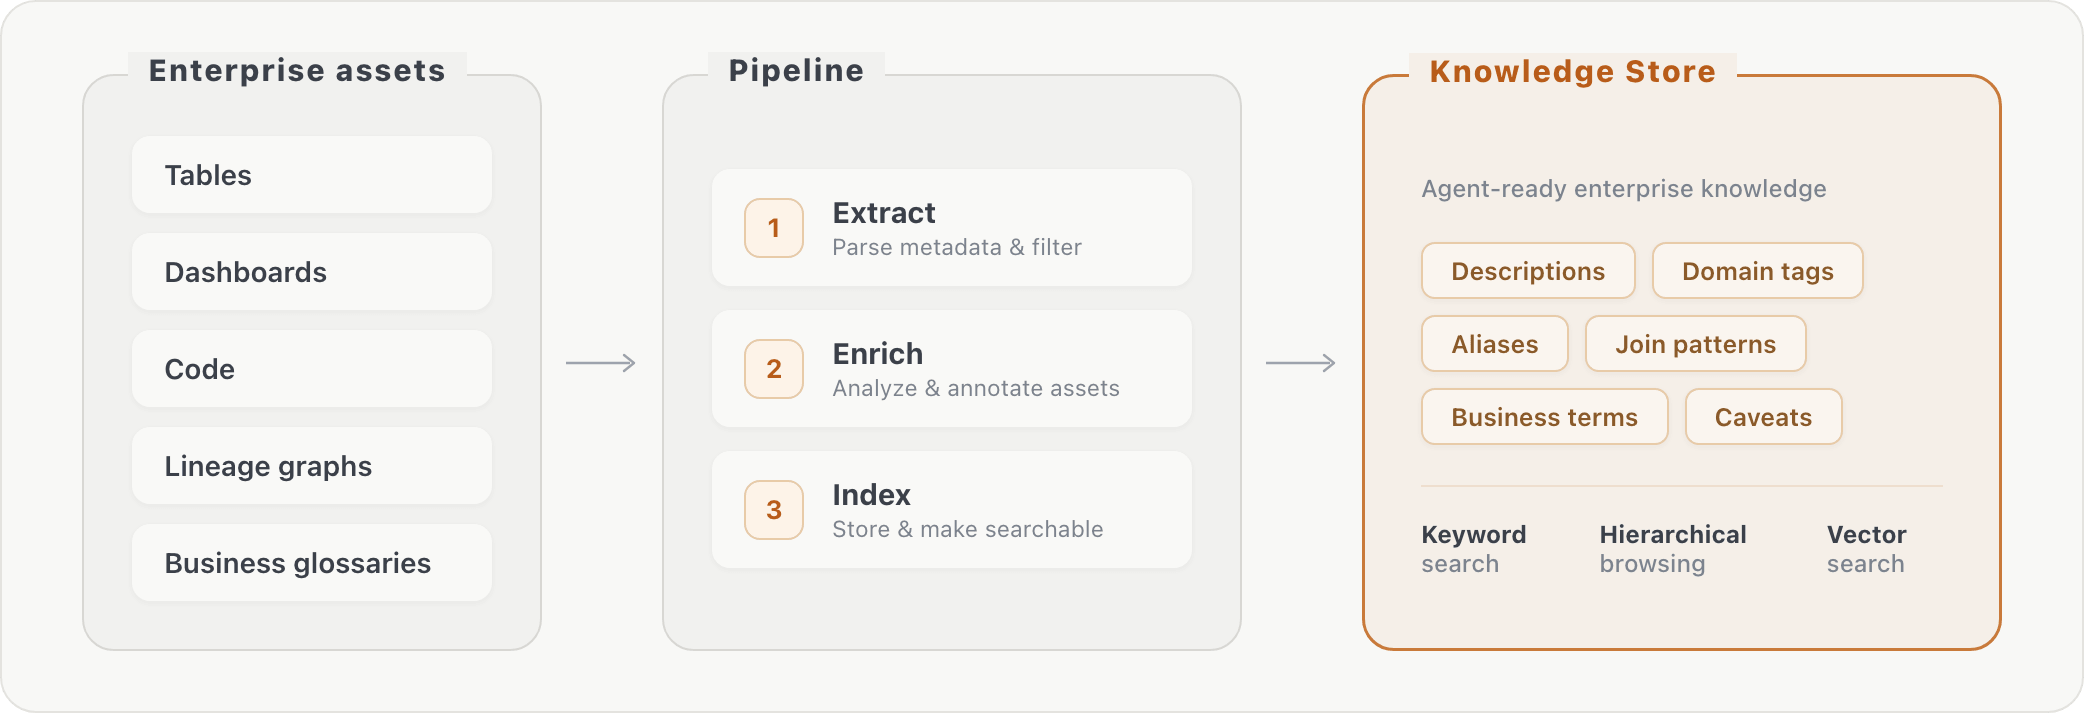
기업 환경에서는 대화 기록보다 먼저 존재하는 지식이 많습니다. 테이블 스키마, 대시보드 쿼리, 비즈니스 용어집, 내부 문서 같은 것들입니다. Databricks는 이런 자산을 추출·가공·색인하는 조직 지식 저장소를 실험했고, 두 벤치마크에서 정확도가 약 10% 개선됐다고 설명합니다.
다만 메모리가 커질수록 거버넌스는 더 중요해집니다. 개인 메모리와 조직 지식은 섞이면 안 되고, 접근 권한·라인리지·감사 로그·삭제 요청 대응이 필요합니다. 한 번 잘못 저장된 기억은 반복적으로 잘못된 답변을 만들 수 있기 때문에, provenance와 freshness도 함께 관리해야 합니다.
실무자가 볼 포인트
이 글의 핵심은 “에이전트를 더 똑똑하게 만들려면 모델만 바꾸지 말라”는 것입니다. 도메인 지식, 사용자 피드백, 성공한 작업 흐름, 실패한 실행 기록을 안전하게 모으고 정제하는 메모리 계층이 필요합니다.
특히 기업용 에이전트라면 세 가지를 먼저 봐야 합니다. 첫째, 어떤 정보를 episodic memory로 남기고 어떤 정보를 semantic memory로 압축할지. 둘째, 개인·팀·조직 범위를 어떻게 나눌지. 셋째, 오래되거나 틀린 메모리를 어떻게 검증하고 지울지입니다.
정리
메모리 스케일링은 단순히 과거 기록을 많이 저장하는 일이 아닙니다. 에이전트가 필요한 기억을 찾고, 적절한 범위에서 쓰고, 시간이 지나도 안전하게 관리하도록 만드는 아키텍처입니다. 모델 성능이 비슷해질수록 차이는 “어떤 모델을 쓰는가”보다 “어떤 경험을 축적했는가”에서 날 가능성이 큽니다.