큰 모델은 시 한 편도 쓰고 코드도 짭니다. 그런데 사진 한 장 던져주고 “이 안에 사람 몇 명?“이라고 물으면 의외로 잘 못 셉니다. 박스를 그리는 모델, 점을 찍는 모델, 군중을 헤아리는 모델이 따로따로 있고 서로 잘하는 영역도 다릅니다.
칭화대 연구진이 6월 13일 공개한 Count Anything은 이 갈래를 하나로 묶으려는 시도입니다. 메타가 만든 SAM3(이미지·텍스트를 같이 처리하는 사전학습 백본) 위에 두 개의 어댑터를 얹어, 텍스트로 “세고 싶은 것"만 지정하면 사진 도메인을 가리지 않고 숫자를 셉니다.
개요
핵심 아이디어는 간단합니다. 밀도가 낮으면 박스를, 빽빽하면 점을 쓰는 거죠. 사람·차량처럼 또렷이 보이는 큰 객체는 영역(region) 카운터가 박스로 잡아 세고, 세포나 군중처럼 작고 다닥다닥 붙은 객체는 픽셀(pixel) 카운터가 점을 찍어 셉니다. 두 카운터가 같은 대상을 동시에 잡으면 중복 제거 로직이 한 번만 인정해 줍니다.
학습은 CLOC이라는 새 데이터셋으로 했습니다. 약 22만 장 이미지에 619개 카테고리, 1,500만 개에 가까운 객체 라벨이 들어 있고, 일반 풍경부터 위성, 병리 슬라이드, 세포 현미경, 농업, 미생물까지 여섯 개 도메인을 한 통에 담았습니다. 한 모델로 의료 영상도, 드론 사진도, 길거리 인파도 다루겠다는 욕심입니다.
핵심 요약
- 백본은 SAM3, 그 위에 영역 카운터 + 픽셀 카운터 두 어댑터만 학습. 베이스 모델은 손대지 않습니다.
- CLOC 데이터셋: 약 22만 장 이미지, 619개 카테고리, 약 1,500만 개 라벨, 6개 도메인 통합.
- 카테고리별 평균 오차가 약 9개. CountGD·CLIP-Count·Grounding DINO 같은 비교군은 오차 18개 이상.
- MAE·RMSE는 학습 데이터가 늘수록 거의 선형으로 떨어진다는 스케일링 곡선 확인. “데이터 더 부으면 더 좋아진다"는 신호.
- 군중 카운팅 전용 시스템과는 호각 수준. 압도하지는 않습니다.
- 약점: 모호한 단어(“작은 사람” 같은 표현), 극단적으로 빽빽하고 가려진 장면.
본문
왜 ‘세는 일’이 어렵나
세는 일은 사람이 보면 너무 당연한데, 모델한테는 함정이 많습니다. 박스 검출 모델은 객체가 또렷하고 듬성듬성할 때는 강하지만, 픽셀이 몇 개 안 되는 작은 점들이 빽빽이 깔리면 박스 자체를 놓칩니다. 반대로 밀도 추정(점 찍기) 방식은 군중에는 강하지만, 큰 사물 몇 개만 있는 사진에서는 오버샷이 자주 납니다.
도메인이 바뀌면 또 다른 문제입니다. 길거리 사진을 잘 세는 모델이 위성 사진을 만나면 무너지고, 위성에 강한 모델이 병리 슬라이드를 만나면 다시 무너집니다. 분야마다 전문 모델이 따로 있는 이유죠.
Count Anything이 푸는 방식
연구진은 두 가지 카운터를 하나의 SAM3 위에 같이 얹었습니다. 여기서 핵심은 “베이스 모델을 다시 학습시키지 않았다"는 점입니다. 무거운 백본은 그대로 두고, 카운터 어댑터만 학습하는 식이죠. 덕분에 SAM3가 이미 갖고 있는 세계지식(언어-이미지 정렬)을 그대로 쓰면서, 카운팅 능력만 따로 끼워 넣는 효과가 납니다.
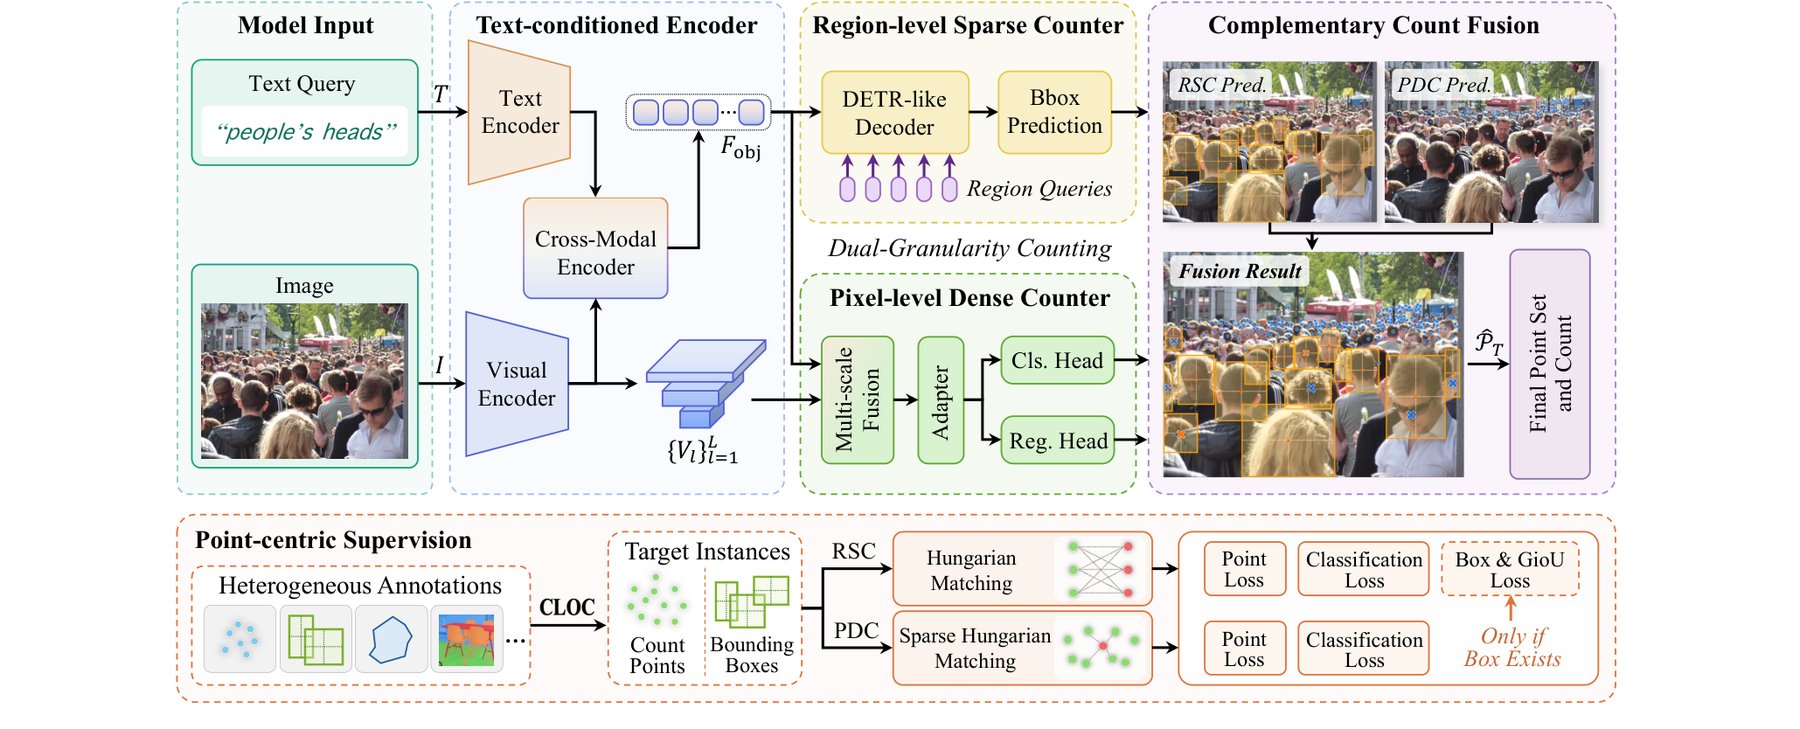
추론 흐름은 이렇습니다.
- 사용자가 “사람”, “양”, “적혈구"처럼 텍스트로 셀 대상을 지정합니다.
- **영역 카운터(sparse)**가 큰 객체를 박스로 잡습니다.
- **픽셀 카운터(dense)**가 작은 객체들을 점으로 잡습니다.
- 중복 제거 단계에서 같은 객체가 두 카운터에 모두 잡힌 경우를 한 번으로 합칩니다.
설명만 보면 단순한 합성처럼 들리는데, 실제로는 “어떤 객체는 박스로, 어떤 객체는 점으로 보낼지"를 텍스트와 시각 단서로 결정하는 라우팅이 제일 어렵습니다. 어댑터의 일이 그쪽이죠.
CLOC — 도메인을 섞어 학습한 데이터셋
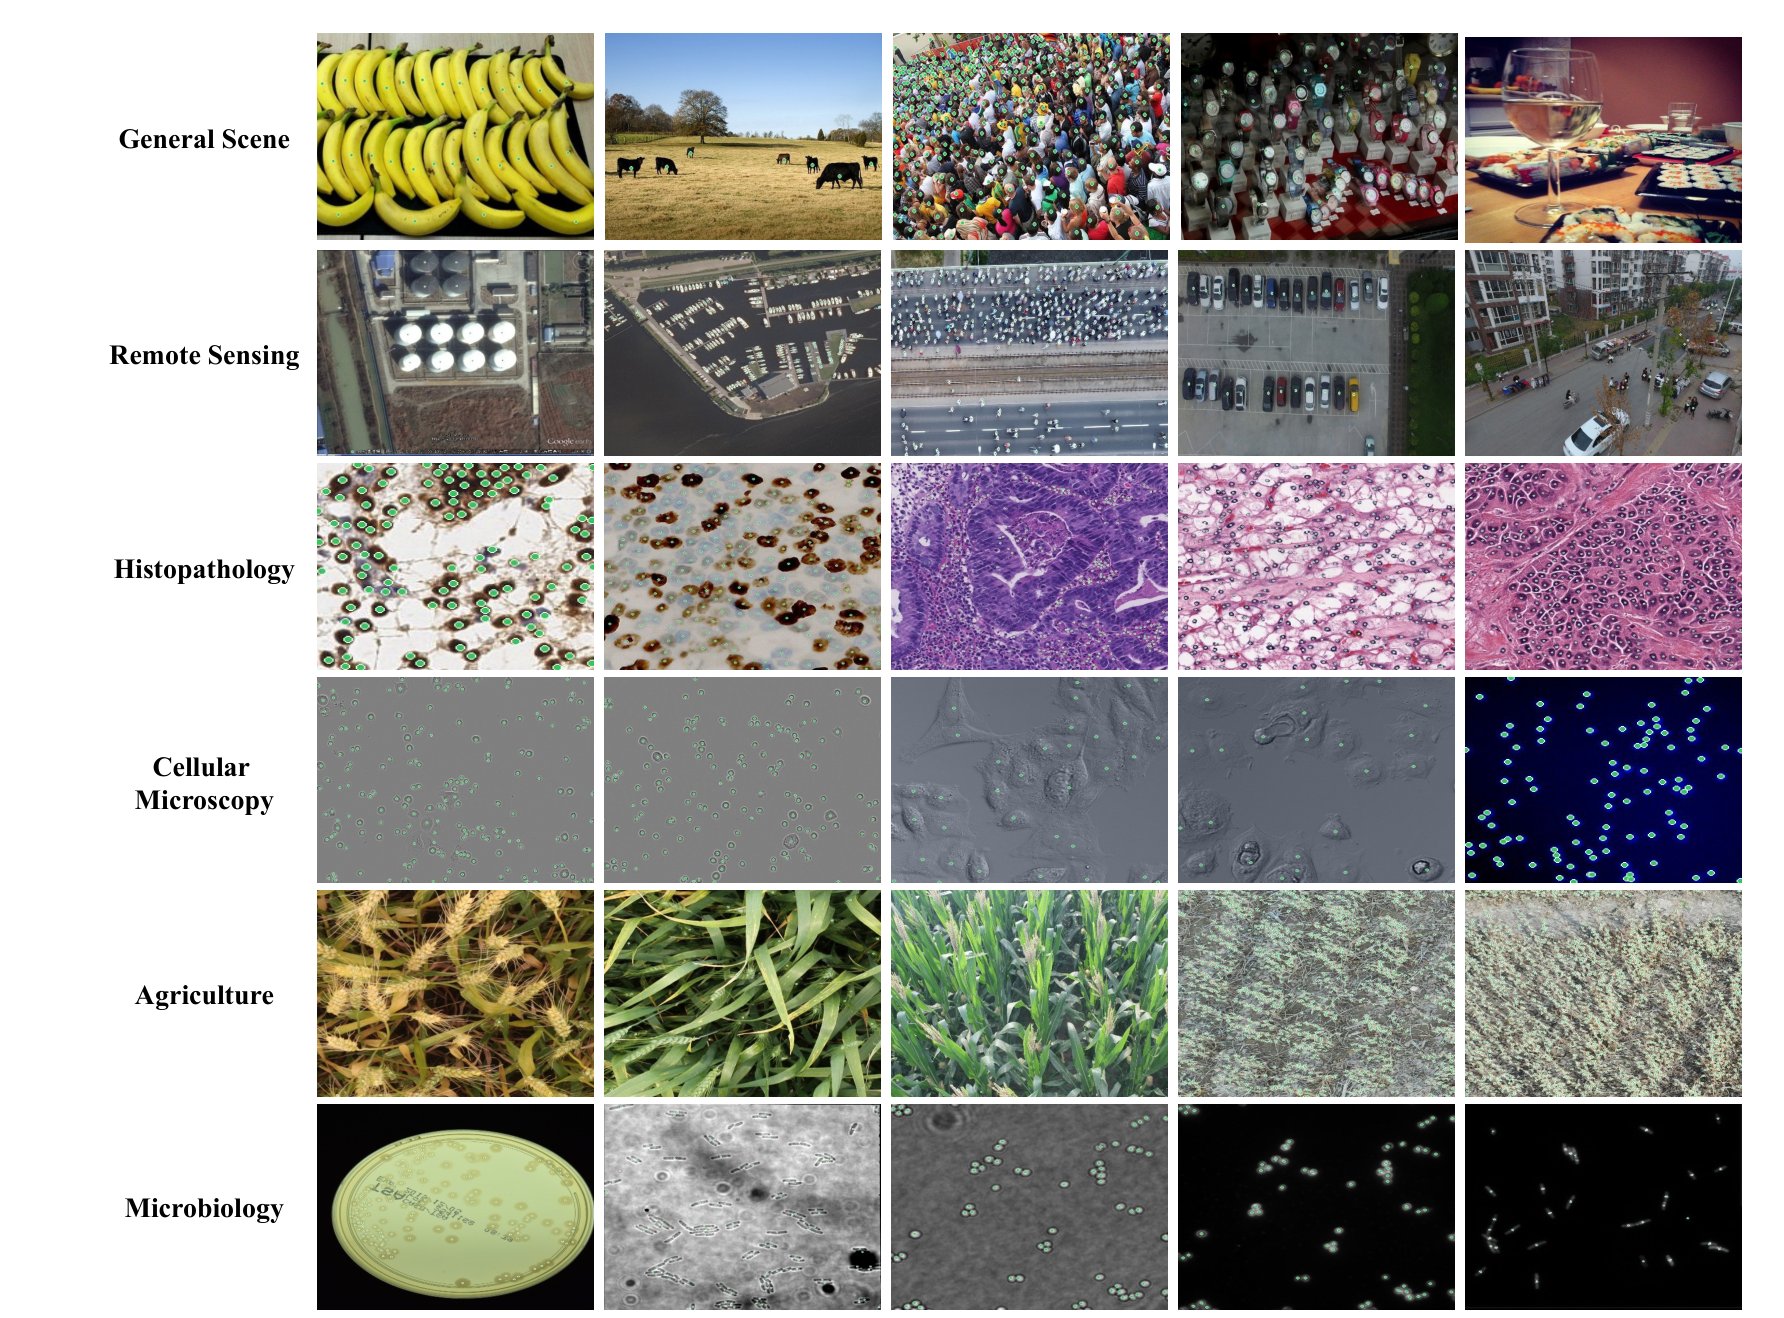
CLOC은 전부 라벨 형식을 통일했습니다. 큰 객체는 박스 좌표, 작은 객체는 점 좌표로 표기해 두 카운터가 같은 데이터를 다른 방식으로 배울 수 있게 했습니다. 619개 카테고리 안에는 사람·차량 같은 일상적인 것부터 세균 군락, 곡식 낟알, 위성에서 본 항공기까지 들어갑니다. “한 모델, 모든 도메인"을 목표로 한 셈입니다.
결과 — 평균 9개, 비교군은 18개 이상
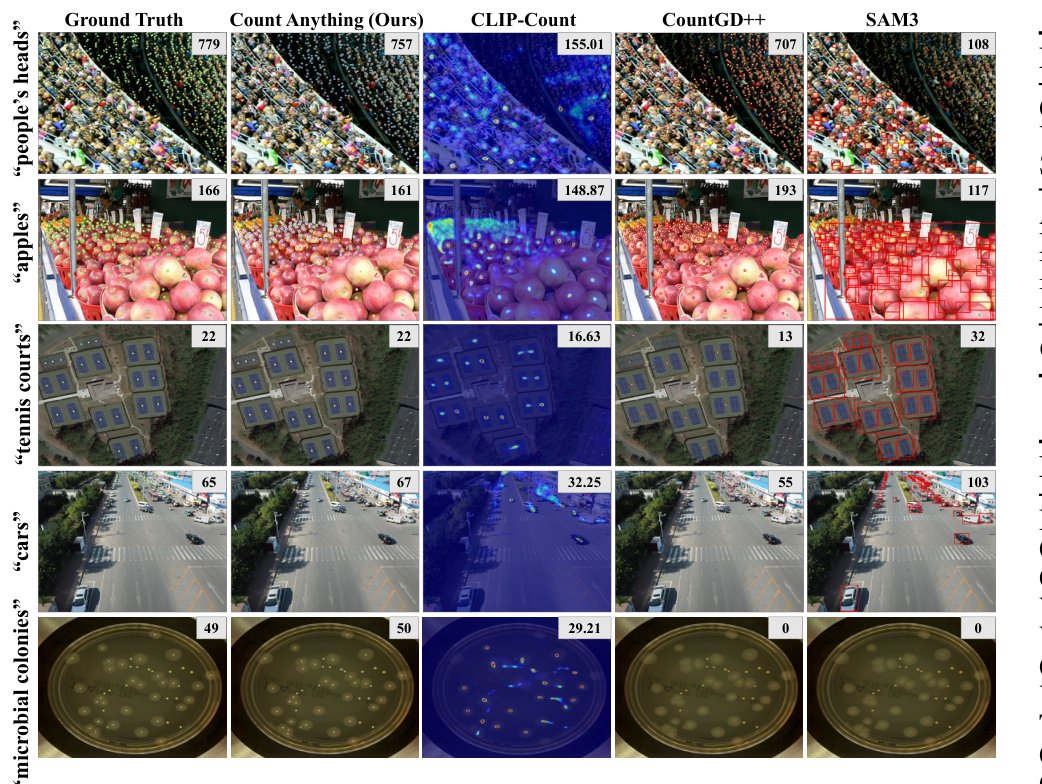
연구진이 보고한 수치를 그대로 옮기면 이렇습니다.
- Count Anything: 카테고리당 평균 약 9개 오차.
- CountGD, CLIP-Count, Grounding DINO 같은 기존 텍스트 프롬프트 카운팅 모델: 18개 이상.
- 군중 카운팅 전용 모델(예: 사람만 세도록 특화한 시스템)과는 비슷한 수준. 추월은 못 했지만, 같은 모델로 의료·농업·위성까지 같이 한다는 점에서 의미가 있습니다.
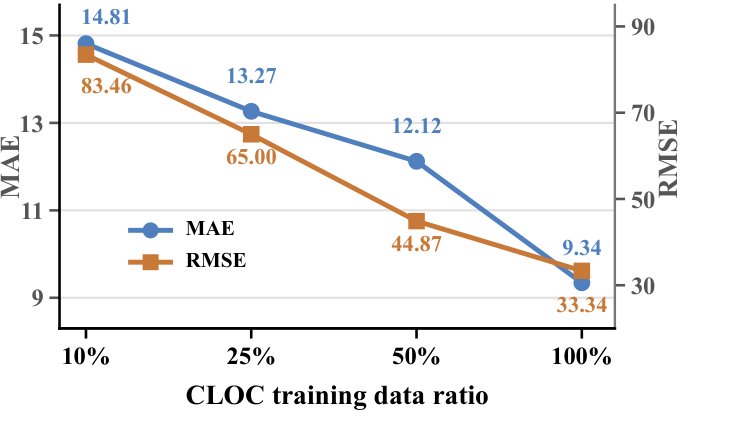
흥미로운 건 스케일링 곡선입니다. 학습 이미지를 늘릴수록 MAE·RMSE가 거의 일정한 기울기로 떨어집니다. 한계가 보이지 않는다는 뜻인데, 데이터를 더 넣으면 군중 전문 모델도 잡을 여지가 남아 있다고 연구진은 해석했습니다.
한계는 솔직히 적혀 있다
논문은 한계도 분명히 짚었습니다.
- 모호한 단어에 약합니다. “작은 사람”, “어른 같아 보이는 아이” 같은 주관적 표현은 잘 못 가립니다.
- 극단적으로 빽빽한 장면에서는 두 카운터가 다 흔들립니다. 가림(occlusion)이 심해지면 사람도 헷갈리는 영역이긴 합니다.
- 군중 카운팅 전용 시스템을 압도하지는 못합니다. 범용성을 얻은 대가로 특화 영역의 정점은 양보한 셈입니다.
여기서 곁다리로 흥미로운 비교 하나. 최근 BabyVision 벤치마크에서는 정상급 모델조차 평균적인 세 살짜리보다 못한 성적이 나왔습니다. 가려진 3D 블록 세기에서 최고 모델 정확도가 **20.5%**에 그쳤죠. “세는 일"이 단순해 보이는 만큼, 그 단순함이 곧 난이도라는 점을 짚어주는 결과입니다.
실무자가 볼 핵심 포인트
- 백본 재학습 없이 어댑터만: 거대한 사전학습 모델 위에 좁고 잘 정의된 능력(카운팅)을 얹는 방식이 또 한 번 통했습니다. 다른 시각 능력에도 같은 패턴이 통할 가능성이 큽니다.
- 두 카운터 + 중복 제거: 한 가지 방식으로 모든 사진을 풀려고 욕심내지 말고, 케이스를 갈라 각자 잘하는 모듈에 맡기는 설계가 카운팅에서는 정답에 가깝습니다.
- 데이터셋 통일이 절반: CLOC이 가능했던 이유는 도메인별 라벨 규약을 박스/점 두 형식으로 강제 통일했기 때문입니다. 데이터 쪽 일이 알고리즘 쪽 일을 끌고 갑니다.
- 스케일링이 살아 있다: 카운팅 영역은 아직 데이터를 더 부으면 더 좋아질 여지가 큽니다. 의료 영상·산업 검사처럼 라벨이 비싸지만 규모가 중요한 분야에 적용해 볼 만한 신호입니다.
- 한계 인정의 가치: 모호한 자연어와 초고밀도 장면이 약점이라는 걸 명시한 건 좋은 신호입니다. 도입을 고민할 때 어디서 보조 룰이나 사람의 확인이 필요한지 미리 알 수 있습니다.
원문 출처
- 원문: New AI model called “Count Anything” does exactly what it says, and that’s harder than it sounds — The Decoder, Jonathan Kemper, 2026-06-13
- 논문: arXiv 2605.30846
- 코드: 연구진 GitHub 저장소(원문 링크 참조)