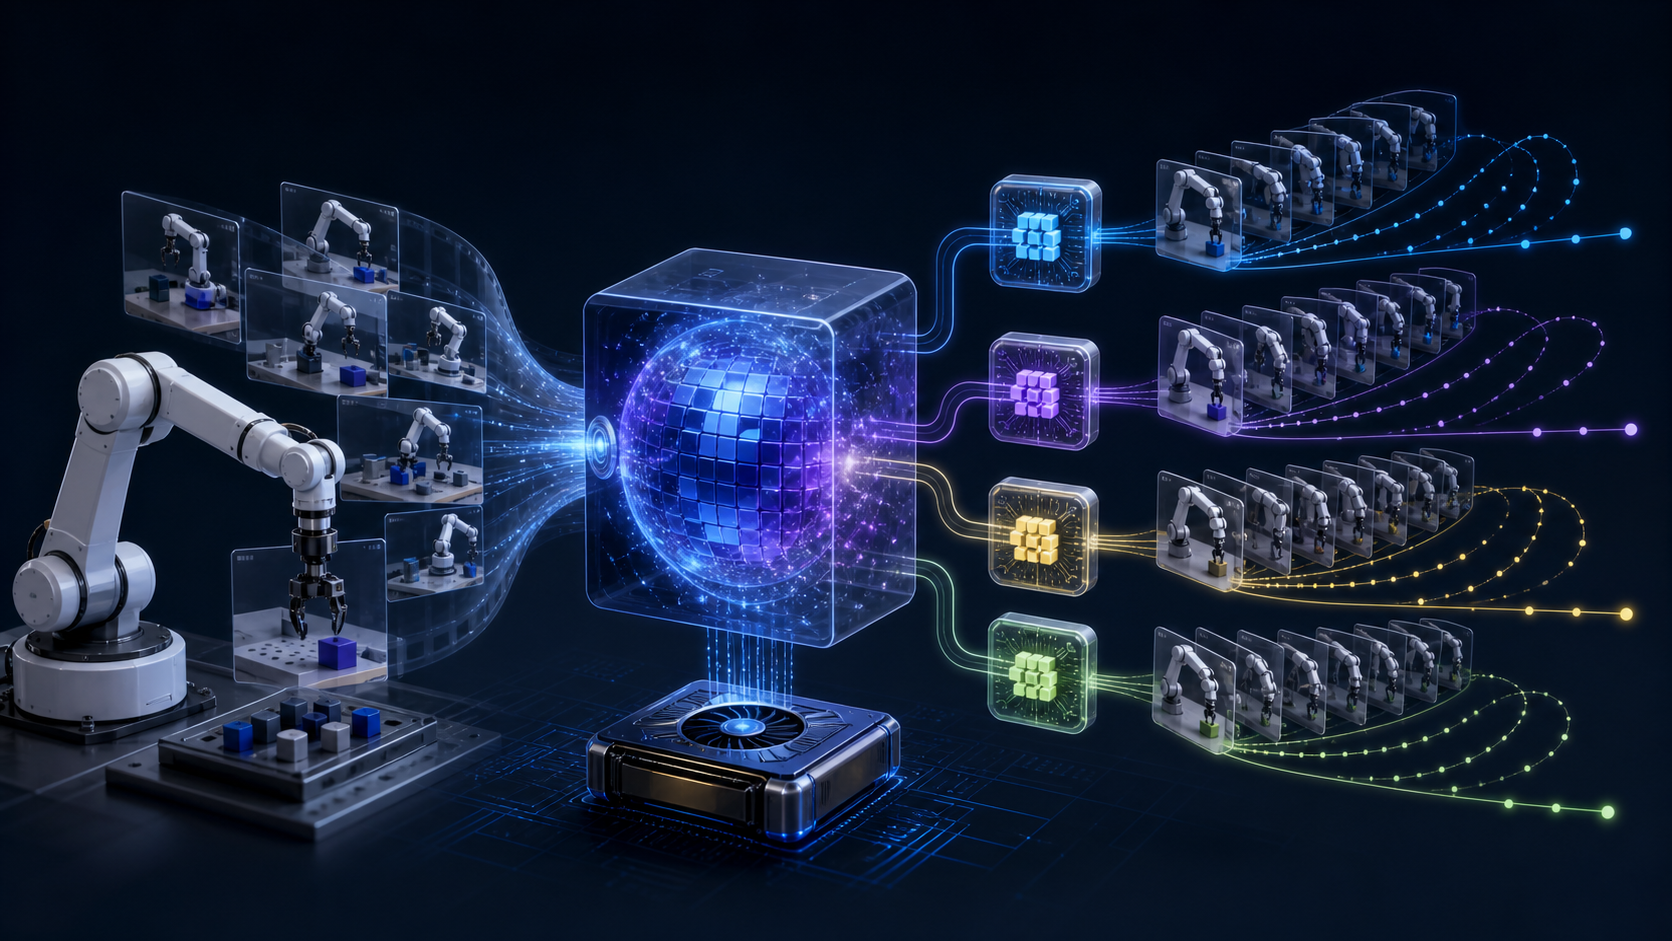
NVIDIA가 Hugging Face에 공개한 글은 Cosmos Predict 2.5를 로봇 조작 영상에 맞게 파인튜닝하는 방법을 다룬다. 핵심은 거대한 비디오 월드 모델 전체를 다시 학습하는 것이 아니라, LoRA와 DoRA 어댑터만 학습해 적은 데이터로 로봇 합성 영상을 만드는 것이다.
목차
핵심 요약
- Cosmos Predict 2.5는 텍스트, 이미지, 비디오를 조건으로 물리적으로 그럴듯한 영상을 생성하는 비디오 월드 모델이다.
- 원문은 92개 로봇 조작 영상만으로 LoRA/DoRA 파인튜닝을 수행하고, 테스트 프롬프트에 맞는 합성 로봇 영상을 생성하는 흐름을 제시한다.
- 전체 2B 모델을 다시 학습하지 않고 DiT 일부 모듈에 어댑터를 붙여 단일 80GB GPU에서도 학습 가능하게 만든다.
- 파인튜닝 후 Sampson Error, 물리적 타당성, 지시 준수 점수가 모두 개선됐다.
왜 로봇 학습에 비디오 월드 모델이 필요한가
로봇 정책을 학습시키려면 실제 시연 데이터가 필요하다. 문제는 이 데이터가 비싸다는 점이다. 로봇 팔을 움직이고, 카메라를 세팅하고, 실패한 궤적을 걸러내는 과정은 텍스트 데이터를 모으는 것과 비교할 수 없을 만큼 느리다.
그래서 원문은 파인튜닝된 비디오 월드 모델로 합성 궤적을 만드는 방법을 제안한다. 실제 로봇 영상을 몇 개 확보한 뒤, 그 도메인에 맞게 Cosmos Predict 2.5를 조정하면 더 많은 로봇 행동 영상을 만들 수 있다. 로봇 학습 입장에서는 실제 수집 데이터만 바라보는 대신, 월드 모델을 데이터 증강 엔진처럼 쓰는 셈이다.
LoRA와 DoRA가 줄이는 비용
Cosmos Predict 2.5는 2B 파라미터 모델이다. 전체 파인튜닝을 하면 GPU 메모리와 시간이 크게 들고, 원래 모델이 가진 일반 지식이 망가지는 파국적 망각 위험도 있다. LoRA와 DoRA는 이 문제를 줄인다.
원문 방식은 VAE, 텍스트 인코더, DiT 기본 가중치를 동결하고, DiT의 attention projection과 feed-forward 계층에 작은 어댑터를 주입한다. rank 32 기준 학습 가능한 파라미터는 약 5천만 개 수준이다. 전체 모델을 바꾸는 대신 “로봇 조작 도메인에 필요한 방향”만 덧붙이는 구조다.
DoRA는 LoRA 업데이트를 적용하기 전에 가중치를 크기와 방향으로 나누는 방식이다. 원문 결과만 보면 LoRA와 DoRA의 차이는 극적으로 크지 않다. 다만 낮은 랭크에서 학습이 흔들리거나 더 안정적인 업데이트가 필요할 때 DoRA를 검토할 만하다.
결과에서 봐야 할 지점
원문 실험은 92개 학습 영상과 50개 테스트 쌍을 사용했다. 테스트에서는 첫 프레임 이미지와 텍스트 지시를 넣고, 모델이 이후 로봇 조작 영상을 생성한다. 파인튜닝 전 모델은 로봇 손 대신 사람 손을 환각하거나, 올바른 손을 쓰지 못하거나, 영상이 흔들리는 문제가 있었다.
LoRA와 DoRA 파인튜닝 뒤에는 세 가지 지표가 좋아졌다. Sampson Error는 낮아져 시간적 안정성과 다중 시점 기하 일관성이 개선됐고, Cosmos Reason2 기반 평가에서는 물리적 타당성과 지시 준수 점수가 올라갔다. 특히 rank 32는 어떤 손을 쓰고 어떤 물체를 옮겨야 하는지 같은 지시 준수에서 유리했다.
흥미로운 해석은 rank가 커져도 모든 지표가 같이 좋아지지는 않았다는 점이다. 기하 일관성과 물리 상식은 이미 동결된 월드 모델 안에 상당 부분 들어 있고, LoRA 어댑터는 로봇 외형과 작업 분포를 맞추는 역할에 가깝다. 그래서 목적이 단순 도메인 적응이면 낮은 rank도 출발점이 될 수 있다.
실무자가 볼 핵심 포인트
이 글의 실무적 의미는 “로봇 데이터가 부족하면 무조건 더 찍어야 한다”에서 한 발 벗어난다는 데 있다. 적은 시연 데이터로 월드 모델을 도메인에 맞추고, 합성 영상을 만들어 정책 학습 후보 데이터를 늘리는 흐름이 점점 현실적인 선택지가 되고 있다.
다만 바로 운영에 넣기에는 확인할 것이 많다. 원문 실험은 집기·놓기 중심의 짧은 로봇 조작 영상에 집중되어 있다. 조립, 이동, 장시간 작업처럼 복잡한 태스크에서도 같은 효과가 나는지는 별도 검증이 필요하다. 또한 합성 영상의 점수가 좋아져도 실제 로봇 정책 성능으로 얼마나 전이되는지는 따로 봐야 한다.
실무에서 먼저 볼 지표는 생성 영상의 보기 좋은 정도가 아니라, 실제 정책 학습에 넣었을 때 실패율이 줄어드는지다. 합성 데이터는 보조 엔진이지, 검증 없는 대체 데이터가 아니다.
그래도 방향은 분명하다. 로봇 AI에서 앞으로 중요한 자산은 모델 크기만이 아니라, 작은 실제 데이터셋을 월드 모델과 어댑터로 얼마나 잘 확장하느냐가 될 가능성이 크다. LoRA/DoRA는 그 확장 비용을 낮추는 실용적인 도구다.
원문 출처
원문: Fine-Tuning NVIDIA Cosmos Predict 2.5 with LoRA/DoRA for Robot Video Generation