계약서 마지막 검토에서 빠진 용어, 잘못된 참조, 앞뒤가 안 맞는 문장을 AI가 얼마나 잘 찾는지 재는 새 시험지를 만들었다.
무엇이 문제였나 — 계약서 최종 검토는 중요하지만, AI가 이 일을 얼마나 잘하는지 직접 재는 시험지가 거의 없었다. 어떻게 풀었나 — 경력 많은 변호사들이 44개 계약서를 읽고 9가지 오류 유형에 대해 정답을 만들었다. 그래서 뭐가 좋아졌나 — 가장 잘한 AI도 전체 오류 유형을 평균하면 75% 정도만 찾아, 사람 검토 없이 바로 맡기기엔 부족했다.
집을 사기 전 마지막 하자 점검을 한다고 생각하면 된다. 이 논문은 AI가 그런 점검표를 들고 작은 하자까지 얼마나 잘 찾는지 시험했고, 결과는 ‘도움은 되지만 혼자 맡기기엔 부족하다’에 가깝다.
논문 정보
Yejin Bang, Kirsty Fielding, Brandan Oliver, Brian Birke et al. · Thomson Reuters Foundational Research; Imperial College London · arXiv preprint · 2025
왜 중요한가
계약서의 작은 실수도 분쟁이나 지연으로 이어질 수 있다. 이 벤치마크는 AI가 어떤 실수는 잘 찾고 어떤 실수는 자주 놓치는지 보여줘, 법무팀이 AI를 보조 도구로 어디까지 믿을 수 있는지 판단하게 해준다.
핵심 지표
| 지표 | 값 | 설명 |
|---|---|---|
| 최고 모델 Macro-Recall | 0.750 | GPT-5.5 기준, 9개 범주 recall 단순 평균 |
| 최고 F1 점수 | 0.655 | Gemini 3.1 Pro 기준 Table 2 전체 F1 |
| 계약 1건당 비용 (최고 Recall 모델) | 1.38USD | GPT-5.5 평균 비용, 평균 시간 533초; Qwen 3.5 397B는 $0.04 |
| 추론 활성화 시 Recall 증가 | +0.107 | GPT-5.5 without reasoning 0.643에서 with reasoning 0.750으로 증가 |
어떻게 동작하나
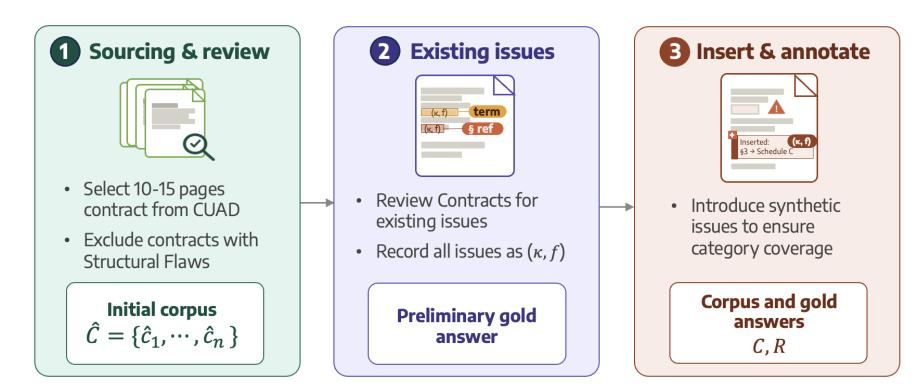
ContractScrub는 44개의 CUAD 출처 영어 계약서(대략 10-15페이지)를 대상으로 만든다. 9명의 변호사가 참여했고 모두 8년 이상, 이 중 8명은 10년 이상, 6명은 15년 이상 경력을 보유했다. 데이터는 3단계로 구성된다: 출처 계약 선별과 구조적 결함 검토, 기존 오류와 정의된 용어 주석, 현실적인 추가 오류 삽입. 최종 데이터는 9개 범주 총 3,014개 주석으로 이루어지며, 범주별 수는 Defined Terms 1,505개, Undefined Capitalized Terms 689개, Uncapitalized Defined Terms 317개, Unused Defined Terms 202개, Incorrect Section/Article/Paragraph References 150개, Incorrect Party References 130개, Incorrectly Capitalized Terms in Context 129개, Terms Defined Multiple Times 97개, Inconsistent Language 87개다. 각 오류는 범주와 category-specific field vector를 가진 튜플 multiset으로 저장된다. 모델은 범주별로 분리된 프롬프트를 받아 JSON 구조화 출력을 만들고, 평가는 gold/predicted tuple multiset의 결정론적 매칭으로 수행한다. 위치 표기는 소문자화, 공백 제거, 1(a)(i)→1ai 및 1.1(h)(vii)→1.1hvii 같은 정규화를 거치며, paired-location 범주는 순서와 무관하게 매칭한다. 주 지표는 false negative 비용이 큰 업무 특성을 반영한 recall이고, precision과 F1 및 location을 제거한 word-only scoring ablation도 함께 보고한다.
 ContractScrub 구축 파이프라인 3단계: 출처 계약서 선별, 기존 오류 주석, 추가 오류 삽입
경험 많은 변호사들이 CUAD 출처 계약서를 선별하고, 기존 오류와 새로 삽입한 현실적 오류를 모두 gold answer로 기록했음을 보여준다.
핵심 수식:
\hat{R}_i = \mathcal{M}(I, c_i), \quad \text{Macro-R} = \frac{1}{|\mathcal{K}|} \sum_{k \in \mathcal{K}} R_k
계약서 c_i와 지시문 I를 받은 모델 M은 예측 주석 multiset \hat{R}_i를 생성한다. 각 gold/predicted 주석은 category label \kappa와 category-specific field vector f로 구성된 튜플이다. R_k는 범주 k의 recall, 즉 TP_k/(TP_k+FN_k)이고, Macro-R은 9개 범주 recall의 단순 평균이다.
실험 결과
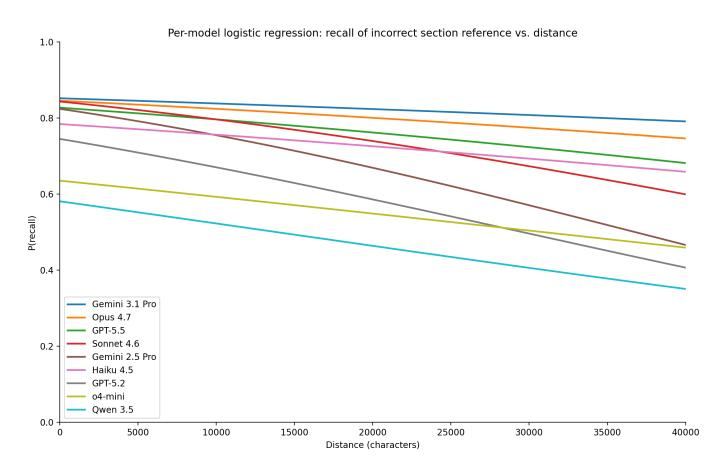 잘못된 섹션 참조 거리(문자 수)에 따른 recall 감소 추세
참조 위치와 실제로 가리켜야 할 위치가 멀어질수록 recall이 낮아지며, 10,000자(대략 5-6페이지)를 넘으면 감소가 더 뚜렷해진다.
한계와 주의할 점
- 출처 계약이 44개에 불과해 특정 계약의 작성 스타일이나 특이성이 결과에 영향을 줄 수 있다.
- 영어권 10-15페이지 계약만 다루어 다른 법적 전통, 언어, 짧은 term sheet, 수백 페이지 금융계약에는 일반화가 제한된다.
- JSON 구조화 출력을 강제해 순수한 오류 탐지 능력과 instruction-following 능력이 섞여 평가될 수 있다.
- Recall을 주 지표로 삼는 것은 실무상 타당하지만, 배포 단계에서는 false positive 검토 비용도 별도로 관리해야 한다.
- 장거리 참조: 잘못된 섹션 참조에서 두 위치 사이 거리가 길수록 recall이 감소하고, 10,000자 이후 감소가 더 두드러진다.
- 문맥 의존 판단: Incorrect Party References, Incorrect Capitalization in Context, Undefined Capitalized Terms처럼 문서 내부 의도를 추론해야 하는 범주에서 평균 recall이 낮다.
- 명시적 어휘 단서와 추론의 차이: Defined Terms, Unused Defined Terms처럼 표면 단서가 강한 범주는 상대적으로 높지만, 내부 규칙을 유지해야 하는 범주는 어렵다.
- 모델 규모 비의존: Qwen 3.5 397B는 recall 0.438로 o4-mini 0.409, Claude Haiku 4.5 0.445와 비슷해 파라미터 수만으로 성능이 설명되지 않는다.
- 위치 식별 오류: word-only scoring에서는 점수가 올라가며, 특히 Qwen 3.5는 위치를 정확히 짚는 데 더 큰 어려움이 있음을 시사한다.
시스템 적용 아이디어
논문의 기법을 비슷한 구조를 가진 시스템에 옮길 때의 적용 지점이다.
장문서 내 정의-사용 매핑 인덱스를 명시 자료구조로 유지
논문 Section 5는 모델이 문서 전체의 defined terms에 대한 implicit index를 안정적으로 유지해야 한다고 설명한다. 같은 패턴을 RAG나 문서 QA 에이전트에 적용해, 정의 절을 별도 named-anchor 메모리에 적재하고 각 청크에서 등장한 대문자 용어가 정의 메모리에 있는지 자동 검증한다.
적용 지점 — 장문서 RAG의 용어 정합성 메타-검증 단계
기대 효과 — 정량 수치 없음, 논문 Section 5의 task difficulty 분석 기반 정성적 개선
복합 문서 검토 작업을 단일-범주 서브태스크로 분해
논문 Section 3.5는 모델이 각 category issue를 separate instances에서 식별하도록 프롬프트했다고 명시한다. 같은 분해 패턴을 코드 리뷰, 규정 준수 검사, 보험 약관 검토 같은 다중 범주 검토 에이전트에 적용할 수 있다.
적용 지점 — 에이전트의 다중-범주 문서 검토 디스패처
기대 효과 — 정량 수치 없음, 본 논문이 채택한 구현 결정으로 인용
구조화 튜플 출력 스키마와 위치 정규화 규칙을 평가 단계에 동시 적용
논문 Section 3.5는 term lower-casing, 1(a)(i)→1ai, 1.1(h)(vii)→1.1hvii, special label canonicalization, paired-location order-independent matching을 정의한다. 같은 규칙을 구조화 추출 평가에 적용하면 표면 형식 차이로 인한 불필요한 감점을 줄일 수 있다.
적용 지점 — 구조화 추출 에이전트의 출력 정규화 단계
기대 효과 — 정량 수치 없음, 본 논문의 평가 안정화 장치로 인용
장거리 참조를 위한 정의-참조 그래프 명시 구축
논문 Figure 3b는 잘못된 섹션 참조에서 두 대상 사이의 문자 거리가 길어질수록 recall이 낮아지는 경향을 보인다. 이를 보완하기 위해 정의, 사용, 참조 관계를 그래프로 추출하고, ‘정의되지 않은 대문자 용어’, ‘동일 용어 다중 정의’, ‘잘못된 섹션 참조’를 후처리 쿼리로 검사한다.
적용 지점 — 장문서 인덱싱 단계의 정의-참조 그래프 구축
기대 효과 — 정량 수치 없음, 논문 Figure 3b의 장거리 참조 실패 분석을 정성적으로 완화
단계별 도입 로드맵
| 단계 | 목표 | 액션 | 기대 효과 |
|---|---|---|---|
| Phase 1 (파일럿) | 카테고리별 분리 프롬프팅 + JSON 스키마 기반 1차 스크러버 구축 | 본 벤치마크의 9개 범주 스키마를 대상 계약 유형에 맞게 적용하고, 범주별 독립 호출과 결정론적 튜플 매칭 평가기를 구현한다. | 반복적인 오류 후보를 빠르게 모아 변호사가 우선 검토할 목록을 만들 수 있다. |
| Phase 2 (검증·개선) | Human-in-the-loop 신뢰도 검증 + 위치 정확도 개선 | 변호사 샘플 검증으로 precision/recall을 측정하고, location 정규화·인용 위치 검증·word-only ablation을 함께 기록해 모델이 항목을 놓친 것인지 위치를 틀린 것인지 분리한다. | 실무 검토 부담과 누락 위험을 범주별로 파악하고, 낮은 성능 범주에 별도 가드레일을 붙일 수 있다. |
| Phase 3 (확장) | 계약 생명주기 전 단계로 자동 스크러빙 확장 + 모델 라우팅 | 협상 중간본에도 주기적 스크러빙을 적용하고, 정의-사용 매핑 인덱스나 참조 그래프를 붙여 long-distance reference와 defined-term consistency를 보강한다. 비용·지연시간·recall 기준으로 모델을 라우팅한다. | 마감 직전 발견되는 단순 오류를 줄이고, 고위험 계약 검토에 사람의 시간을 더 집중시킬 수 있다. |
원문 PDF: 2026-08-23-contractscrub-a-benchmark-for-final-review-of-legal-contracts.pdf