정리된 코드는 AI가 테스트를 더 잘 만들게 하고, 입력 토큰도 덜 쓰게 만든다.
무엇이 문제였나 — 문제: AI 코딩 도구가 좋은 코드에서 더 잘 작동한다는 말은 많았지만, 테스트 생성 품질과 토큰 비용으로 확인한 증거는 부족했다. 어떻게 풀었나 — 해결: Python, Java, C++ 코드 24,620개를 코드 건강도 구간으로 나누고 같은 LLM으로 테스트를 만들게 한 뒤, 테스트가 얼마나 잘 작동하는지와 입력 토큰 수를 비교했다. 그래서 뭐가 좋아졌나 — 결과: 건강도가 높을수록 테스트가 버그를 잡아내는 힘이 조금씩 좋아졌고, 특히 Java와 C++의 낮은 건강도 코드는 같은 작업에 더 많은 입력 토큰을 쓰는 경향이 있었다.
잘 정리된 책상에서는 필요한 자료를 빨리 찾을 수 있다. 코드도 마찬가지로 구조가 좋으면 AI가 이해할 단서가 분명해져 테스트를 만들기 쉽고, 읽어야 할 토큰도 줄어든다.
논문 정보
Freya Wirdemann, Markus Borg, Nadim Hagatulah, Adam Tornhill · Heidelberg University; CodeScene and Lund University; Lund University; CodeScene · arXiv preprint (cs.SE, arXiv:2608.18645v1) · 2026
왜 중요한가
LLM은 토큰 단위로 비용과 속도가 결정된다. 이 논문은 지저분한 코드가 유지보수만 어렵게 하는 것이 아니라 AI 도구 사용 비용까지 키울 수 있음을 보여준다.
핵심 지표
| 지표 | 값 | 설명 |
|---|---|---|
| Java Mutation Score (CH 9.8-10) | 95.1% | 가장 높은 CH 구간에서 Java LLM 생성 테스트의 중앙 mutation score |
| CH-Mutation 상관 (C++) | +0.34ρ | Table II에서 보고된 C++의 CH와 mutation score 사이 Spearman 상관 |
| 저CH Java 입력 토큰 페널티 | +45.1% | Table I 기준 Java CH<6 중앙 입력 토큰(1,492.0)이 CH 9.8-10(1,028.0)보다 높은 비율 |
| 전체 분석 파일 수 | 24,620files | Python 5,000 + Java 9,795 + C++ 9,825 CodeContests 파일 |
어떻게 동작하나
연구진은 CodeContests에서 기존 Python 5,000개 파일을 사용하고, Java 9,795개와 C++ 9,825개를 추가해 총 24,620개 파일을 구성했다. Java와 C++는 CH 9 이상과 9 미만을 각각 2,500개씩 뽑은 뒤 낮은 CH 파일을 더해 약 10,000개 수준으로 맞췄고, CodeBLEU로 유사한 코드를 걸러 구문 다양성을 확보했다. 분석 구간은 CH<6, 6-7, 7-8, 8-9, 9-9.5, 9.5-9.8, 9.8-10의 7개다. Qwen3-Coder-30B-A3B-Instruct(temp=0.1, max tokens=4,096)를 NVIDIA A100 80GB와 vLLM으로 실행해 Python은 pytest, Java는 JUnit 5, C++는 CppUnit 테스트를 단발 생성했다. 출력에는 markdown fence와 설명문 제거 같은 deterministic post-processing만 적용했고 추가 repair는 하지 않았다. line/branch coverage는 coverage.py, JaCoCo, gcov/lcov로 측정했으며 mutation score는 mutmut, PIT, Mull로 계산했다. mutation testing은 baseline test가 컴파일·실행·통과한 경우에만 수행했다. 입력 토큰은 Qwen, OpenAI o200k_base, Claude Sonnet 4.6, Gemini 3.1 Pro Preview 토크나이저로 세었고, CH와 효과·토큰 수의 관계는 Spearman 상관 및 SLOC·글자 수 통제 편상관으로 분석했다.
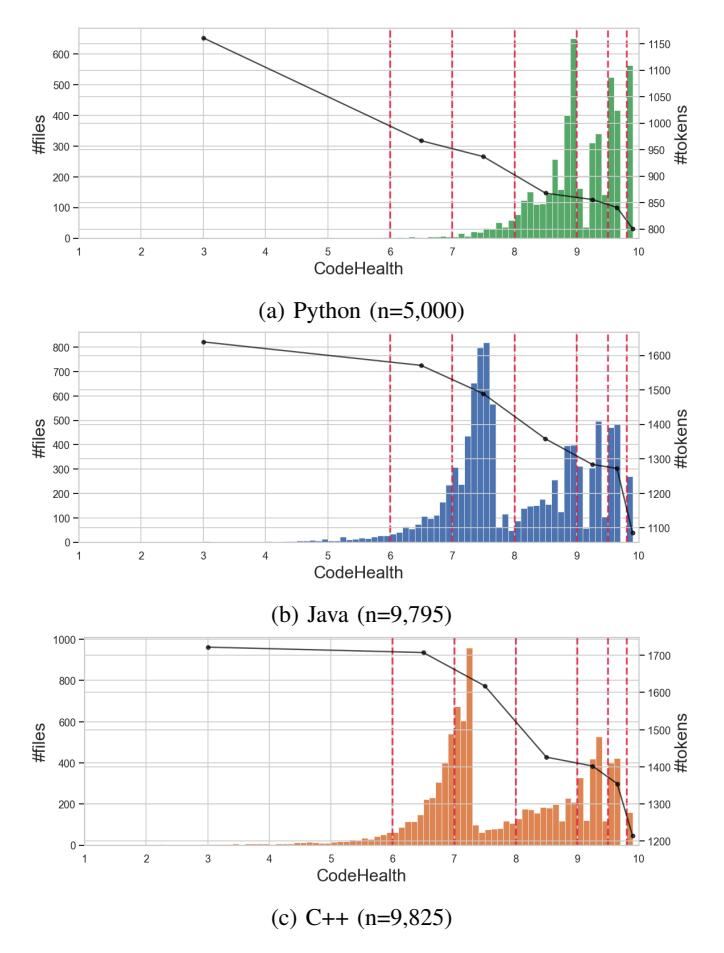
 Python, Java, C++ 데이터셋의 CodeHealth 점수 분포. 점선은 CH 구간 경계이고, 검은 선은 Claude Sonnet 4.6 토크나이저 기준 구간별 중앙 입력 토큰 수를 나타낸다.
세 언어 모두 CH 상위 구간에 파일이 많이 몰려 있지만, Java와 C++는 낮은 CH 파일을 더 많이 포함하도록 샘플링되어 낮은 구간 분석이 가능하다. 낮은 CH 구간일수록 중앙 입력 토큰 수가 대체로 높다.
핵심 수식:
Mutation\ Score = \frac{\#\ killed\ mutants}{\#\ generated\ mutants} \times 100\%
논문 본문은 mutation score를 ‘killed mutants / all generated mutants’의 비율로 정의한다. Spearman ρ는 Table II와 III의 상관 분석에 쓰였지만, 논문에 별도 수식으로 제시되지는 않았다. ρS는 SLOC를 통제한 편상관, ρC는 character count를 통제한 편상관이다.
실험 결과
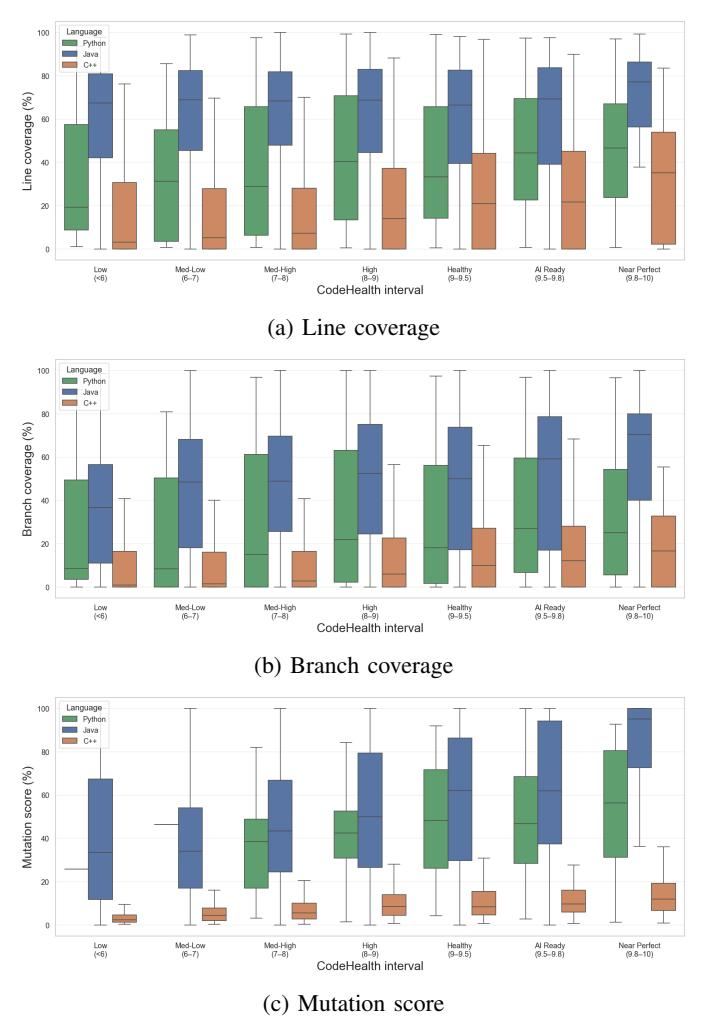 7개 CH 구간별 LLM 생성 단위 테스트의 line coverage, branch coverage, mutation score 분포를 보여주는 결과 그림.
coverage와 mutation score 모두 높은 CH 구간에서 중앙값이 높아지는 경향이 있지만 분포가 많이 겹친다. 가장 뚜렷한 관계는 mutation score에서 나타나며, C++의 CH-mutation 상관이 ρ=+0.34로 가장 크다.
한계와 주의할 점
- 외적 타당도 한계: 대상 코드는 모두 standalone competitive programming 풀이이므로 일반 프로덕션 코드와 단위 테스트 환경으로 바로 일반화하기 어렵다.
- 단일 모델 한계: Qwen3-Coder-30B-A3B-Instruct만 사용했기 때문에 더 큰 frontier 모델이나 다른 agentic workflow에서도 같은 패턴이 나오는지는 알 수 없다.
- 상관 강도의 약함: 논문도 CH가 weak but consistent signal이라고 표현하며, 특히 coverage 지표의 상관은 매우 작고 구간별 분포가 많이 겹친다.
- Mutation score 선택 편향 가능성: baseline test가 통과한 파일만 mutation testing에 들어가므로, 실행 성공률 자체가 CH와 관련되어 있다면 관측된 관계가 달라질 수 있다.
- 입력 토큰 중심 분석: 출력 토큰, 반복 호출, 테스트 repair, multi-turn agent workflow의 누적 비용은 범위 밖으로 남았다.
- 저CH Python 데이터 희소성: Python CH<6은 10개, 6-7은 28개뿐이라 낮은 구간의 수치 해석이 불안정하다.
- Python mutation 관측 수 부족: mutation testing 결과가 251개 파일에 한정되어 SLOC 통제 후 mutation 상관이 통계적으로 유의하지 않다.
- 생성 테스트 실패 제외: 컴파일 실패, 실행 실패, timeout인 테스트는 mutation score 계산에서 제외되어 실제 자동화 품질을 과대평가할 수 있다.
- C++의 낮은 절대 성능: CH 9.8-10에서도 C++ mutation score 중앙값은 12.0%라, 해당 모델·프롬프트 설정에서는 C++ 테스트 생성이 여전히 어렵다.
- 토크나이저별 해석 차이: C++는 character count를 통제하면 Claude/Gemini에서 CH-token 관계가 크게 약해져, 토큰 낭비가 주로 코드 길이 때문일 수 있다.
시스템 적용 아이디어
논문의 기법을 비슷한 구조를 가진 시스템에 옮길 때의 적용 지점이다.
CH 점수 기반 LLM 테스트 생성 라우터
에이전트가 테스트를 생성하기 전에 대상 파일의 CH, SLOC, 언어를 확인한다. CH가 높은 파일은 일반 단발 테스트 생성으로 처리하고, CH가 낮은 파일은 작업을 더 작게 나누거나 선행 리팩터링 제안, 더 강한 모델, 더 엄격한 실행 검증으로 라우팅한다. 논문은 CH가 특히 mutation score와 약하지만 일관된 양의 관계를 가진다고 보고한다.
적용 지점 — 에이전트의 테스트 생성 전략 선택 단계
기대 효과 — 저CH 파일에서 실패 테스트와 낮은 mutation score 위험을 조기에 감지하고 대응
PR 입력 토큰 비용 사전 추정기
PR이 열리면 변경 파일의 CH와 SLOC를 계산하고, Java와 C++에서 낮은 CH가 입력 토큰 증가와 연결된다는 논문 결과를 비용 경고 신호로 사용한다. Java의 경우 CH<6 중앙 입력 토큰이 CH 9.8-10보다 45.1% 높았다는 결과를 기준 사례로 제시할 수 있다.
적용 지점 — PR 리뷰 단계의 비용/품질 코멘트 자동화
기대 효과 — 토큰을 많이 쓰는 저CH 변경 파일을 사전에 식별하고 리팩터링 우선순위를 제안
AI 친화도 품질 대시보드
레포지토리별 CH 구간 분포, 입력 토큰, 테스트 생성 성공률, coverage, mutation score를 한 화면에 보여준다. 논문의 핵심 메시지처럼 maintainability를 사람의 생산성 지표뿐 아니라 LLM 활용 효율 지표로도 관리한다.
적용 지점 — 개발 조직의 AI 코딩 도구 운영 대시보드
기대 효과 — AI 도구 비용과 품질 문제를 코드 품질 개선 활동과 연결
단계별 도입 로드맵
| 단계 | 목표 | 액션 | 기대 효과 |
|---|---|---|---|
| Phase 1 (1~2개월) | 베이스라인 측정 및 저CH 영역 파악 | 주요 레포지토리에 CodeScene 또는 동등한 유지보수성 측정 도구를 적용해 모듈별 CH 분포, SLOC, 언어별 토큰 추정치를 수집한다. 논문의 7개 CH 구간(<6, 6-7, 7-8, 8-9, 9-9.5, 9.5-9.8, 9.8-10)을 참고해 내부 대시보드를 만든다. | LLM 도구 적용 전 코드 상태와 비용 위험 영역을 파악한다. |
| Phase 2 (3~4개월) | AI 테스트 생성 워크플로우에 CH 신호 통합 | 에이전트나 CI 파이프라인에서 테스트 생성 전에 CH와 SLOC를 확인한다. CH가 낮은 파일은 더 보수적인 프롬프트, 작은 작업 단위 분할, 선행 리팩터링 권고, 수동 리뷰 강화 같은 전략으로 라우팅한다. | 저품질 코드에서 실패 생성과 불필요한 토큰 사용을 줄이고, LLM 테스트 생성 결과를 더 예측 가능하게 만든다. |
| Phase 3 (6개월~) | 내부 데이터로 임계값 검증 | CH 변화, 입력·출력 토큰, 생성 테스트 성공률, coverage, mutation score를 시계열로 추적한다. 논문 결과와 내부 프로덕션 코드 결과를 비교해 CH 9.0, 9.5, 9.8 같은 임계값이 실제로 의미 있는지 재조정한다. | AI-friendly code 기준을 조직의 코드베이스와 모델 사용 패턴에 맞게 보정한다. |
원문 PDF: 2026-08-21-code-health-in-llm-based-test-generation-effectiveness-and-token-efficie.pdf