개요
OpenAI가 ChatGPT의 의료 응답 품질을 한 단계 끌어올렸습니다. 이번 주인공은 GPT-5.5 Instant입니다. 이름에 ‘Instant’가 붙은 만큼 응답 속도와 비용은 가벼운 쪽인데, 정작 성능은 가장 비싼 Thinking 계열 모델과 어깨를 나란히 합니다. 그것도 OpenAI 자체 의료 벤치마크인 HealthBench와 HealthBench Professional 둘 다에서 그렇습니다. 무엇보다 이번 발표의 핵심은 단순한 모델 교체가 아니라 의사가 직접 쓴 답변까지 따라잡았다는 점입니다.
핵심 요약
- 모델: GPT-5.5 Instant. 가벼운 ‘Instant’ 계열인데 Thinking 계열 성능을 따라잡았습니다.
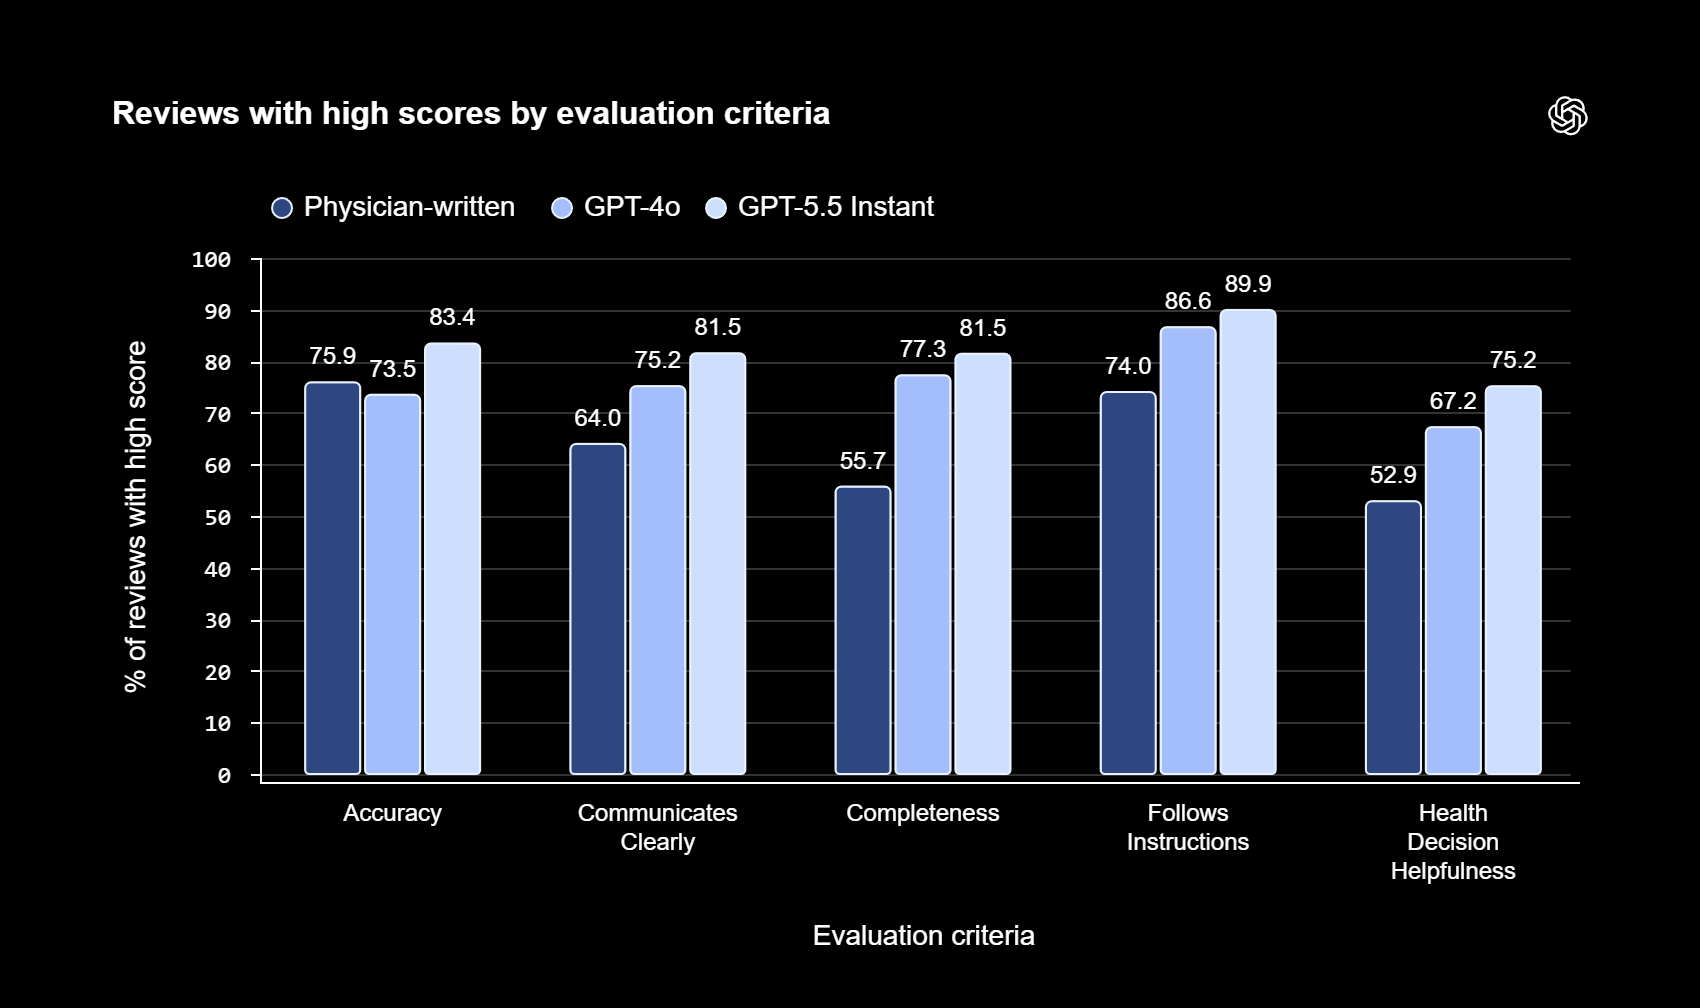
- 벤치마크: HealthBench와 HealthBench Professional에서 GPT-4o, 그리고 의사가 직접 쓴 답변을 다섯 개 평가 항목 전부에서 앞섰습니다.
- 수치: 지시 따르기(instruction following) 항목 최고 89.9%, 잘못된 의료 정보가 나오는 비율은 두 달 만에 71% 떨어졌습니다.
- 검증: 60개국, 260명 이상의 의사가 70만 건이 넘는 모델 응답을 살펴봤습니다.
- 접근성: 무료 ChatGPT 사용자도 사용량 제한 안에서 쓸 수 있습니다.
본문
Instant 모델이 Thinking을 따라잡은 이유
지금까지 ChatGPT의 의료 응답 품질은 보통 ‘Thinking’ 계열, 즉 추론 모드에 더 많은 비용을 들이는 모델에서 가장 좋았습니다. 문제는 이 모드가 비싸고 느리다는 점입니다. 일반 사용자가 검진 결과 한 줄을 물어보려고 매번 Thinking을 쓰기는 부담스럽습니다.
GPT-5.5 Instant는 이 격차를 의식하고 만든 모델입니다. Thinking 계열이 자랑하던 의료 응답 수준을, 일반 응답 속도와 일반 가격대에서 그대로 내려놓는 것이 이번 업데이트의 목표입니다. OpenAI가 공개한 자체 그래프를 보면, GPT-5.5 Instant의 헬스벤치 곡선은 이전 세대의 Thinking 모델 곡선과 거의 겹칩니다.
의사보다 잘하는 다섯 가지 항목
OpenAI는 이번에 평가 축을 다섯 개로 나눠 비교했습니다. 정확성, 완결성, 명확성, 지시 따르기, 그리고 맥락 인식 항목입니다. 모든 항목에서 GPT-5.5 Instant는 GPT-4o를 넘어섰고, 의사가 직접 쓴 답변까지 앞섰습니다. 가장 점수가 높았던 항목은 지시 따르기로 **89.9%**를 기록했습니다.
여기서 한 가지 짚어둘 점이 있습니다. ‘의사가 쓴 답변보다 낫다’는 표현은 진료를 대체했다는 뜻이 아닙니다. 같은 질문지에 같은 형식으로 답을 쓰게 했을 때, 텍스트 응답 품질만 평가한 결과입니다. 그래도 의미는 있습니다. 환자가 챗봇에 검사 결과를 붙여 넣고 “이게 무슨 뜻이냐"고 물을 때, 평균적인 의사보다 더 알아듣기 쉽고 빠짐없이 설명하는 모델이 무료로 풀렸다는 뜻이니까요.
잘못된 정보 비율, 두 달 만에 71% 감소
의료 도메인에서 가장 무서운 것은 그럴듯한데 틀린 답입니다. OpenAI는 이번에 잘못된 의학 정보(incorrect health statements)가 등장하는 비율을 두 달 만에 71% 줄였다고 밝혔습니다. 짧은 기간에 큰 폭으로 떨어진 셈입니다.
비결은 사람입니다. 60개국에서 모은 260명 이상의 의사 네트워크가 모델 응답을 검토했고, 그 수가 70만 건을 넘었습니다. 단일 평가팀이 아니라 분야별 임상의가 분산해서 답을 들여다본 구조라, 특정 진료과에 치우치지 않은 피드백이 모인 것으로 보입니다.
주간 2.3억 명, 무시할 수 없는 트래픽
OpenAI가 이번 발표에서 강조한 또 하나의 숫자가 있습니다. 매주 약 2억 3천만 명이 ChatGPT를 건강 관련 질문에 쓰고 있다는 수치입니다. 검사 결과 해석, 진료 예약 전 사전 정리, 보험 처리 관련 문의가 대표적입니다.
이 정도 트래픽이 무료 모델 위에서 돌고 있다면, 잘못된 응답 한 건의 사회적 비용은 더 이상 작은 문제가 아닙니다. 71%라는 숫자가 단순한 자랑이 아니라 위험 관리 지표처럼 다뤄져야 하는 이유입니다.
임상 현장용 도구는 따로
OpenAI는 일반 사용자용 ChatGPT와 별개로 임상 현장을 겨냥한 제품도 굴리고 있습니다. ChatGPT for Clinicians와 OpenAI for Healthcare가 그것입니다. 일반 모델이 환자 쪽의 질문을 받아주는 동안, 임상용 라인은 의무기록, 진료 지원, 워크플로 자동화 쪽을 따로 잡아가는 모양새입니다.
실무자가 볼 핵심 포인트
- 무료 티어 영향: 무료 ChatGPT가 의료 1차 응답 품질을 또 한 번 끌어올렸습니다. 환자용 챗봇이나 사내 헬스케어 어시스턴트를 자체 모델로 만들고 있다면, ‘무료 ChatGPT보다 나은지’가 새 기준선이 됩니다.
- 벤치마크 활용: HealthBench와 HealthBench Professional은 외부 팀도 참고할 수 있는 공개 평가 척도가 됩니다. 자체 모델 평가 시 비교 대상으로 끼워두면 설득력이 올라갑니다.
- Instant vs Thinking 선택: 이번 결과는 ‘Thinking 아니면 안 된다’는 통념을 흔듭니다. 비용 대비 품질을 다시 계산해볼 시점입니다.
- 할루시네이션 관리: 두 달 만에 71% 감소라는 수치는, 임상의 인간 피드백 루프가 RLHF만큼 강력하다는 신호입니다. 헬스케어 RAG·평가 파이프라인을 설계할 때 임상 리뷰어 풀 확보가 다시 중요해집니다.
- 법·규제 라인: 답변 품질이 의사를 넘어섰다는 헤드라인이 퍼질수록, ‘진단·처방이 아니라 정보 제공’이라는 면책 문구는 더 단단히 들어가야 합니다.