착륙 직전 30초 동안의 비행 기록을 AI가 알아듣기 쉬운 ‘말’로 바꾸고, 비슷한 과거 착륙 사례와 통계 프로그램의 조언을 함께 보여줘서 ‘이 착륙이 왜 거칠었는지’까지 글로 설명하게 만든 시스템이다.
무엇이 문제였나 — 지금까지 비행 데이터 AI는 ‘이 착륙은 위험했다’는 결론만 내놓았고, 왜 그랬는지는 전문가가 그래프를 다시 들여다보며 해석해야 했다. 어떻게 풀었나 — 이 연구는 착륙 직전 30초의 숫자 기록을 ‘평소보다 매우 낮음 ~ 매우 높음’ 다섯 단계의 말로 바꾸고, 통계 프로그램의 예측과 가장 비슷한 과거 착륙 두 건(무사히 내린 사례 하나, 충격이 컸던 사례 하나)을 함께 보여준 뒤 AI에게 판단과 이유를 쓰게 한다. 그래서 뭐가 좋아졌나 — 실제 여객기 704편 자료에서 맞힌 비율이 기존 최고 모델보다 조금 앞섰고, 무엇보다 ‘기수를 너무 늦게 들어 올렸다’ 같은 조종 동작 중심의 설명과 ‘이렇게 했으면 괜찮았다’는 조언까지 함께 내놓았다.
건강검진 결과지를 그대로 주는 대신 ‘혈압 180/110, 상위 5% 수준으로 매우 높음’처럼 정리해서 보여주고, 비슷한 과거 환자 차트 두 장(회복한 사람, 나빠진 사람)을 나란히 놓아준 뒤 신참 의사에게 ‘왜 위험한지 써보라’고 시키는 것과 같다. 여기서 AI가 신참 의사, 통계 프로그램이 옆에서 소견을 먼저 말해주는 선배 의사, 다섯 단계 라벨이 정리된 검진 요약 카드다.
논문 정보
Lu Xu, Xu Li, Linjiang Zheng, Fan Li, Riquan Zhang, Jiaxing Shang (교신저자) · Chongqing University (컴퓨터과학대학), Civil Aviation Flight University of China (사천 비행공학기술연구센터), Shanghai University of International Business and Economics (통계·데이터과학대학) · IEEE 저널 투고 원고 (IEEE Trans. 서식, Manuscript received 2026 — 게재지 미확정) · 2026
왜 중요한가
착륙 사고 분석 결과는 조종사 교육과 사고 예방 대책에 곧바로 쓰이기 때문에 ‘왜 그랬는가’라는 답이 반드시 필요하다. 맞히는 정확도와 설명을 동시에 얻으면, 같은 실수가 반복되지 않도록 훈련 과제를 사람마다 맞춤으로 짤 수 있다. 또 숫자를 말로 바꿔 AI에게 넘기는 이 방식은 발전소·공장·철도처럼 센서 기록을 다루는 다른 분야에도 그대로 옮겨 쓸 수 있다.
핵심 지표
| 지표 | 값 | 설명 |
|---|---|---|
| Accuracy | 81.56% | FlightLLM-GPT와 FlightLLM-Deepseek 동일 수치, 최우수 베이스라인 SDTAN 80.14% (Table IV) |
| Precision | 85.71% | FlightLLM-Deepseek, 전체 10개 모델 중 최고. 다음이 FlightLLM-GPT 82.61%, 베이스라인 최고는 SDTAN 73.33% |
| Recall | 64.29% | FlightLLM-Deepseek. SDTAN 78.57%, CNN 83.93%보다 낮아 미탐지 위험이 커지는 트레이드오프 |
| F1-Score | 73.47% | FlightLLM-Deepseek(GPT 74.51). SDTAN 75.86이 여전히 최고 (Table IV) |
어떻게 동작하나
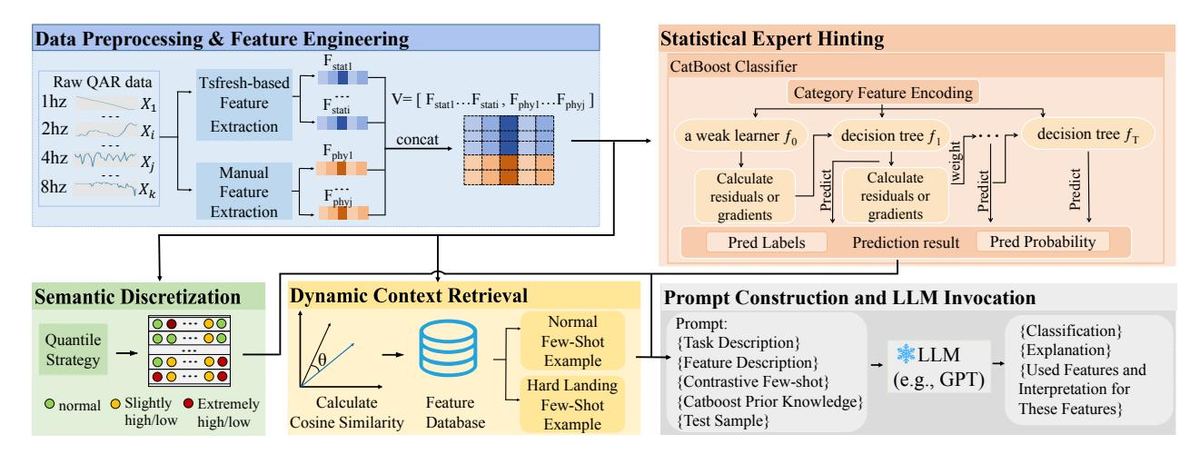
FlightLLM은 LLM을 비행 시계열에 적용할 때의 네 가지 난점(모달 불일치·분류 능력 부족·미세조정 데이터 희소·도메인 지식 결핍)을 모듈별로 공략한다. (i) 전처리·특징공학: 접지 시점 t를 모든 랜딩기어 접지 순간으로 정의하고 t−30초t 구간만 잘라 사후 신호 누출을 차단한 뒤, 서로 다른 샘플링 주기의 32개 파라미터를 4Hz로 통일한다. TSFresh 자동 통계 특징(유의성 검정으로 top-k 선별)과 항공 도메인 물리 지표(50ft/20ft→접지 소요시간, 구간 최소 하강률, 접지 피치, 최대 피치 변화율, 접지 속도편차, 최대 횡풍 등)를 결합해 하이브리드 벡터 V = F_stat ⊕ F_phy를 만든다. (ii) Semantic Discretization: 각 특징의 전역 분포에서 5·25·75·95 분위수를 임계값으로 삼아 Extremely LowExtremely High 다섯 라벨로 사상하고, ‘물리적 의미 + 의미 라벨 + 원시 수치’를 묶은 서술자를 만들어 LLM이 암묵적 수치 비교를 하지 않도록 한다. (iii) Statistical Expert Hinting: CatBoost의 예측 라벨과 확률, 특징 중요도를 프롬프트의 보조 전문가 리포트로 주입해 weak-to-strong 방식으로 추론을 안내하되, 불일치 시 LLM이 근거를 재검토하도록 지시한다. (iv) Dynamic Context Retrieval: 코사인 유사도 argmax로 가장 유사한 정상 사례 1건과 하드랜딩 사례 1건을 뽑아 대비 few-shot 문맥을 구성한다. (v) Prompt Construction: 시스템 페르소나·특징 사전·보조 리포트·대비 사례·CoT 지시·JSON 스키마(Classification / Reasoning_Chain / Explanation / Counterfactual)로 출력 형식을 강제한다. 평가는 GPT-3.5, DeepSeek-V1, GLM-4.7-flash 세 백본과 LSTM·SVM·RF·KNN·CNN·IMTCN·SDTAN 7개 베이스라인 비교, 3종 절제 실험, 사례 기반 해석 검증, 백본 간 특징 주목도 히트맵(일관성 분석)으로 구성된다.
 Fig. 1 FlightLLM 전체 프레임워크. Data Preprocessing & Feature Engineering → Semantic Discretization → Statistical Expert Hinting(CatBoost) → Dynamic Context Retrieval → Prompt Construction & LLM Invocation의 다섯 모듈 연결을 보여준다.
앞 네 모듈이 숫자-언어 모달 간극과 LLM의 분류 약점, 데이터 희소, 도메인 지식 결핍을 각각 메우고 다섯 번째 모듈이 인터페이스 역할만 한다. LLM을 학습시키지 않고 입력만 재설계해 성능과 설명을 동시에 얻는 weak-to-strong 구조가 핵심이다.
핵심 수식:
\Phi(f) = \begin{cases} s_1, & f \le \tau_1 \\ s_2, & \tau_1 < f \le \tau_2 \\ s_3, & \tau_2 < f < \tau_3 \\ s_4, & \tau_3 \le f < \tau_4 \\ s_5, & f \ge \tau_4 \end{cases} \qquad CS(x_{query}, d_q) = \frac{\sum_{i=1}^{n} x_{query_i}\, d_{q_i}}{\sqrt{\sum_{i=1}^{n} x_{query_i}^2}\;\sqrt{\sum_{i=1}^{n} d_{q_i}^2}}
왼쪽(식 3): 연속 특징 f를 전역 분포의 임계값 τ=[τ1,τ2,τ3,τ4](각각 5th·25th·75th·95th 백분위수)로 나눠 순서 있는 의미 토큰 S={s1..s5}={Extremely Low, Slightly Low, Normal, Slightly High, Extremely High}에 사상한다. 오른쪽(식 8): 쿼리 특징 벡터 x_query와 참조 DB의 후보 d_q 사이 코사인 유사도로, 이 점수의 argmax를 정상 집합·하드랜딩 집합에서 각각 취해(식 9·10) 대비 few-shot 사례 x_norm, x_hard를 고른다.
한계와 주의할 점
- 해석 품질 평가가 하드랜딩 1건에 대한 정성 사례 연구와 백본 간 주목도 히트맵에 그친다. 조종사·안전 전문가에 의한 설명 정확도의 정량 평가나 블라인드 비교가 없어 ‘설명 가능성 우위’ 주장은 근거가 제한적이다.
- Precision을 끌어올린 대가로 Recall이 64.29%로 하락해(SDTAN 78.57%, CNN 83.93%) 실제 하드랜딩을 놓치는 비율이 늘었다. 논문은 ‘경보기가 아닌 진단 도구’라는 목적으로 이 트레이드오프를 정당화하지만, 운영 배치 시에는 재검토가 필요하다.
- Table IV의 FlightLLM(Deepseek) F1이 73.47인데 Table V의 FlightLLM 행은 73.41로 표기돼 있어 두 표가 서로 어긋난다(Precision·Recall·Accuracy는 동일).
- A320 단일 기종·하드랜딩 단일 사건에만 검증됐고, 분위수 임계값이 이 데이터 분포에서 산출되므로 기종·공항·계절이 바뀌면 라벨 경계를 다시 잡아야 한다.
- 정상 표본을 37,647편에서 422편으로 무작위 축소해 계산 부담을 줄였으나, 정상 패턴 분포의 대표성이 편향됐을 가능성이 있고 베이스라인과의 비교도 이 축소된 분포 위에서만 이뤄졌다.
- 논문 스스로 밝힌 대로 항공 도메인 미세조정을 하지 않아 성능·추론 일관성이 사전학습 백본 품질에 그대로 종속된다(GLM 백본은 Accuracy 78.01로 SDTAN보다 낮다).
- CatBoost가 강한 사전 신호를 주면 LLM이 이를 그대로 승인해 잘못된 확신 기반 설명을 생성하는 weak-to-strong 실패(논문은 불일치 시 재검토를 지시할 뿐, 실제 반박 빈도는 측정하지 않았다).
- 의사결정 경계 부근 사례에서 의미 라벨이 한 단계 낮게 배정되면 LLM이 위험을 과소평가해 False Negative를 낸다(Recall 64.29의 주요 원인).
- 대비 few-shot이 없을 때(Zero-Shot, Variant C)는 반대로 사소한 변동을 결정적 이상으로 과잉 해석해 Precision이 63.01까지 떨어진다 — 문맥 유무에 따라 과잉·과소 두 방향 모두로 무너진다.
- 코사인 유사도가 고차원 특징 공간에서 의미적으로 동떨어진 사례를 끌어오면, 대비 few-shot이 오히려 추론을 교란한다.
- 도메인 지식이 프롬프트로만 주입되므로 LLM이 항공 물리와 모순되는 설명을 생성할 여지가 남는다(논문은 이를 환각 위험으로 명시).
시스템 적용 아이디어
논문의 기법을 비슷한 구조를 가진 시스템에 옮길 때의 적용 지점이다.
수치 신호를 분위수 의미 라벨로 바꿔 LLM 입력 전에 정제하는 어댑터
논문 Section III.B를 그대로 분리해 ‘수치 시계열·계량 데이터 → LLM’ 구간의 표준 전처리 어댑터로 쓴다. 적용 지점은 RAG 검색 결과에 딸린 메트릭(점수·온도·지연 ms 등) 직렬화 단계, 또는 에이전트가 관찰한 환경 수치를 LLM에 넘기기 직전 직렬화 단계다. 분위수 임계값은 이력 데이터에서 한 번 산출해 캐시하면 재학습 없이 동작하고, 논문처럼 ‘의미 라벨 + 원시값’을 함께 실어 정보 손실을 막는다. 다만 경계값 바로 아래 샘플이 한 단계 낮게 강등돼 위험이 과소평가되는 인지 수렴 현상이 논문에서 보고됐으므로, 경계 근접 샘플에는 별도 플래그를 붙이는 보완이 필요하다.
적용 지점 — LLM 입력 직전 수치→의미 직렬화 어댑터 (RAG 메타데이터 직렬화, 에이전트 관찰값 인코딩)
기대 효과 — 논문 Table V 기준, 이 모듈 제거 시 Precision이 85.71→67.16으로 18.55%p 떨어짐(Recall은 오히려 80.36으로 상승) — 수치→의미 환원이 안정적 결정 경계 형성에 직접 기여
약한 분류기를 LLM 추론의 사전 가이드로 주입하는 weak-to-strong 통계 전문가 패턴
논문 Section III.C ‘Statistical Expert Hinting’의 일반화다. 에이전트가 분류·판정을 내려야 하는 단계에서 부스팅 모델(XGBoost·LightGBM·CatBoost)을 백그라운드로 돌려 라벨·확률·상위 중요 특징을 시스템 프롬프트의 ‘Auxiliary Expert Report’ 섹션에 주입한다. LLM은 prior와 일치하면 근거를 보강하고 불일치하면 증거를 재검토하도록 지시받는다. 결정 신뢰도 헤더에 보조 모델 확률을 함께 노출하면 사용자가 LLM 단독 판단과 구분해 다룰 수 있다. 단, 논문도 LLM이 prior를 실제로 몇 번이나 반박했는지는 측정하지 않았으므로 도입 시 반박률을 별도 계측할 것.
적용 지점 — 에이전트 하네스의 결정 단계(작업 분류·위험 등급 판정·다음 액션 선택) prior 주입
기대 효과 — 논문 Table V 기준, 이 모듈 제거 시 Accuracy 81.56→75.18(-6.38%p), F1 73.41→63.92(-9.49%p), Recall 64.29→55.36으로 전 지표 악화
코사인 유사도 기반 대비 few-shot 검색기로 결정 경계를 안정화
논문 Section III.D ‘Dynamic Context Retrieval’의 일반화다. 에이전트 장기 기억 회수 단계나 툴 실행 이력 재순위 단계에서, 쿼리 벡터와 저장된 사례 벡터 사이 코사인 유사도를 계산해 같은 클래스·다른 클래스에서 각각 argmax로 1건씩 뽑아 대비 쌍을 만든다. LLM은 ‘거의 같아 보이는 두 사례의 미세한 차이’에서 결정 경계를 읽으므로, 정적 few-shot 예시 고정이 갖는 분포 편향도 자동으로 해소된다. 고차원 공간에서 코사인 유사도가 의미적으로 동떨어진 사례를 뽑을 수 있으므로 유사도 하한선을 두는 것이 안전하다.
적용 지점 — 장기 기억 회수(에피소드 검색) 단계 및 검색 결과 재순위 단계의 대비 few-shot 주입
기대 효과 — 논문 Table V 기준, 이 모듈 제거(Zero-Shot) 시 Accuracy 81.56→73.76(-7.80%p), Precision 85.71→63.01(-22.70%p)로 세 모듈 중 Precision 기여가 가장 큼
피처별 추론 체인 + 반사실 조건을 강제하는 구조화 JSON 출력
논문 Fig. 3의 프롬프트 템플릿과 Table II의 5단 구조(System Persona / Context Injection / Input Formulation / Task Constraints / Output Schema), Fig. 5의 실제 출력 예시를 일반화한다. 진단·분류·사후 분석 결론을 내는 에이전트의 종료 직전 출력 단계에서 ‘Reasoning_Chain(피처, 값, 도메인 해석, 중요도)‘과 ‘Counterfactual(분류가 뒤집힐 조건)’ 필드를 명시한 JSON 스키마를 강제하면, 결론 도약 없이 근거를 순차 작성하게 되고 ‘다음번엔 어떻게 해야 하는가’가 자동으로 산출된다. 논문의 Task Constraints에 있던 ‘증거가 상충하면 모호함을 명시하라’는 항목도 함께 옮기면 과잉 확신을 줄일 수 있다.
적용 지점 — 에이전트 종료 직전 진단·결론 출력 단계 (분류·사후 분석·조언 생성)
기대 효과 — 정성적 효과: Fig. 5에서 이 스키마가 ‘늦은 플레어(Δt20→TD=2.25s)·급격한 피치 보정·2차 요인으로 강등된 풍속’ 같은 구조화된 근거와 ‘플레어를 3.5초 이상으로, 피치율 2.0deg/s 미만으로’ 같은 구체적 조언을 실제로 산출함. 정량 지표는 별도 보고되지 않음
단계별 도입 로드맵
| 단계 | 목표 | 액션 | 기대 효과 |
|---|---|---|---|
| Phase 1 (0~6개월, 파일럿 검증) | 하드랜딩 단일 이벤트에서 SDTAN/CNN 대비 Precision 우위를 재현하고, 논문에 없는 설명 품질의 정량 평가 체계를 만든다 | 접지 30초 전 윈도우·4Hz 리샘플링 파이프라인 표준화, 분위수 라벨·CatBoost prior·대비 few-shot 모듈 순차 통합, GLM·GPT·Deepseek 동일 지표 비교 재현, 조종사·안전 전문가 대상 설명문 블라인드 평가 루브릭 설계, Recall 저하 구간(경계 사례) 별도 집계 | Accuracy 81.56%·Precision 85.71% 수준 재현 확인과 함께, 기존 SHAP/CAM 결과를 전문가가 재해석하던 단계를 문서 초안 생성으로 대체 |
| Phase 2 (6~14개월, 멀티이벤트 확장) | 테일 스트라이크·롱랜딩 등 2~3개 사건으로 확장하고 사건 간 지식 전이를 검증한다 | 공통 의미 라벨 어휘 사전 통합, CatBoost 멀티헤드 prior로 교체, 사건별 프롬프트를 수동 재작성하지 않아도 되는 템플릿·도메인 사전 분리 설계, 통합 데이터셋에서 단일 LLM 멀티이벤트 추론 평가 | 단일 모델이 복수 안전 사건을 진단해 사건별 전담 모델 운용 비용을 줄이고 설명 어휘의 일관성을 확보 |
| Phase 3 (14~24개월, 운영 통합·지속 학습) | 사후 분석 워크플로에 LLM 진단을 내장하고, 도메인 미세조정으로 추론 안정성과 Recall을 함께 끌어올린다 | 항공 도메인 미세조정(LoRA 등)으로 지식 내재화, 경계 사례 전용 보수적 판정 모드 추가, LLM 호출 비동기화·캐싱으로 지연 관리, 조종사·분석가 피드백 라벨 수집 및 재학습 루프 구축, 기종 확장 시 분위수 임계값 재산출 SOP 운영 | Precision과 Recall이 함께 관리되는 진단 시스템과, 연간 하드랜딩 비율 등 예방 KPI의 직접 추적 |
원문 PDF: 2026-08-20-can-large-language-models-explain-flight-safety-events-a-prior-guided-se.pdf