AI 코딩 도우미가 오래된 기록을 지우지 않고 보관함으로 옮겨, 필요하면 다시 꺼내면서도 매번 읽는 양을 줄이는 방법이다.
무엇이 문제였나 — AI 코딩 도우미는 작업을 이어가기 위해 이전 대화, 파일 내용, 빌드 로그, 테스트 결과를 매번 다시 읽는다. 어떻게 풀었나 — 하지만 이미 끝난 작업 기록이나 거의 똑같이 반복되는 로그까지 계속 읽으면 비용과 컨텍스트 사용량이 커진다. 그래서 뭐가 좋아졌나 — 이 논문은 오래된 내용은 원문 그대로 보관하고 작은 표식만 남기는 방식으로, 필요하면 되돌릴 수 있게 하면서 토큰을 약 20% 줄였다고 보고한다.
책상 위에 모든 서류를 계속 쌓아두지 않고, 끝난 서류는 원본 그대로 보관함에 넣은 뒤 책상에는 짧은 색인 카드만 남기는 것과 비슷하다. 같은 영수증이 매일 반복해서 출력된다면 가장 최근 것만 책상에 두고 나머지는 보관함으로 옮긴다.
논문 정보
M. Y. Pitsane, H. Mogale · Mankind Research Labs, Sandton (North-West University & University of Pretoria, RSA) · Technical Report, Mankind Research Labs · 2026
왜 중요한가
AI 코딩 도구는 작업이 길어질수록 실제로 도움이 되지 않는 과거 기록까지 반복해서 모델에 보내는 경향이 있다. 이 논문은 정보를 완전히 버리는 대신 다시 꺼낼 수 있게 보관하므로, 단순 삭제나 요약보다 안전하게 비용을 줄이는 방향을 제시한다.
핵심 지표
| 지표 | 값 | 설명 |
|---|---|---|
| 토큰 절감 (Condition E vs Carry-all, 중앙값) | 20% | 43,053 → 34,518 tokens/task, constrained 4000-token window |
| 모델별 토큰 절감 범위 | 17–26% | gpt-4.1부터 gpt-5.6 계열(sol/luna/terra)까지 7개 OpenAI 모델에서 보고된 범위 |
| 소환 0건 (Condition E) | 0회 | E 조건 450건 매립 중 378건이 RDM이었고, RDM 포함 전체 소환은 0건 |
| 최저 오버플로율 | 4.00건/에피소드 | Condition E 기준, Carry-all 5.21 대비 감소 |
어떻게 동작하나
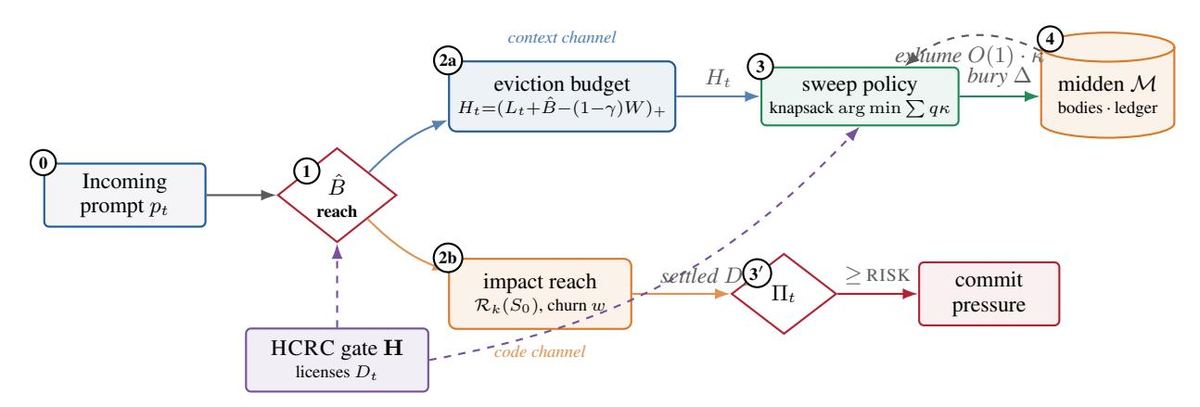
세션의 각 턴에서 Blast Radius는 두 채널을 구분한다. 컨텍스트 채널은 새 프롬프트가 실행된 뒤 새로 유지될 토큰 증가량 B̂(p_t, C_t)을 예측하고, 현재 load와 safety margin을 반영해 eviction budget H_t를 계산한다. 코드 채널은 AST와 dependency DAG에서 편집된 파일·심볼의 k-hop reach와 churn w(v)를 읽고, 파일 누적 변경량이 RISK tier를 넘으면 commit-pressure signal Π_t를 발생시킨다. 실제 추방은 NECROPHORESIS가 수행한다. 매립 대상 본문은 온디바이스 SQLite midden에 byte-exact로 보관되고, 컨텍스트에는 약 60토큰짜리 scent skeleton만 남는다. 반복 도구 출력은 Σ 정규화 맵으로 volatile content를 제거한 뒤 recurrence class로 묶고, 최신 인스턴스만 resident로 유지하며 오래된 인스턴스는 RDM으로 매립한다. 클래스별 resurrection probability는 q̂_c = (e_c+1)/(k_c+2)로 추정하며, 모든 burial/exhumation은 ledger에 기록되어 실제 exhumation rate가 정책을 검증한다.
 Blast Radius의 두 채널 구조: 컨텍스트 채널은 eviction budget H_t를 만들고, 코드 채널은 churn-weighted dependency reach를 통해 commit-pressure signal Π_t를 만든다.
HCRC는 어떤 기록을 치워도 되는지 허가하고, Blast Radius는 그중 무엇을 얼마나 치울지와 다음 작업의 영향 범위를 정하는 계층이다.
핵심 수식:
B(x) = r(x) \sum_{y \in N(x)} w(x,y) + \lambda \, c(x)
원문 Definition 6.2의 blast radius 함수다. r(x)는 retention likelihood, N(x)는 dependency neighborhood, w(x,y)는 dependency graph의 Borel-measurable weighting function, c(x)는 churn estimate, λ는 code-channel 항의 튜닝 상수다. 첫 항은 context-channel의 predicted retained-token increment, 둘째 항은 churn-weighted structural reach를 나타낸다.
실험 결과
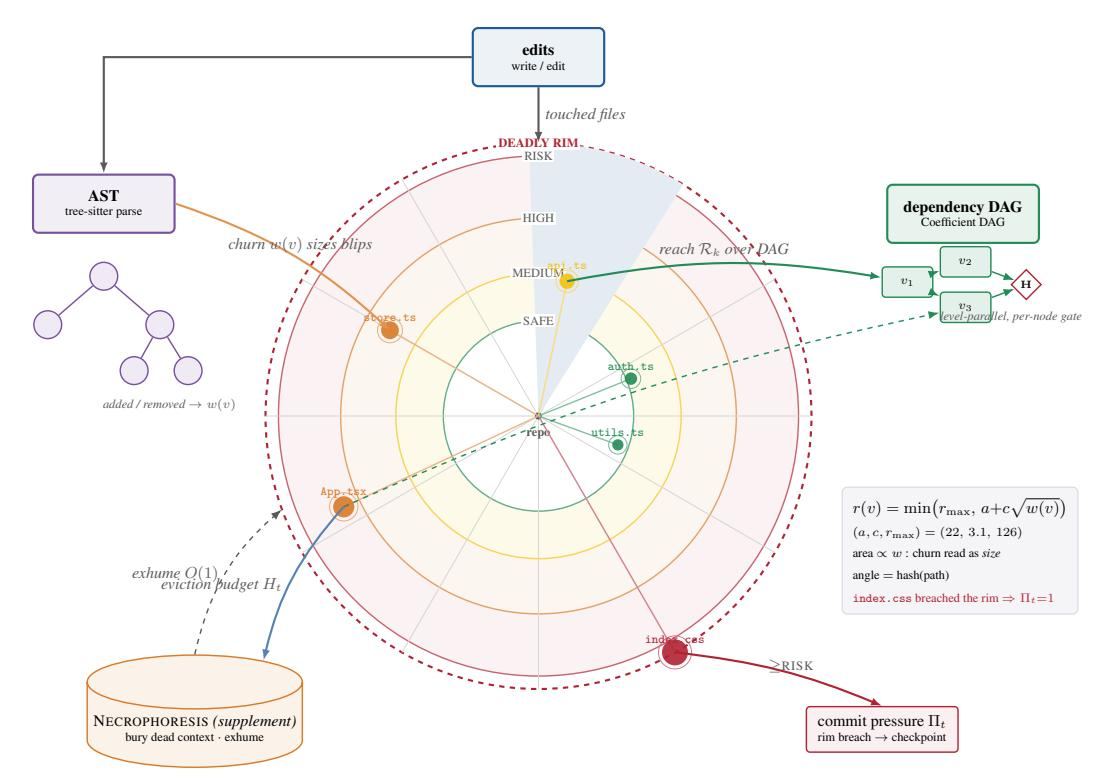 실제 운용 스케일의 Blast Radar: AST에서 파일별 churn을 읽고 dependency DAG에서 reach를 전파해 MEDIUM/HIGH/RISK/DEADLY tier와 commit-pressure를 표시한다.
r(v)=min(r_max, a+c√w(v))를 사용해 blip의 면적이 churn에 비례하도록 만든 점이 핵심이다.
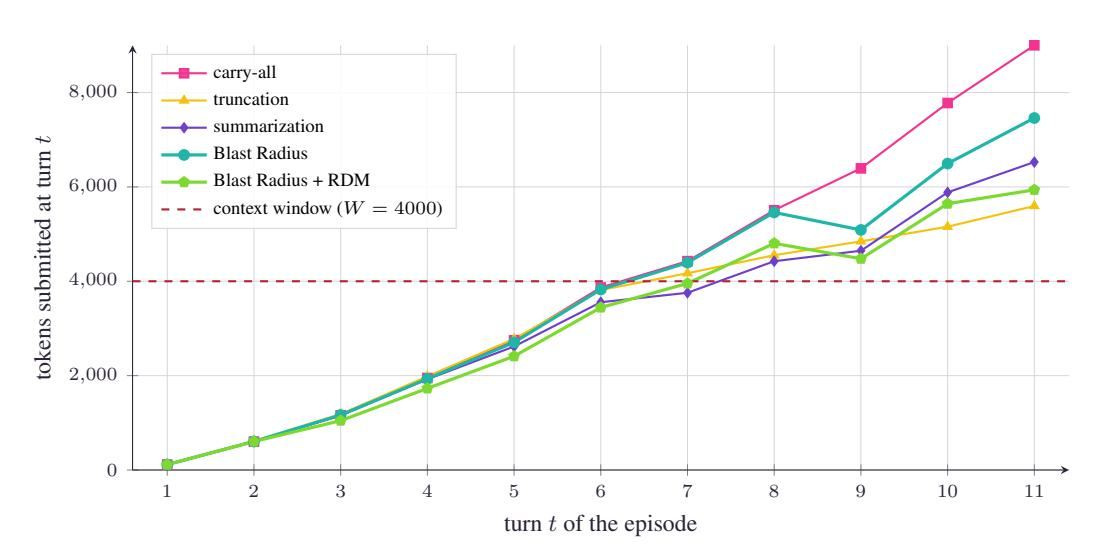 5개 정책의 턴별 평균 제출 토큰 곡선: Carry-all은 중반 이후 context window 위로 올라가고, RDM을 더한 E가 가장 낮은 working set을 유지한다.
E는 반복 도구 출력을 임계치 대기 없이 recurrence 발생 시 바로 매립하므로 초반부터 D와 곡선이 분리된다.
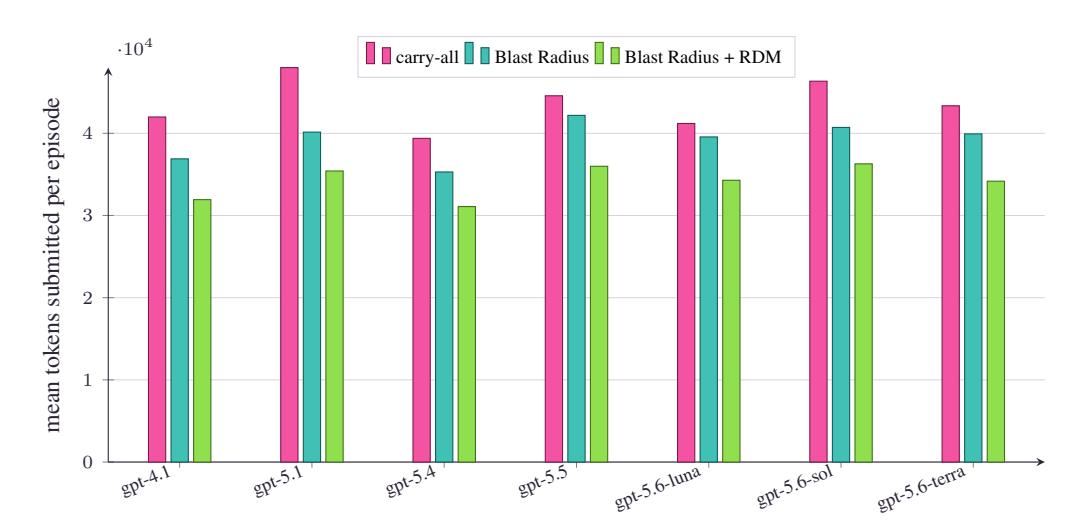 7개 OpenAI 모델에서 Carry-all, deployed Blast-Radius, Blast-Radius+RDM의 평균 제출 토큰을 비교한다.
RDM 절감이 모델 세대 전반에서 나타난다는 점은 비용 문제가 모델 자체보다 반복되는 세션 루프에서 온다는 해석을 뒷받침한다.
한계와 주의할 점
- 실험은 OpenAI 7개 모델(gpt-4.1~gpt-5.6 계열)에 한정되어 있으며, Anthropic·Google·Alibaba·DeepSeek·Meta 등 cross-provider matrix는 향후 확장 대상으로만 제시된다.
- 평가는 constrained 4000-token window에서 수행되었으므로 더 큰 context window에서 절감률과 overflow 개선이 어떻게 달라지는지는 직접 검증되지 않았다.
- 논문 안에서 episode-run 수가 일관되지 않다. Experimental Protocol은 56 episode-runs라고 쓰지만 Table 2 캡션은 70 episode-runs라고 적는다.
- 성공률은 모든 조건에서 100%라서, reversible 정책이 lossy truncation/summarization보다 품질 면에서 실제로 우월한지를 이 벤치마크만으로는 강하게 구분하기 어렵다.
- RDM은 released harness의 condition E로 구현·측정되었지만, Chalk의 shipped census와 radar에 완전히 통합되는 작업은 underway라고 명시되어 있다.
- 배포 정책은 learned estimator가 아니라 K=3 보호 윈도우, 800자 floor, θ=4000, q_t(b)=0이라는 보수적 hard rule에 의존한다.
- HCRC가 settled로 잘못 판정한 본문이 매립되면 원문은 보존되어 있어 다시 꺼낼 수 있지만, exhumation이 일어나기 전까지 모델은 skeleton만 보고 작업하므로 응답 품질이 일시적으로 흔들릴 수 있다.
- RDM의 Σ 정규화가 volatile content를 제거하는 과정에서 의미적으로 다른 도구 출력을 같은 recurrence class로 묶으면 오래된 내용을 너무 빨리 매립할 수 있다.
- 큰 1회성 출력은 recurrence가 없으므로 RDM으로 즉시 처리되지 않고, census의 후보 조건과 θ=4000 임계에 도달해야 매립된다.
- 온디바이스 SQLite midden을 전제로 하므로 세션이 다른 머신으로 이동하거나 archive 접근이 끊기면 가역성의 운영상 이점이 약해진다.
- Redaction은 알려진 secret pattern 배터리에 의존하므로 인식하지 못한 비밀 형식은 archive에 남을 수 있다.
시스템 적용 아이디어
논문의 기법을 비슷한 구조를 가진 시스템에 옮길 때의 적용 지점이다.
에이전트 툴 루프의 반복 데드 매터(RDM) 재분류 모듈
메시지 적재 직후 Σ 정규화로 counters, timings, hashes 같은 volatile content를 제거하고 generator+stable head 기준으로 recurrence class를 만든다. 최신 인스턴스는 resident로 유지하고 이전 인스턴스는 byte-exact archive와 skeleton으로 대체한다. 클래스별 burial k와 exhumation e를 ledger에 기록해 q̂_c=(e_c+1)/(k_c+2)를 계산한다.
적용 지점 — 에이전트 메시지 누적 단계, tool transcript ingest 직후
기대 효과 — 원문 Figure 7은 condition E의 reclaimed mass 중 RDM이 39%라고 보고하며, Table 3은 E 조건 450건 burial 중 378건이 RDM이고 exhumation은 0건이라고 보고한다.
장기 세션을 위한 가역 미든 + 향기 골격 캐시
보호 윈도우 K=3, 800자 후보 floor, θ=4000 reclaimable-token threshold를 적용한다. 매립 시 bodies table에는 verbatim content, token count, scent, exhumation counter를 저장하고 ledger table에는 bury/exhume 이벤트를 append한다. skeleton은 복원에 쓰이는 원본이 아니라 archive key와 간단한 식별자 역할을 한다.
적용 지점 — 에이전트 컨텍스트 프루닝 단계, RAG 캐시 eviction 단계
기대 효과 — Theorem 7.1에 따르면 매립 기간 m’ 동안 (τ(b)-σ)m’만큼 절감되고, 잘못 매립해도 exhumation overhead κ로 downside가 제한된다. D 조건은 43,053→39,568 tokens/task를 기록했다.
검색 캐시 부활률을 라플라스 승계로 추정하는 자기 교정 축출기
각 class 또는 cache item마다 burial count k와 exhumation count e를 기록하고 q̂=(e+1)/(k+2)를 계산한다. q̂가 낮은 항목은 active set에서 skeleton만 남기고 원문은 archive로 이동한다. exhumation이 발생하면 q̂가 올라가므로 정책은 자동으로 보수화된다.
적용 지점 — RAG 검색 결과 캐시, 임베딩 인덱스 hot set, 툴 출력 캐시
기대 효과 — Table 3에서 E 조건은 450건 burial, 378건 RDM, exhumation 0건을 보고한다. 이는 반복 class가 계속 죽고 다시 필요해지지 않는 상황에서 공격적 매립이 안전할 수 있음을 보여준다.
변동 가중 도달 기반 커밋 압력 게이트
AST에서 파일별 added+removed line count w(v)를 계산하고, r(v)=min(r_max,22+3.1√w(v))로 radar blip을 표시한다. tier thresholds는 (50,200,500,1000) lines이며, 어떤 파일이 RISK tier인 500 lines 이상이면 Π_t=1을 발생시킨다. 이 신호는 edit을 막는 gate가 아니라 checkpoint/review 권고다.
적용 지점 — 에이전트 코드 편집 후속 단계, 하네스 후처리, 체크포인트 트리거
기대 효과 — 토큰 절감 자체보다 review surface가 너무 커지기 전에 운영자에게 개입 지점을 주는 효과가 있다. 원문은 이를 ambient signal, not a gate라고 설명한다.
단계별 도입 로드맵
| 단계 | 목표 | 액션 | 기대 효과 |
|---|---|---|---|
| Phase 1 | 보수적 census 매립(D 정책) 도입 | 보호 윈도우 K=3, candidacy floor 800 chars, skeleton cost σ≈60 tokens, sweep threshold θ=4000을 적용하고 burial/exhumation을 append-only SQLite ledger에 기록한다. HCRC 또는 동등한 검증 게이트가 settled body 후보를 허가하도록 둔다. | D 조건은 Table 2에서 43,053→39,568 tokens/task로 약 8% 절감을 보였고, 모든 burial은 byte-exact reversible 구조를 유지한다. |
| Phase 2 | RDM 재분류 추가로 반복 도구 출력 처리 | Σ 정규화로 generator와 stable head가 같은 transcript를 recurrence class로 묶고, 최신 인스턴스만 resident로 둔다. 클래스별 q̂_c=(e_c+1)/(k_c+2)를 ledger에서 추정한다. | E 조건은 총 450건 burial 중 378건이 RDM이었고, 전체 tokens/task를 34,518로 낮췄으며 overflow/ep. 4.00으로 최저치를 기록했다. |
| Phase 3 | hard rule에서 learned estimator r̂와 cross-provider 평가로 확장 | exhumation telemetry를 사용해 retention likelihood r(x)를 학습하고, OpenRouter 등을 통해 Anthropic·Google·Alibaba·DeepSeek·Meta 모델까지 동일 harness를 확장한다. | 현재의 보수적 zero-estimated-regret 정책을 더 세밀하게 조정하고, provider와 context-window 크기가 달라져도 결과가 유지되는지 검증할 수 있다. |
원문 PDF: 2026-08-11-blast-radius.pdf