개요
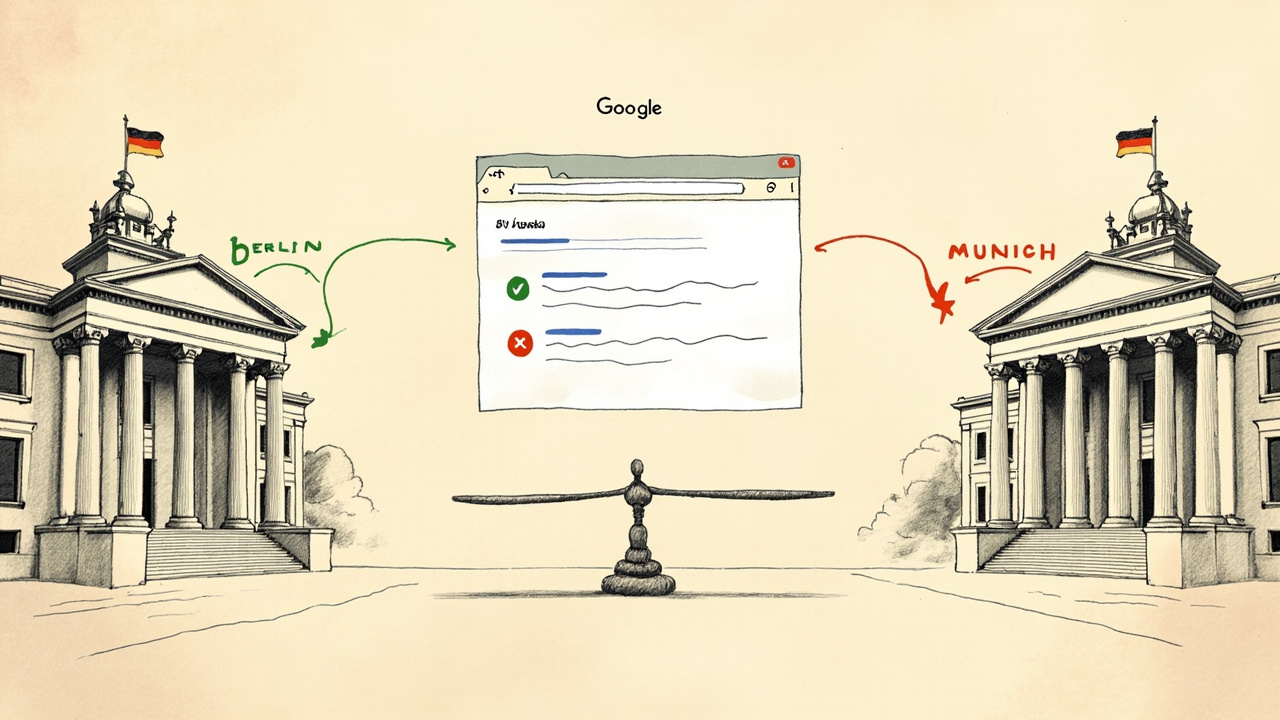
베를린 지방법원이 6월 초 흥미로운 판결을 하나 내놨습니다. 구글 검색에 붙는 AI 개요(AI Overviews) — 검색 결과 위쪽에 AI가 요약해 띄우는 그 박스 — 가 구글이 만든 독자적인 콘텐츠가 아니라, 그저 새로운 형태의 검색 결과 표시 방식이라는 결론입니다. 한 향수 회사가 자사 브랜드명이 모조품 사이트와 함께 노출된다며 상표권 침해를 주장했는데, 법원은 받아들이지 않았습니다.
문제는 며칠 전 뮌헨 법원이 거의 같은 기능을 두고 정확히 반대 결론을 냈다는 점입니다. 뮌헨은 “구글의 AI가 만든 발언이니 구글이 책임진다"고 본 반면, 베를린은 “그건 그냥 다른 사이트 내용을 모아 보여 주는 새 포맷"이라고 본 거죠. 같은 기능을 두고 두 법원이 정반대를 가리킨 셈인데, 항소심이 어떻게 정리하느냐에 따라 생성형 검색의 책임 지형이 통째로 바뀔 수 있습니다.
핵심 요약
- 베를린의 결론 — AI 개요는 “새로운 검색 결과 표시 형식”. 사용자도 다른 사이트 내용을 끌어모은 것임을 알아본다고 봤습니다.
- 법원이 본 결정적 사정 — 구글에는 응답 내용에 대한 “결정적 영향력(decisive influence)“이 없다. 외부 콘텐츠를 요약해 보여 줄 뿐이라는 시각.
- 사건의 발단 — 향수 회사가 자사 보호 브랜드명이 더 싼 모조품 사이트와 함께 노출됐다며 상표권 침해 소송. 법원은 기각.
- 뮌헨은 정반대 — 같은 6월, 뮌헨 법원은 AI가 두 출판사를 사기 사건과 연결시키는 허위 발언을 만들었다며 구글의 직접 책임을 인정.
- 법적 쟁점이 다르다 — 베를린은 상표권·경쟁법, 뮌헨은 허위사실로 인한 명예훼손 성격. 그래서 결과가 갈렸다는 해석.
- 현실 데이터의 균열 — 다수 사용자는 AI 개요 그 자체로 답을 소비하고 출처를 클릭하지 않는다는 조사가 있어, 베를린의 ‘사용자는 다 안다’ 전제는 흔들립니다.
본문
향수 회사의 소송, 그리고 베를린의 답
이번 판결의 발단은 한 향수 회사였습니다. 구글에서 자사 향수의 “모방 향(imitation)“을 검색하면 AI 개요가 등장하는데, 그 안에 회사의 등록 상표명이 등장하면서 동시에 더 싼 모조품을 파는 외부 사이트 링크가 함께 떴습니다. 회사 입장에선 자사 브랜드가 모조품 마케팅에 동원된 셈이죠. 그래서 상표권 침해와 부정경쟁행위로 구글을 걸었습니다.
베를린 법원의 답은 “구글은 그 정보를 만들지 않았다"는 쪽이었습니다. AI 개요는 어디까지나 외부 사이트에 이미 있던 내용을 요약해 노출했을 뿐이라는 거죠. 일반 사용자도 그 박스 안 내용이 구글이 직접 말하는 것이 아니라 다른 사이트들을 끌어모은 것임을 알아본다고 봤습니다. 그리고 결정적으로, 응답에 대한 결정적 영향력이 구글에 없다는 표현을 썼습니다. 상표권 침해도, 경쟁법 위반도 인정되지 않았습니다.
뮌헨은 왜 반대로 갔나
문제는 며칠 전 뮌헨에서 나온 판결이었습니다. 사실관계는 좀 달랐습니다. AI 개요가 두 출판사를 사기 사건에 엮어 버리는 허위 발언을 만들어 냈고, 그 내용은 인용된 어느 출처에도 등장하지 않는, 말 그대로 AI가 지어낸 연결이었죠. 뮌헨 법원은 “구글이 알고리즘과 매개변수를 단독으로 통제하고 있는 이상, AI가 만들어 낸 발언에 대해 구글이 책임져야 한다"고 봤습니다. “사용자가 직접 검증하면 되지 않느냐"는 구글 측 주장도 받아들이지 않았습니다.
쉽게 말해 뮌헨은 AI 개요를 독립된 발언자의 콘텐츠로 봤고, 베를린은 검색 결과의 새로운 표시 방식으로 본 겁니다. 같은 기능에 대해 두 법원이 완전히 다른 카테고리를 적용한 셈입니다.
베를린 논리의 약한 고리
베를린 판결의 핵심 전제 — “구글에는 결정적 영향력이 없다” — 는 따져 보면 흔들리기 쉽습니다. 구글은 AI 모델을 고르고, 시스템 프롬프트와 파라미터를 잡고, 응답이 어떤 구조로 만들어질지 정하고, 검색 결과 페이지 안에서 그 박스가 어디에 어떻게 보일지까지 결정합니다. 이 모든 결정이 사용자가 결국 읽게 되는 문장을 빚어냅니다. “그저 다른 사이트 내용을 모았을 뿐"이라고 하기엔 손을 댄 지점이 너무 많습니다.
현실 데이터 쪽으로 가도 마찬가지입니다. AI 개요를 본 사용자 다수는 그것을 그 자체로 완결된 답으로 소비하고, 출처 링크는 거의 누르지 않습니다. 그렇다면 결국 그 박스 안 문장이 사용자의 인식을 결정하는데, “사용자가 알아서 요약본인 줄 안다"는 전제는 너무 후한 가정이죠. 게다가 뮌헨 사건이 보여 줬듯, AI 개요는 인용된 출처에도 없는 내용을 생성해 내기도 합니다. 그렇게 만들어진 문장은 “다른 사이트 내용을 보여 준 것"이 아니라 그냥 구글의 발언이 되어 버립니다.
두 판결이 사실 다른 법을 다루고 있다는 시각
두 판결을 화해시키는 해석도 있긴 합니다. 뮌헨 사건은 허위사실이 핵심이었습니다. 누군가가 잘못 엮여 사기범 취급을 받았는데, 누구도 책임지지 않으면 피해자에게 구제가 없습니다. 뮌헨 법원은 그 공백을 막고 싶었던 거죠. 반면 베를린 사건은 상표권과 경쟁법 영역이었고, AI가 한 일은 결과적으로 외부 사이트의 실제 내용을 비교적 정확하게 요약한 것이었습니다. “AI가 진짜 문제를 일으킨” 사건이라기보다 “AI 화면에 보호 상표가 나란히 떴다"는 사건에 가까웠고요. 같은 기능이라도 다른 법리, 다른 사실관계라면 결론이 갈릴 수 있습니다.
문제는 그 다음입니다. 항소심이 두 판결 중 어느 쪽 손을 들어 주느냐에 따라, 구글뿐 아니라 인터넷 접근이 가능한 모든 AI 검색·답변 제품의 책임 범위가 달라집니다.
실무자가 볼 핵심 포인트
- AI 개요는 단순 표시 아님 — 모델 선택, 시스템 프롬프트, 출력 구조, 페이지 노출 위치까지 사업자가 잡는다. “검색 결과 표시 형식일 뿐"이라는 방어 논리는 항소심에서 약해질 수 있습니다.
- 사용자 인지 가정에 의존하지 말기 — “사용자는 AI 요약본임을 안다"는 가정은 클릭률 데이터와 충돌합니다. 출처 미클릭이 다수라면 그 박스 안 문장은 사실상 사업자의 발언으로 평가받기 쉽습니다.
- 허위 출력 한 건이면 입증 구도 바뀝니다 — 뮌헨 사건처럼 인용 출처에 없는 내용을 AI가 만들어 냈다면, “그저 다른 사이트 요약"이라는 방어는 막힙니다. 출처 외 내용 생성을 잡아 내는 회귀 테스트가 운영 리스크 핵심 지표입니다.
- 상표·브랜드 노출 모니터링 — 자사 브랜드가 모조품/대체품과 한 박스 안에 묶이는 패턴이 있는지 정기 모니터링이 필요합니다. 베를린 판례는 자동 차단을 보장하지 않습니다.
- EU 단일 결론을 기다리지 말기 — 독일 안에서도 법원마다 결론이 다릅니다. 운영 정책은 가장 엄격한 판결을 기준으로 잡는 게 안전합니다.
원문 출처
원문 보기 — Matthias Bastian, THE DECODER, 2026-06-16