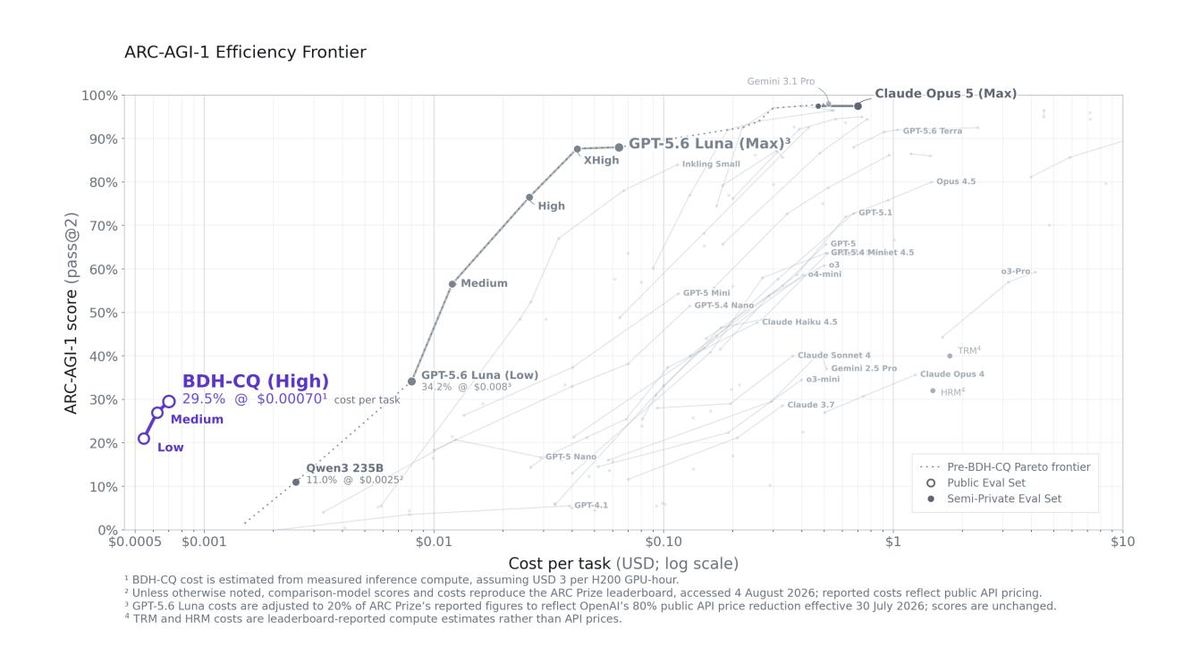
BDH-CQ는 색깔 격자 퍼즐의 예시 몇 개를 보고 규칙을 익힌 뒤, 풀이 과정을 글로 쓰지 않고 내부 계산만으로 답을 내는 작은 AI 모델이다.
무엇이 문제였나 — 기존 추론 모델은 중간 풀이를 단어로 길게 만들어 비용과 시간이 커질 수 있다. 어떻게 풀었나 — BDH-CQ는 예시를 볼 때마다 내부 기억을 갱신하고, 답을 낼 때는 숫자로 된 내부 상태를 여러 번 다듬는다. 그래서 뭐가 좋아졌나 — 공개 ARC-AGI-1 평가에서 400문제 중 118문제를 두 번 시도 기준으로 맞혔고, 계산 비용은 문제당 $0.00070으로 보고됐다.
사람이 퍼즐을 풀 때 풀이 과정을 종이에 전부 쓰지 않고 머릿속에서 여러 번 맞춰 본 뒤 답만 적는 상황과 비슷하다. BDH-CQ도 중간 생각을 문장으로 뽑아내기보다 내부 숫자 상태를 반복해서 고친다.
논문 정보
Bjorn Engdahl, Adrian Kosowski, Jan Chorowski, Zuzanna Stamirowska, Przemysław Uznanski, Junlin Jiang, Rohan Phadke, Remigiusz Kinas, Richard Zhong · Pathway / Bielik AI / New York University · arXiv preprint · 2026
왜 중요한가
AI가 문제를 풀 때 중간 풀이를 모두 글로 출력하면 토큰 비용과 대기 시간이 늘어난다. 이 논문은 중간 생각을 글로 쓰지 않고 내부 상태에서 반복 계산하는 방식으로도 예시 기반 문제 풀이가 가능하다는 점을 보여준다. 다만 정확도는 아직 29.5% 수준이고, 순서 정렬·여러 패널 결합·보지 못한 조건값 같은 문제에서는 뚜렷한 한계가 있다.
핵심 지표
| 지표 | 값 | 설명 |
|---|---|---|
| ARC-AGI-1 pass@2 | 29.5% | 400 공개 태스크 중 118개 해결, Wilson 95% CI [25.24, 34.15] |
| ConceptARC pass@2 | 59.38% | semantic ID 기준 160 태스크 중 95개 해결, opaque ID 기준 96/160 = 60.00% |
| 태스크당 추론 비용 | 0.00070USD | 약 0.85 H200 GPU-초, H200 시간당 $3 가정. ARC Prize 2026 비용 기준 GPT 5.6 Luna (Low) 대비 약 57x 저렴, 2026-07-30 API 가격 인하 반영 시 약 11x 저렴 |
| 모델 파라미터 | 150M | 평가된 BDH-CQ 구성의 파라미터 수 |
어떻게 동작하나
BDH-CQ는 데모 D_t를 순차적으로 처리하며 재귀 기억 S_t = U_θ(S_{t-1}, D_t)를 갱신한다. 모든 데모를 읽은 뒤 질의 x와 최종 기억 S_K를 H_0 = E_θ(x, S_K)로 잠재 작업공간에 인코딩하고, H_{r+1} = F_θ(H_r, S_K)를 r=0,…,R-1 동안 반복해 답을 계산한 뒤 ŷ = G_θ(H_R)로 출력한다. 중간 추론 상태는 자연어로 디코딩하지 않는다. 학습에는 비공개 curated ARC-style 데이터와 ARC-AGI-1 training set, RE-ARC, ConceptARC, ARC-Heavy, ARC-GEN100K 및 추가 augmentation이 쓰였고, ARC-AGI-1 평가 태스크의 task identifier나 evaluation-task demonstration pair는 학습에 쓰지 않았다고 보고한다. 추론 시 파라미터 업데이트는 없으며, LOW/MEDIUM/HIGH reasoning effort로 반복 계산량과 비용-정확도 trade-off를 조절한다.
 ARC-AGI-1 점수 대비 태스크당 비용의 파레토 전선. BDH-CQ 150M의 29.5 pass@2, $0.00070 지점이 기존 leaderboard 비용-정확도 점들과 비교된다.
원문은 같은 비용 이하에서 이 정확도 이상을 달성한 plotted system이 없다고 보고하며, 이를 ARC-AGI-1 benchmark cost efficiency의 새 state of the art로 해석한다.
핵심 수식:
S_t = U_\theta(S_{t-1}, D_t) \quad\text{(1)}
H_0 = E_\theta(x^*, S_K) \quad\text{(2)}
H_{r+1} = F_\theta(H_r, S_K), \quad r = 0, \dots, R-1 \quad\text{(3)}
\hat{y} = G_\theta(H_R) \quad\text{(4)}
S_t는 t번째 데모까지 반영한 재귀 기억 상태이고, D_t는 t번째 데모 내용이다. H_r은 현재 질의를 풀기 위해 반복 갱신되는 잠재 작업공간이며, S_K는 K개 데모를 모두 흡수한 기억이다. θ는 추론 중 고정되고, ŷ는 최종 디코딩된 출력이다.
실험 결과
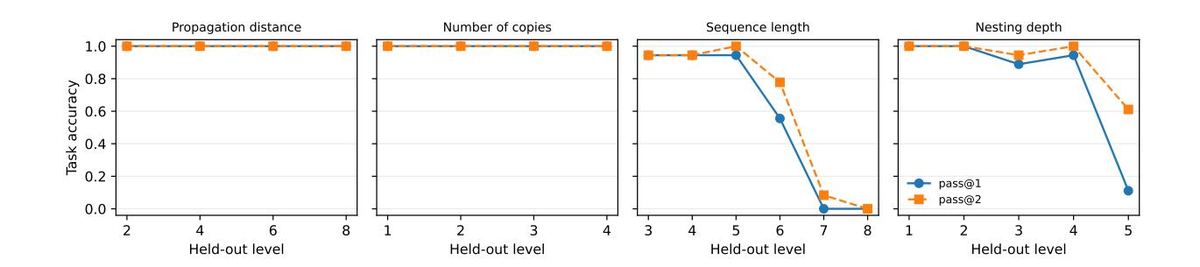 전파, 복사, 순서 정렬, 중첩 포함 관계의 통제 일반화 곡선. 각 family에서 거리·복사 수·순서 길이·중첩 깊이를 늘릴 때 exact held-out-output accuracy가 어떻게 변하는지 보여준다.
전파와 복사는 테스트 범위에서 48/48을 유지하지만, ordering은 길이 6에서 29/36, 길이 7에서 8/24, 길이 8에서 1/24 pass@2로 급락한다. nesting은 depth 5에서 29/36으로 낮아지지만 대부분 출력 구조는 유지된다.
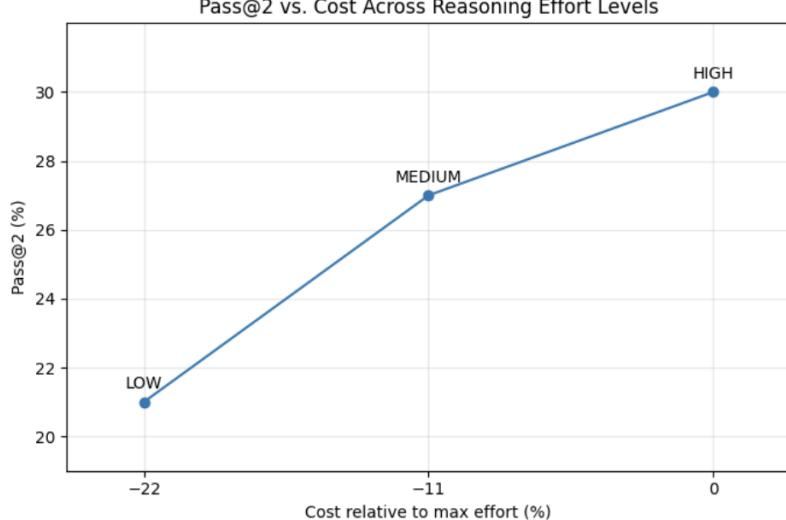 LOW/MEDIUM/HIGH latent reasoning effort에 따른 ARC-AGI-1 pass@2와 비용 변화.
Table 5 기준 HIGH는 29.5% pass@2와 0% cost reduction, MEDIUM은 27%와 11% cost reduction, LOW는 21%와 22% cost reduction이다. 더 많은 latent effort가 정확도를 높이지만 비용 절감은 줄어든다.
한계와 주의할 점
- 절대 정확도 한계: ARC-AGI-1 29.5% pass@2는 비용 효율 측면에서는 강하지만, 여전히 400개 중 282개 태스크는 실패한다.
- 재현성 한계: 전체 내부 update rule, 차원, 학습 objective 세부, 데이터 혼합 비율, 하이퍼파라미터는 proprietary로 남아 외부 재현이 어렵다.
- 도메인 한계: 실험은 ARC-like visual reasoning 중심이며 자연어, 수학, 도구 사용, 일반 멀티모달 추론으로의 확장은 outlook에 가깝다.
- 일관성 문제: ConceptARC semantic 조건에서 pair pass@2는 374/480 = 77.92%지만 strict task pass@2는 95/160 = 59.38%라 같은 태스크의 세 입력 전체에 규칙을 일관 적용하지 못하는 경우가 많다.
- 구조적 실패 모드 존재: 순서 길이 8, 미시연 파라미터 값, 세 패널 union, touching panel, 일부 composition에서 성능이 크게 무너진다.
- 독립 감사의 범위 한계: opaque identifier와 mixed batch replication은 request-side cue confound를 줄이지만, training exposure나 checkpoint selection을 배제하지는 못한다.
- 순서 구성 실패: controlled ordering은 길이 8에서 pass@2 1/24로 떨어지고, byte-identical supported context에서도 13/24까지만 회복된다.
- 보이지 않은 파라미터 값 실패: marker count로 shift를 지정하는 ladder에서 test value가 demonstrations에 없으면 interpolation/extrapolation 모두 0/120이며, demonstrated-value 조건도 12/40에 그친다.
- 다중 패널 분리 한계: panel union은 opposite-corner 2패널 26/40에서 3패널 1/40으로 떨어지고, touching 2패널도 3/40에 불과하다.
- 연산 조합 한계: relocation, reflection, rotation 단독은 각각 72/72지만 reflection+relocation은 47/72, color swap+relocation은 0/72다.
- 조건부 규칙 선택 한계: marker가 변하지만 같은 규칙을 쓰는 control은 40/40이나, 두 규칙 중 하나를 선택해야 하는 조건은 68/120 = 56.7%다.
시스템 적용 아이디어
논문의 기법을 비슷한 구조를 가진 시스템에 옮길 때의 적용 지점이다.
예시 기반 규칙 캐시로 반복 작업 비용 줄이기
논문의 핵심 근거는 S_t = U_θ(S_{t-1}, D_t) 형태로 예시를 순차 흡수하고, H_{r+1} = F_θ(H_r, S_K)로 질의를 반복 계산한다는 구조다. 실제 에이전트나 자동화 시스템에서는 매번 긴 설명을 다시 프롬프트에 넣기보다, 대표 입출력 예시를 작업 규칙으로 제공하고 짧은 답만 받는 설계를 시험할 수 있다. 단, 논문은 ARC-like 격자에서 검증했으므로 일반 도구 결과 압축 성능은 별도 평가가 필요하다.
적용 지점 — 반복적인 예시 기반 변환 작업
기대 효과 — 원문에서 직접 확인된 정량 근거는 ARC-AGI-1 29.5% pass@2 at $0.00070/task 및 dense mapping 96/96이다. 장기 에이전트 기억 비용 절감 수치는 논문에 직접 보고되지 않았다.
난이도별 latent effort 스위칭
Table 5는 같은 계열 모델에서 reasoning effort가 높을수록 pass@2가 증가함을 보여준다. HIGH는 29.5%, MEDIUM은 27%, LOW는 21%이며, cost reduction은 각각 0%, 11%, 22%다. 운영 환경에서는 confidence나 task family를 기준으로 effort를 선택하는 정책을 만들 수 있지만, paper 자체는 자동 스위칭 정책을 검증하지 않았다.
적용 지점 — 비용 민감 추론 라우팅
기대 효과 — 논문 근거 범위에서는 LOW가 HIGH 대비 22% 비용 절감과 8.5pp 낮은 pass@2, MEDIUM이 11% 비용 절감과 2.5pp 낮은 pass@2를 보인다.
도메인별 실패 ladder를 먼저 만드는 평가 방식
논문은 ConceptARC aggregate만으로는 부족하다고 보고, controlled ARC-like intervention으로 어떤 구조에서 성능이 무너지는지 분리했다. 제품 적용 전에도 도메인 문제를 이와 비슷한 ladder로 쪼개면 모델이 잘하는 변환과 위험한 변환을 빠르게 구분할 수 있다.
적용 지점 — 모델 도입 전 QA·벤치마크 설계
기대 효과 — 논문에서 확인된 대표 차이는 panel union 65.0%→2.5%, conditional selection 100.0%→56.7%, absent parameter 30.0%→0.0%, support chain 80.0%→27.5%다.
규칙 일관성 점검을 pair accuracy와 task accuracy로 분리
ConceptARC에서 semantic pair pass@2는 374/480 = 77.92%였지만 strict task pass@2는 95/160 = 59.38%였다. 이 차이는 모델이 일부 입력은 맞혀도 같은 규칙을 태스크 전체에 안정적으로 적용하지 못할 수 있음을 보여준다. 따라서 실제 배포 평가에서도 개별 케이스 정확도와 묶음 단위 성공률을 별도 지표로 둬야 한다.
적용 지점 — 예시 기반 자동화의 신뢰성 평가
기대 효과 — 논문 근거 수치는 18.5 percentage point의 pair-task gap이며, 52/160 tasks가 하나 또는 두 개 test input만 맞힌 partial success였다.
단계별 도입 로드맵
| 단계 | 목표 | 액션 | 기대 효과 |
|---|---|---|---|
| Phase 1 | ARC-like 단일 도메인 파일럿 검증 | 목표 변환 family를 정하고 예시-질의 세트를 구축한다. pass@1, pass@2, strict task accuracy, pair accuracy, 태스크당 실제 비용을 원문 프로토콜과 분리해 측정한다. | 논문 수치가 실제 사용 도메인의 변환 분포에서도 유지되는지 확인하고, 실패 family를 조기에 제거한다. |
| Phase 2 | 실패 모드 중심 평가 확장 | ordering length, unseen parameter, panel separation, conditional rule selection, operation composition을 포함한 ladder test를 도메인별로 만든다. LOW/MEDIUM/HIGH effort별 정확도와 비용도 함께 기록한다. | 단일 평균 점수 대신 어떤 구조에서 모델을 믿을 수 있는지 운영 경계를 정한다. |
| Phase 3 | 다른 추론 형식으로 확장 검증 | 언어 지시, 수식 변환, constraint satisfaction, tool-use demonstration으로 입력 양식을 넓히고 ARC-like 결과와 별도 benchmark를 구축한다. | 논문의 visual ARC 결과가 broader reasoning system으로 확장 가능한지 검증한다. |
원문 PDF: 2026-08-12-bdh-cq-in-context-learning-with-recurrent-latent-reasoning.pdf