개요
바이두가 6월 24일 Unlimited OCR을 공개했습니다. 이름은 좀 과해 보입니다. 그래도 핵심 아이디어 하나는 또렷합니다. 출력이 아무리 길어져도 KV 캐시가 늘지 않는다는 점입니다. 모델 자체는 총 3B 파라미터의 MoE이고, 추론할 때 실제로 도는 전문가는 500M뿐입니다. DeepSeek OCR을 처음부터 다시 짠 게 아니라, 그 체크포인트에서 디코더만 갈아 끼우고 이어 학습한 결과물입니다. 라이선스도 MIT라 가중치를 그대로 가져다 써도 됩니다.
OmniDocBench v1.5 기준 93.23점. 기존 DeepSeek OCR 대비 +6.22점입니다. 점수보다 흥미로운 건 동작 방식 쪽인데, 책 한 권을 통째로 한 번에 파싱할 수 있다는 점이 그렇습니다.
핵심 요약
- 모델: 3B MoE, 활성 파라미터 500M. 디코더만 학습, DeepEncoder는 그대로 사용.
- 새 어텐션: R-SWA(Reference Sliding Window Attention). 디코더 KV 캐시를 상수로 묶음.
- 벤치마크: OmniDocBench v1.5 93.23(DeepSeek OCR 87.01 대비 +6.22), v1.6 93.92.
- 속도: Base 모드 5,580 TPS로 DeepSeek OCR 4,951 TPS 대비 12.7% 빠름. 출력이 6,000 토큰까지 길어지면 격차 35%.
- 학습: DeepSeek OCR 체크포인트에서 4,000 스텝 이어 학습. 8×16 A800 GPU, 약 200만 문서.
- 컨텍스트: 최대 32K 토큰. 40페이지 넘는 책을 한 번의 forward pass로 처리하며 edit distance 0.11 이하.
- 라이선스: MIT, 가중치·코드 공개.
R-SWA — 캐시를 상수로 묶는 방법
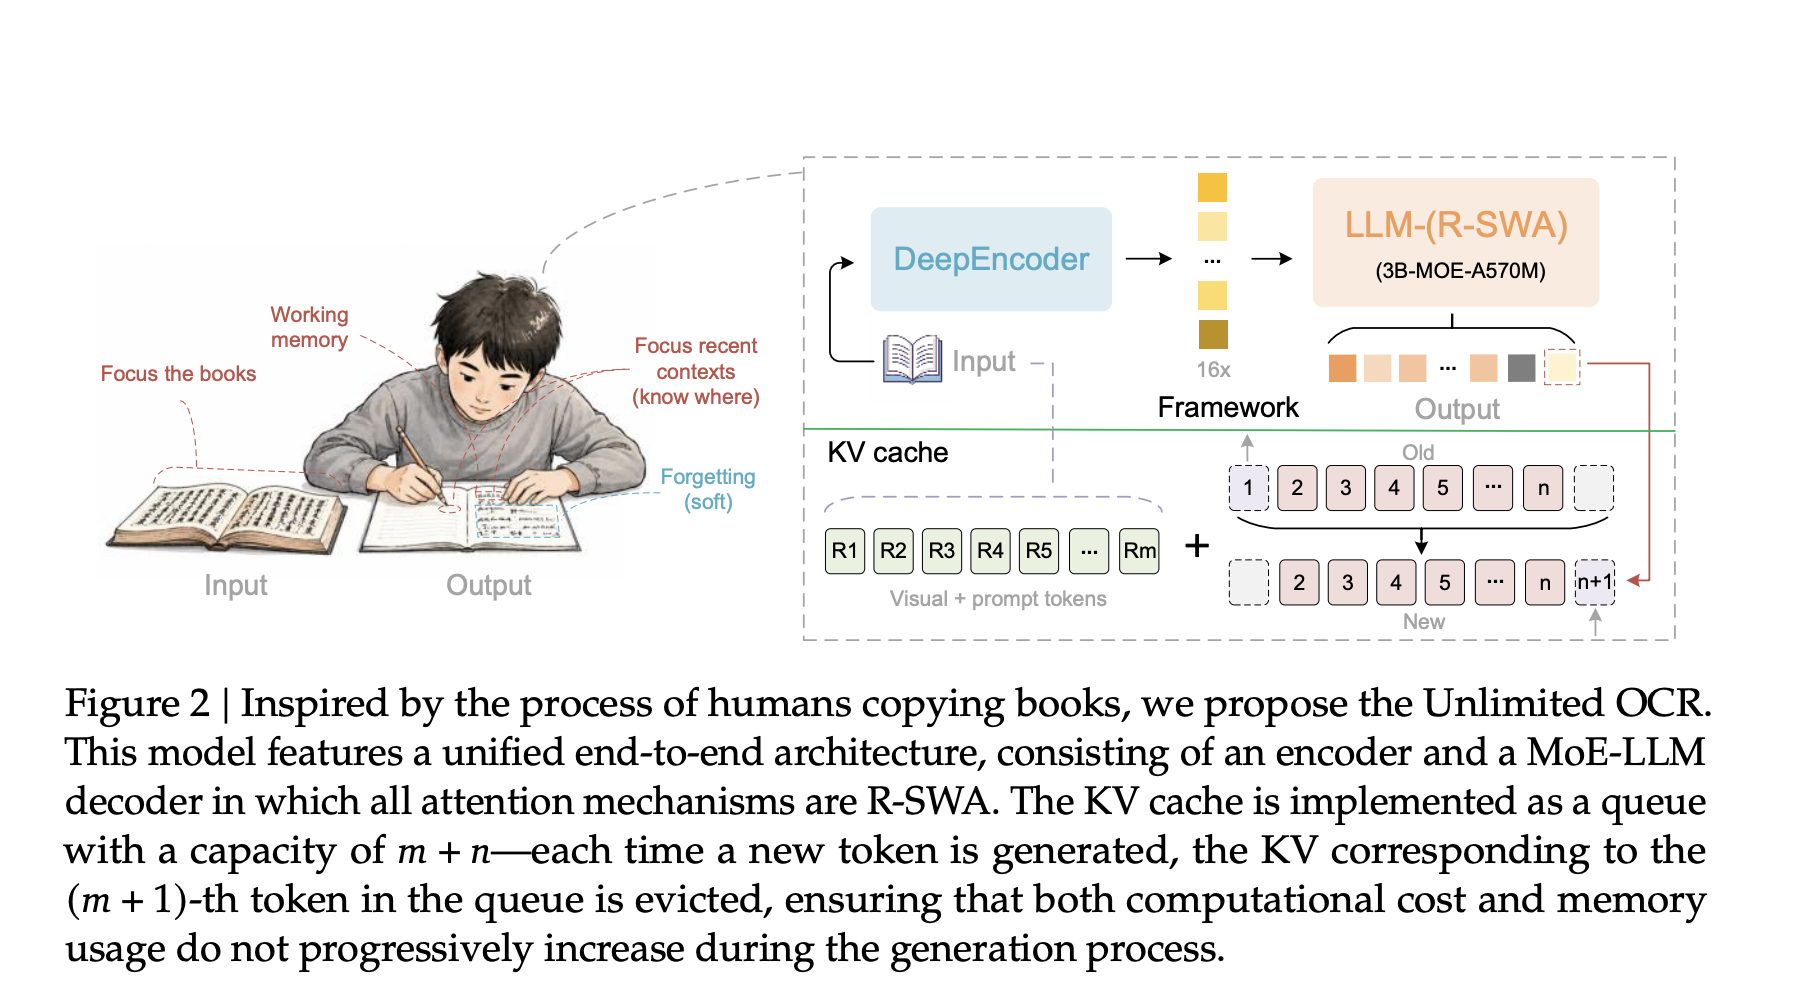
기존 디코더의 문제는 단순합니다. 토큰 하나를 만들 때마다 KV 캐시에 키와 값을 하나씩 더 쌓습니다. 출력 길이를 T라고 하면 캐시 크기는 Lm + T로 늘어납니다. 페이지가 늘수록 메모리가 같이 부풀고, 토큰당 지연도 같이 늘죠. 책 한 권을 통으로 파싱하려고 하면 이 부분이 그대로 한계가 됩니다.
바이두가 내놓은 답은 참조 토큰과 출력 토큰을 분리해서 다르게 다루는 것입니다.
- 참조 토큰(이미지에서 뽑은 비전 토큰 + 프롬프트): 모든 출력 토큰이 끝까지 다 본다. 상태도 업데이트하지 않음.
- 출력 토큰: 자기 직전 n개(기본값 128개)까지만 본다. 그보다 오래된 출력 토큰은 캐시에서 버린다.
이렇게 하면 캐시 크기가 Lm + min(n, T), 즉 출력이 아무리 길어져도 Lm + n에서 멈춥니다. 출력을 1만 토큰 뽑든 10만 토큰 뽑든 같은 메모리에서 돌아갑니다.
연구진은 이 동작을 “사람이 책을 베껴 쓸 때"에 비유합니다. 원문은 계속 보고, 방금 쓴 몇 줄만 곁눈질하지, 이미 옮긴 페이지를 매번 다시 읽지 않는다고요. 직관적이고 설득력 있는 비유입니다. 그리고 참조 토큰의 상태를 안 건드리기 때문에, 선형 어텐션 류에서 흔히 나오던 누적 흐려짐(progressive blurring) 문제도 피해 갑니다.
어떻게 만들었나
밑바탕은 DeepSeek OCR입니다. DeepEncoder(SAM-ViT + CLIP-ViT를 묶은 압축형 인코더)와 MoE 디코더 구조는 그대로 가져왔습니다. DeepEncoder는 1024×1024 PDF 이미지를 16배 압축해 256개 비전 토큰으로 만들어 줍니다. 입력 측 토큰이 적으니 프리필도 가볍습니다.
학습은 처음부터가 아니라 이어 학습입니다.
- DeepSeek OCR 체크포인트에서 출발.
- DeepEncoder는 동결, 디코더만 학습.
- 약 200만 문서 샘플. 단일 페이지와 멀티 페이지 비율은 9 대 1, 멀티 페이지는 단일 페이지를 이어 붙여 만들었습니다.
- 8×16 A800 GPU에서 4,000 스텝.
짧은 학습 일정으로 SOTA에 올라간 비결은 결국 R-SWA가 멀티 페이지에서 캐시 압박을 풀어 준 덕이 큽니다. 디코더 입장에서 보면 캐시가 안 늘어나니 멀티 페이지 샘플도 단일 페이지처럼 가볍게 돌아갑니다.
벤치마크
OmniDocBench v1.5 핵심 지표만 정리하면 이렇습니다.
| 항목(v1.5) | DeepSeek-OCR | DeepSeek-OCR 2 | Unlimited-OCR |
|---|---|---|---|
| 종합 ↑ | 87.01 | 89.17 | 93.23 |
| Text Edit ↓ | 0.073 | 0.049 | 0.038 |
| Formula CDM ↑ | 83.37 | 86.85 | 92.61 |
| Table TEDS ↑ | 84.97 | 85.60 | 90.93 |
| Read-order Edit ↓ | 0.086 | 0.060 | 0.045 |
수식(Formula CDM)과 표(Table TEDS)에서 폭이 두드러집니다. 표 인식이 90.93까지 올라온 건 실무 입장에서 꽤 묵직한 숫자고요. 읽는 순서(read-order) 오차도 절반 가까이 줄었습니다.
속도도 같이 좋아졌습니다. Base 모드에서 5,580 TPS, DeepSeek OCR이 4,951 TPS이니 약 12.7% 빠릅니다. 더 흥미로운 건 출력 길이를 키울 때입니다. 6,000 토큰 출력 기준에서는 차이가 35%까지 벌어집니다. 캐시가 상수로 묶여 있으니 길어질수록 격차가 더 나는 것이고, 이 그래프가 사실상 R-SWA의 가장 강력한 광고입니다.
40페이지가 넘는 분량을 한 번에 넣고 돌렸을 때도 **edit distance 0.11 이하, Distinct-35 96.90%**를 유지합니다.
실무자가 볼 핵심 포인트
- 장문 처리: 책 한 권을 페이지 단위로 쪼개지 않고 한 번에 넣는 파이프라인을 짤 수 있습니다. 페이지 경계에서 끊겨 표나 수식이 깨지는 사고가 줄어듭니다.
- 메모리 예측 가능: 출력 길이와 무관하게 메모리가 거의 일정해서, GPU 한 장에 몇 개 워커를 띄울지 산정하기 편합니다.
- 두 가지 해상도 모드: 멀티 페이지는 Base(1024×1024), 단일 페이지는 Gundam(가변 해상도). 본문 글씨가 잘게 보이는 문서를 다룬다면 Gundam 모드를 단일 페이지 단위로 돌리는 편이 안전합니다.
- 추론 스택: Transformers 코드는
trust_remote_code=True, BF16, CUDA가 필요합니다. 대량 처리 시 SGLang을 띄우고fa3어텐션 백엔드로 OpenAI 호환 API를 받을 수 있습니다. - 남는 한계: ‘무제한’이지만 입력 측은 여전히 32K가 천장입니다. 페이지가 쌓이면 프리필 비용은 압축 후에도 천천히 늡니다. 멀티 페이지를 Gundam으로는 못 돌리니, 폰트가 아주 작은 스캔본은 단일 페이지 분할이 안전한 선택이고요.
- 확장 가능성: 저자들은 R-SWA가 OCR 전용 트릭이 아니라 음성 인식·번역에도 그대로 옮길 수 있는 일반적인 파싱 어텐션이라고 적었습니다. 다만 이건 아직 실험 결과로 나온 건 아니고 향후 과제입니다.
정리
정리하면 한 줄입니다. “비전 토큰은 끝까지 다 보고, 출력 토큰은 직전 128개만 본다.” 이 단순한 변경 하나가 메모리 곡선을 평탄하게 다듬어 주고, OmniDocBench 점수까지 같이 끌어올렸습니다. 책 한 권 단위로 OCR을 돌리는 팀이라면 자기 데이터로 한 번쯤 돌려 볼 가치가 충분합니다. 가중치도 코드도 MIT이니 진입 장벽이랄 게 사실상 없습니다.