AI 모델의 사용 설명서(모델 카드)를 LLM이 자동으로 정리하거나 처음부터 새로 써주는 두 가지 방법을 제안한 논문이다.
무엇이 문제였나 — 공개된 AI 모델들이 사용하는 설명서(모델 카드)가 양식도 제각각이고 아예 없는 경우도 많아, 어떤 모델을 어떻게 써야 안전한지 비교하기 어려웠다. 어떻게 풀었나 — 기존 모델 카드를 표준 양식으로 자동 재배치하는 MCTidy와, 저장소 파일·논문만 읽고 새 모델 카드를 자동 생성하는 MCGenie 두 시스템을 만들었다. 그래서 뭐가 좋아졌나 — 48개 모델 평가에서 정보 손실은 4.5% 수준으로 미미했고, 섹션 배치는 98.1% 정확했고, 자동 생성 카드의 절반 이상은 사실 오류가 없는 완성형으로 나왔다.
도서관에서 책마다 규격화된 도서 카드를 사서들이 손으로 적던 일을, AI가 책 본문과 출판사 정보를 읽고 자동으로 카드를 발급해주는 시스템과 비슷하다. 이미 있는 카드를 표준 양식으로 다듬는 서비스(MCTidy)와, 책 정보만으로 카드를 처음부터 만드는 서비스(MCGenie) 두 가지를 동시에 제공한다. 단, 내용이 부족할 때는 ‘정보 부족’이라고 솔직히 적도록 강제해 지어내기를 막았다.
논문 정보
Tajkia Rahman Toma, Balreet Grewal, Cor-Paul Bezemer · University of Alberta, Canada · Manuscript submitted to ACM · 2026
왜 중요한가
AI 모델이 의료·금융·사법 같은 민감한 분야에 투입되면서, 어떤 모델이 어디에 안전하게 쓰일 수 있는지를 정리한 표준 문서가 점점 더 중요해지고 있다. 그런데 그 문서를 사람이 손으로 쓰면 시간이 너무 많이 걸려서 대부분의 모델이 설명이 빈약하거나 아예 없다. 이 작업을 자동화하면 더 많은 모델이 적절한 사용 가이드와 함께 배포될 수 있어 사회적 안전성이 높아진다.
핵심 지표
| 지표 | 값 | 설명 |
|---|---|---|
| MCTidy 정보 유지율 | 93.8% | 원본 모델 카드의 체크리스트 항목 중 재배치 후에도 보존된 비율(중앙값, 체크리스트 중앙값 69개 항목) |
| MCTidy 섹션 배치 정확도 | 98.1% | 1,440개 (하위)섹션 중 올바른 섹션에 배치된 비율(1.9%만 오배치) |
| MCTidy 실행 간 의미 일치도 | 0.97 | 동일 입력으로 3회 실행 시 문서 단위 코사인 유사도 중앙값 |
| MCTidy 0.90 이상 섹션 의미 일치 비율 | 87.5% | 3회 실행 비교에서 개별 (하위)섹션 의미 유사도가 0.90 이상인 비율 |
어떻게 동작하나
두 시스템 모두 Mitchell et al.의 모델 카드 표준 템플릿(11개 섹션, 일부 하위 섹션 포함)을 사용한다. MCTidy는 gemini-2.0-flash-thinking-exp-01-21(temperature=0)에게 원본 모델 카드와 템플릿을 함께 주고 ‘내용을 그대로 옮기기만 하라’고 지시해 재배치한다. MCGenie는 gemini-2.5-pro(temperature=0)에게 모델 저장소 파일 목록과 PDF 논문을 주고 ‘출처 인용을 달아 새 카드를 작성하라’고 지시하며, 정보가 부족하면 ‘Insufficient information’으로 명시하도록 강제한다. 정보 유지율 평가는 원본 카드를 gpt-4o-mini-2024-07-18로 원자 정보 단위 체크리스트(중앙값 69개 항목)로 분해한 뒤 누락·추가 항목을 저자 2명이 3라운드에 걸쳐 수동 검증하는 방식이다. 섹션 배치 정확도는 Gemini 2.5 Pro·OpenAI o4-mini·DeepSeek R1로 구성된 LLM jury의 다수결로 판정하고, 저자 2명이 최종 확인했다. 생성 카드의 사실성은 Gemini 2.5 Pro·Claude Sonnet 4.5·GPT-5로 구성된 LLM jury의 다수결로 판정했다.
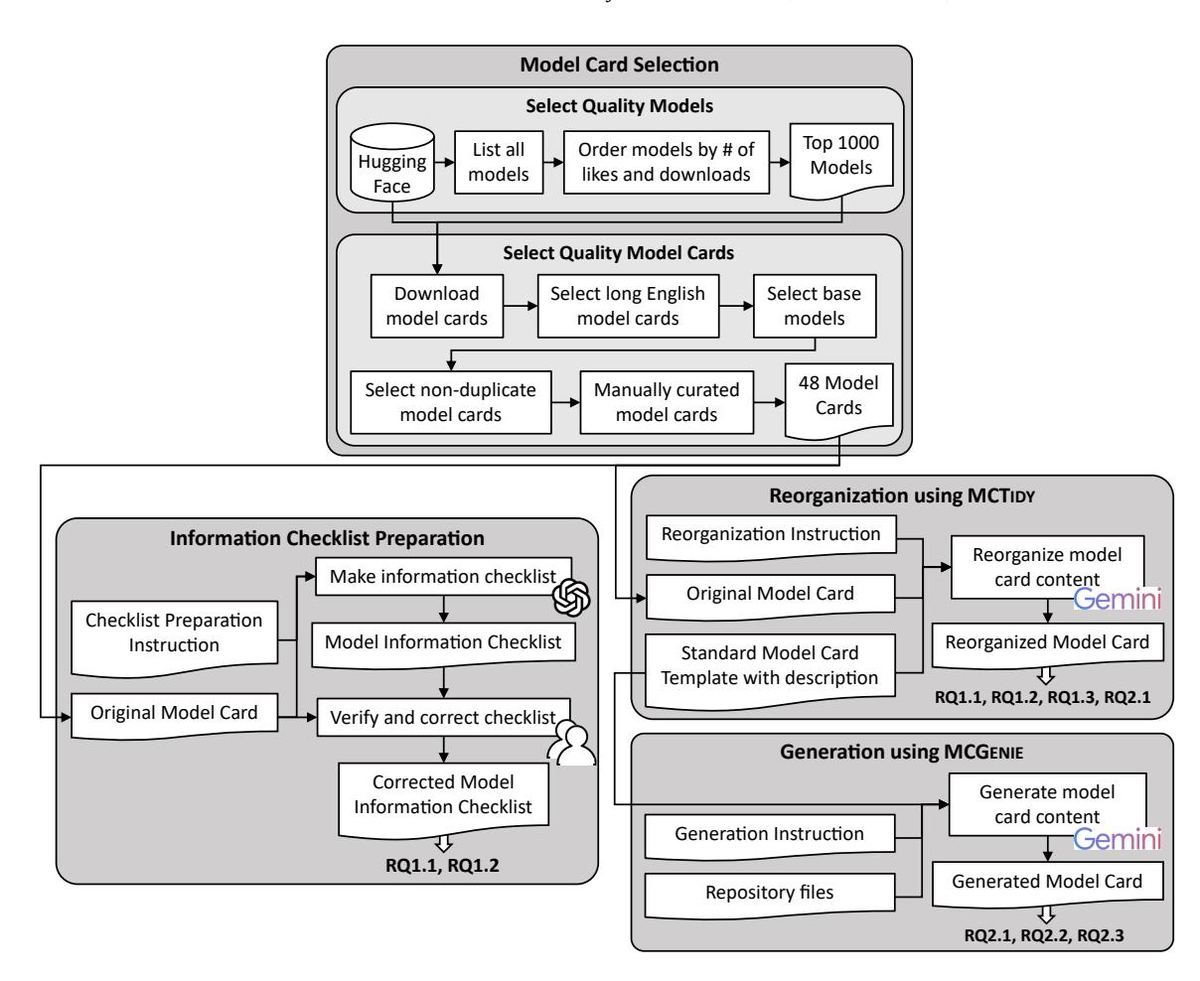
 전체 연구 파이프라인: 944,178개 후보 → 다단계 필터링 → 48개 베이스 모델 선정 → MCTidy 재배치 → MCGenie 생성 → 평가
두 시스템(MCTidy·MCGenie)이 같은 48개 모델과 동일한 템플릿을 공유해, 재배치 결과가 생성의 정답(ground truth)으로도 사용되는 점이 핵심 설계다.
핵심 수식:
\mathrm{sim}(A, B) = \frac{A \cdot B}{\|A\| \, \|B\|}
A와 B는 allenai/specter 임베딩 모델로 생성한 문장/문서 임베딩 벡터. 코사인 유사도가 1에 가까울수록 두 텍스트의 의미가 동일함을 뜻한다. 논문은 문서 수준 및 (하위)섹션 수준 의미 일치를 측정하는 데 이 값을 사용했다.
한계와 주의할 점
- 내부 validity: 1, 2저자 수동 검증은 해석에 따라 달라질 수 있는 주관적 판단을 포함한다.
- 구성 validity: HF 허브의 상위 0.1%(944,178개 중 1,000개)만 골라 평가해, 잘 관리된 모델 카드로만 검증되었다 — 일반 모델에 대한 일반화는 검증되지 않았다.
- 토큰 한계: 48개 저장소 중 22개는 tokenizer.json 등을 요약해야 했고, 4개(openai/whisper-large-v3, Qwen/Qwen2-VL-7B-Instruct, Tencent-Hunyuan/HunyuanDiT, ctheodoris/Geneformer)는 더 큰 파일을 제거해야만 생성이 가능했다.
- LLM jury 한계: MCTidy 섹션 배치 평가에서 심사 LLM과 사람 평가자가 10건 의견을 달리했고, LLM이 섹션 설명을 문자 그대로 강하게 적용해 유연성이 떨어지는 경향이 관찰되었다.
- 저장소 내 정보 충돌: 같은 모델의 README·config·논문 간 수치가 서로 다른 경우(예: whisper-large-v3의 mel-bin 수치) MCGenie가 잘못된 출처를 인용하는 사례가 보고되었다.
- 기술적·서술적(descriptive) 섹션에서 환각 집중: Primary Intended Users(15/48, 31.2%)와 Ethical Considerations에서 ‘연구자·개발자·사업가·교육자’ 같은 막연한 사용자 목록을 추론해 덧붙임.
- 인용-내용 불일치: 사실 오류 사례의 약 60%가 카드 내용과 인용된 파일의 수치·사실이 다른 경우(openai/whisper-large-v3, bigscience/bloom 등).
- 출처 간 충돌 시 잘못된 출처 인용: 같은 정보가 두 파일에서 다르게 보고될 때, LLM이 검증되지 않은 출처를 인용해 투명성을 훼손.
- 큰 노트북·vocab.json 보유 모델은 입력을 줄이기 위해 일부 파일을 제거해야 해서 정보 손실이 불가피(Geneformer 등).
시스템 적용 아이디어
논문의 기법을 비슷한 구조를 가진 시스템에 옮길 때의 적용 지점이다.
에이전트 장기 기억 회수 검증을 위한 원자 체크리스트 도입
논문의 Section 2.2(체크리스트 준비) 기법이다. 장기 기억을 다루는 에이전트라면, 인덱싱 직후 문서를 GPT-4o-mini급 모델로 ‘하나의 사실 = 한 문장’ 형태의 체크리스트로 분해해 저장한다. 회수 시점이 되면 체크리스트 항목별로 검색 결과에 포함됐는지 자동 채점해 재현율을 측정한다. 논문은 이 방식의 정규화 Levenshtein 거리 0.03을 달성해 분해 품질이 충분함을 보였다. 이 수치를 RAG 회수의 정량 KPI로 그대로 활용할 수 있다.
적용 지점 — 에이전트 장기 기억 회수(RAG 재현율 검증 단계)
기대 효과 — 체크리스트 분해 품질 0.03의 낮은 편집 거리 — RAG 재현율 측정이 가능해져 검색 품질을 정량적으로 추적 가능.
에이전트 출력 자기검증을 위한 LLM jury 게이트
논문의 Section 3.1(RQ1.1 섹션 배치)과 Section 4.2(RQ2.2 사실성)에서 사용한 LLM jury 패턴이다. 다양한 LLM(Gemini 2.5 Pro·Claude Sonnet 4.5·GPT-5 등 상위 모델)을 심사자로 두고, 각 (하위)섹션 단위로 ‘이 정보가 출처 파일에 근거하는가?‘를 다수결로 판정한다. 논문은 26/48(54.17%) 생성 카드에서 오류가 0건임을 LLM jury로 입증했다. 에이전트라면 답변을 사용자에게 전달하기 직전, ‘근거 인용 일관성’ 단일 검증 질문에 다수결을 적용해 자기검증 게이트를 통과하지 못하면 사람 검토 큐로 보내는 식으로 응용할 수 있다.
적용 지점 — 에이전트 답변 직전 자기검증 단계(종료 조건 게이트)
기대 효과 — 48개 카드 중 26개를 무오류로 판정한 안정적 검증 — 에이전트 응답의 사실성 자동 필터링에 즉시 활용 가능.
RAG 컨텍스트 우선순위화를 위한 자원별 ablation
논문의 Section 4.3(RQ2.3) 메커니즘이다. MCGenie는 논문 제외 시 문서 유사도 중앙값이 1.0 → 0.91로 떨어지고, config·tokenizer 제외 시에는 0.95~0.96으로 유지됐다. 즉 ‘논문은 필수, config·tokenizer는 보조’라는 자원별 기여도가 정량적으로 드러났다. RAG 검색 파이프라인이라면 토큰 예산이 한정된 에이전트에서, 모든 후보 문서를 ablation 점수로 정렬해 상위 N개만 컨텍스트에 투입하는 자원 선택 정책으로 직접 이식할 수 있다. 논문 PDF가 있으면 우선순위 1순위로 두는 식이다.
적용 지점 — RAG 검색 파이프라인의 컨텍스트 자원 선택 단계
기대 효과 — 논문 제외 시 0.91, config 제외 시 0.95 — 자원별 기여도를 정량 비교해 컨텍스트 구성 비용을 최적화.
도구 응답 불충분 시 환각 억제 프롬프트 패턴
논문의 Listing 3(생성용 시스템 프롬프트)는 ‘정보가 부족하면 Insufficient information을 적으라’고 명시적으로 강제한다. 이 규칙이 실제로 작동해 Citation details 섹션은 100% 빈 상태로 채워지는 대신 환각이 거의 발생하지 않았다. 장기 기억을 쓰는 에이전트라면, 도구 호출 결과가 짧거나 핵심 필드가 비어 있을 때 ‘I don’t have enough information to answer this’로 응답하도록 시스템 프롬프트에 박는 패턴을 그대로 가져온다. 이 한 줄 규칙이 환각의 가장 큰 원인인 ‘없는 정보 그럴듯하게 메우기’를 사전에 차단한다.
적용 지점 — 에이전트 도구 호출 결과가 불충분할 때의 응답 정책(시스템 프롬프트)
기대 효과 — Citation details 100% 빈 채로 두면서 환각 거의 0% — 명시적 ‘모름’ 라벨이 추론성 환각을 구조적으로 억제.
단계별 도입 로드맵
| 단계 | 목표 | 액션 | 기대 효과 |
|---|---|---|---|
| Phase 1 | MCTidy를 자사 모델 카탈로그에 파일럿 적용 | Gemini 2.0 Flash Thinking을 temperature=0으로 세팅해 기존 README를 Mitchell 템플릿으로 재배치. 체크리스트 기반 누락 검증 자동화. Primary Intended Users·Ethical Considerations 섹션에 한정해 수동 검수. | 48개 평가 기준 93.8% 정보 유지, 1.9% 오배치 수준을 달성. 문서 표준화 비용 즉각 절감. |
| Phase 2 | MCGenie로 미문서화 모델의 카드 자동 생성 | 모델 저장소에서 README를 제거한 뒤 Gemini 2.5 Pro에 config.json·tokenizer.json 요약본·연관 PDF를 함께 제공. 출처 인용을 강제하는 시스템 프롬프트를 적용. LLM jury(Gemini 2.5 Pro·Claude Sonnet 4.5·GPT-5) 다수결로 사실성 자동 검증. | 54.17%는 무오류 카드, 나머지는 중앙 1섹션 오류 수준 — 사람 검수를 최소화하면서 문서 커버리지를 확대. |
| Phase 3 | 자기검증·반복 개선 루프 고도화 | 1) 추가 정보 섹션으로 분류된 콘텐츠를 표준 섹션으로 재배치하도록 2차 프롬프트를 자동 트리거, 2) 출처 간 충돌 감지 시 사람 검토 큐로 자동 라우팅, 3) 입력 자원별 ablation 점수를 비용 함수에 반영해 핵심 파일(논문) 우선, 보조 파일은 요약본만 투입. | 논문 제외 시 0.91로 떨어지는 현상을 방지하고, 토큰 비용 최적화 + 환각률을 추가 절감. |
원문 PDF: 2026-08-27-automatic-model-card-generation-using-an-llm.pdf