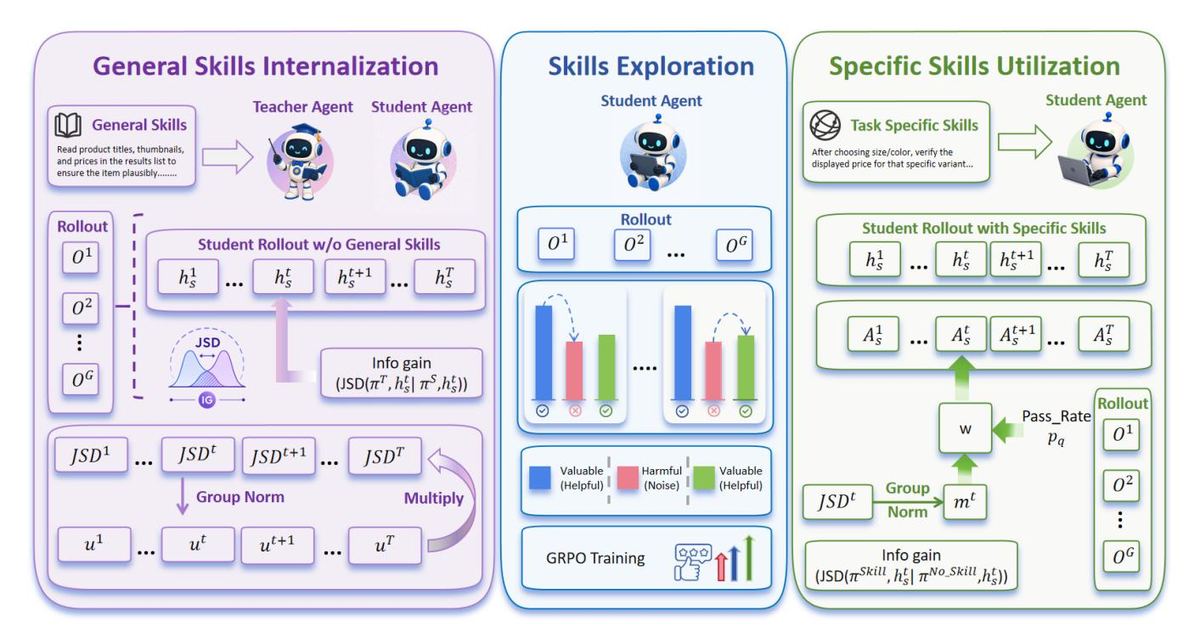
AUSO는 인공지능 에이전트가 ‘지금 이 힌트가 내 다음 행동을 진짜로 바꾸고 있나?‘를 매 순간 따져 보고, 정말 도움이 된 행동만 더 강하게 익히게 하는 훈련법이다.
무엇이 문제였나 — 기존 방법은 문제 전체가 성공했는지 실패했는지만 보고, 힌트를 외우는 단계와 힌트를 쓰는 단계를 단순히 갈랐다. 같은 과정 안의 모든 행동이 똑같은 대우를 받아서, 쓸데없는 행동까지 강해질 수 있었다. 어떻게 풀었나 — AUSO는 힌트를 넣었을 때와 뺐을 때 에이전트가 고르는 다음 행동이 얼마나 달라지는지를 수학적으로 잰 뒤, 힌트에 민감한 행동과 둔감한 행동을 구분한다. 민감한 행동은 더 크게 배우고, 방해가 되는 행동은 억제한다. 그래서 뭐가 좋아졌나 — 그 결과, 훈련 때 봤던 문제에서는 성능을 유지하면서 처음 보는 문제에서도 더 높은 성공률을 보였고, 필요 없는 행동이 줄어 한 문제를 끝내는 데 걸리는 단계 수도 짧아졌다.
수학 문제를 풀 때 선생님이 ‘이 힌트가 어디에서 진짜 도움이 됐는지’를 매 단계 표시해 주는 것과 같다. 시험 최종 점수만 보는 것과 달리, 한 단계씩 어떤 힌트가 효과적이었는지 따로 기억해 둔다. 그래서 처음 보는 유형의 문제에도 들고 있던 힌트 중 진짜 유용한 것만 골라 쓸 수 있다.
논문 정보
Huizu Lin*, Chengkai Huang*, Tianqi Gao, Tao Huang†, Daijiao Liu, Tongxin Li, Xiaoyan Sun, Lina Yao · USTC · UNSW · Independent Researcher · UCAS · Xi’an Jiaotong-Liverpool University · arXiv preprint · 2026
왜 중요한가
긴 호라이즌을 가진 에이전트는 ‘지금 이 한 행동’이 잘했는지 알아야 더 똑똑해지는데, 환경은 보통 마지막 결과만 알려준다. AUSO는 그 한 행동 단위의 학습 신호를 안정적으로 뽑아내는 방법을 제시했고, 검색, 쇼핑, 가정 로봇 등 다양한 에이전트에 적용할 수 있는 일반 도구다.
핵심 지표
| 지표 | 값 | 설명 |
|---|---|---|
| WebShop OOD 평균 성공률 | 51.2% | Skill0.5(40.6) 대비 +10.6p (논문 Table 1) |
| WebShop ID 평균 성공률 | 49.7% | Skill0.5(40.4) 대비 +9.3p (논문 Table 1) |
| ALFWorld OOD 평균 성공률 | 67.9% | Skill0.5(58.5) 대비 +9.4p (논문 Table 1) |
| ALFWorld ID 평균 성공률 | 94.3% | Skill0.5(93.1) 대비 +1.2p (논문 Table 1) |
어떻게 동작하나
AUSO는 GRPO를 단일 최적화 백본으로 유지하면서, 스킬 정보가 정책에 끼치는 영향을 ‘행동 분포 단위 JSD’로 통일해 측정한다. 초기 단계에서는 teacher(skill-conditioned)와 student(skill-free) 간의 JSD를 손실로 직접 사용해 일반 스킬을 모델에 흡수시키되, 해당 과제의 rollout 성공률 p_q가 0인 그룹에서만 활성화한다. 중간 단계에서는 보상 신호만으로 자가 탐색을 진행해 정책을 안정화하고, 후반 단계에서는 같은 상태를 skill-context 유무 두 번 평가해 얻은 JSD를 ‘uncertainty gate’로 걸러낸 뒤, 행동별 advantage에 곱해 스킬에 진짜 민감한 행동만 강화·억제한다. 세 단계의 시간 비중(2:5:3)은 Table 4 ablation으로 검증된 Internalize:Explore:Utilize 비율이며, α(s)와 β(s) 스케줄로 부드럽게 전이된다.
 AUSO의 3단계 파이프라인 — General Skills Internalization → Skills Exploration(GRPO) → Specific Skill Utilization — 전체 구조 요약도
스킬 정보가 teacher-guided 손실에서 action-level reweighting으로 점진 전환되는 흐름이 한 그림에 압축되어 있다.
핵심 수식:
L_AUSO(θ; s) = L_GRPO(θ; A_{q,i}^{GRPO}[1 + β(s)·4·p_q(1 − p_q)·m_{q,i}]) + λ_0 α(s) Σ_q I[p_q = 0] L_JSD^{(q)}
where w_{q,i} = 1 + β(s)·4·p_q(1 − p_q)·m_{q,i},
m_{q,i} = tanh(clip((I_{q,i} − μ_q^I)/√(σ_{q,I}² + ε), −3, 3)),
g(p_q) = 4·p_q(1 − p_q) (K = 4)
A_{q,i}^{GRPO}는 그룹 내 rollout i의 표준화된 GRPO advantage. g(p_q)=4·p_q(1−p_q)는 rollout 성공률 p_q의 베르누이 분산으로, 0.5 부근에서 최대가 되어 성공/실패 반반일 때만 강한 신호를 준다. m_{q,i}는 동일 과제 q 내에서 행동별 JSD(I_{q,i})를 정규화·경계로 묶은 값. β(s)와 α(s)는 각각 활용 단계와 내부화 단계의 시간에 따른 스케줄. 결국 행동별 advantage는 ‘환경 보상 × 스킬 민감도 × 데이터 신뢰도’로 재가중된다.
한계와 주의할 점
- 베이스 모델이 Qwen2.5-7B-Instruct 하나로 고정되어 있어, 더 큰 모델(70B+)이나 다른 계열(Llama, Claude)에서의 일반화는 검증되지 않았다.
- 모든 rollout이 실패한 그룹에서만 JSD 손실을 켜는 I[p_q=0] 조건은 ‘중간 난이도’ 작업에서 supervision이 일시적으로 비는 사각지대를 만들 수 있다.
- 스킬 뱅크를 훈련 중 고정(fixed skill bank)해, 검색형 에이전트의 동적 스킬 갱신·퇴출에는 적용 여지가 남아 있다.
- Top-K 어휘 근사로 JSD를 계산해 vocabulary 전체 발산을 근사하므로, 매우 다양한 후보가 동시 등장하는 환경에서는 토큰별 민감도가 뭉뚱그려질 수 있다.
- OOD 평가가 카테고리 분할 한 가지 시나리오(예: ALFWorld의 6개 task type, WebShop의 7개 도메인)에 한정되어 새로운 OOD 시프트에 대한 강건성은 추가 검증이 필요하다.
- SearchQA multi-hop에서처럼 이미 충분한 근거를 찾았는데도 스킬 컨텍스트가 남아 있으면, AUSO도 과도한 follow-up 검색을 발생시킬 수 있다(논문 Table 5 Skill0.5 사례, AUSO는 2 step으로 종료).
- rollout 성공률이 0 또는 1에 가까운 작업은 uncertainty gate g(p_q)≈0이 되어 action-level reweighting이 사실상 비활성화 — 내부화 후 GRPO 단독으로 떨어지는 구간이 길어질 수 있다.
- OOD 도메인에서 retrieval된 스킬이 노이즈이거나 task와 mismatch인 경우, action-level JSD가 음의 보상 신호로 잘못 증폭될 위험이 있다(논문도 ‘큰 IG는 helpful을 의미하지 않는다’고 명시).
시스템 적용 아이디어
논문의 기법을 비슷한 구조를 가진 시스템에 옮길 때의 적용 지점이다.
RAG 검색 단계에 action-level JSD로 ‘충분하면 멈춤’ 가드레일 추가
장기 기억을 쓰는 에이전트의 검색 파이프라인이라면, 매 (query, retrieved_context) 쌍에서 context 유무 두 번의 다음 행동 분포 JSD를 측정한다. JSD가 임계 미만이면 ‘근거가 이미 행동을 바꾸지 않는다 = 추가 검색 불필요’로 판단해 종료한다. AUSO 논문의 후반부 uncertainty gate(g(p_q) = 4·p_q(1−p_q))를 그대로 곱해, rollout이 반반 섞인 multi-hop에서만 강하게 작동하도록 한다. 논문 Appendix A.1의 통계 정당화(precision ∝ p_q(1−p_q))를 그대로 재활용할 수 있다. 적용 지점: 검색 재순위 단계 직후, 다음 search/answer 액션 결정 직전. (근거: 논문 §3.3.3, Appendix A.1)
적용 지점 — 검색 재순위 단계 / 다음 액션 결정 직전
기대 효과 — 논문 SearchQA 사례에서 AUSO는 동일 질의에 2 step으로 종료, Skill0.5는 4 step + 잘못된 over-answer. 운영 비용과 정답 정확도 동시 개선 기대.
장기 호라이즌 에이전트 커리큘럼으로 ‘내부화→탐색→활용’ 단계형 학습 도입
스킬이 붙는 모든 장문의 에이전트라면, 학습 전체를 단일 GRPO 루프로 돌리지 말고 시간에 따라 활성화되는 두 보조 손실(teacher-student JSD, action-level weight) 스케줄 α(s), β(s)를 따라 3단 커리큘럼으로 짠다. α(s)는 ramp-up 후 smooth-step으로 감쇠, β(s)는 smooth-step으로 점증. 논문 Table 4에서 검증된 (2:5:3) 비율을 출발점으로 삼는다. 이 구조는 knowledge-distillation + curriculum + skill-routing을 하나의 RL 백본 위에서 동시에 처리할 수 있게 해 준다. (근거: 논문 §3.3.1, §3.3.4, Table 4)
적용 지점 — 에이전트 장기 정책 학습의 손실 함수 스케줄러
기대 효과 — Table 4에 따르면 (2:5:3) vs 균등 (3.3:3.3:3.3) 비교에서 ALFWorld OOD가 67.9 vs 41.5, ID 94.3 vs 87.4로 큰 차이.
외부 지식 라이브러리 자동 압축·내부화 파이프라인
스킬 라이브러리가 있는 에이전트라면, teacher(skill-conditioned) - student(skill-free) 사이의 JSD를 측정해 누적 가중치가 큰 스킬부터 순차적으로 모델에 internalize하고, 누적 가중치가 거의 0인 스킬은 retire한다. AUSO 논문이 teacher 가중치 β_int와 ramp-up·smooth-step 스케줄을 명시적으로 제공하므로, 이를 ‘주기 = 한 에피소드 종료 시’로 바꿔 끼우면 된다. action-level JSD는 활용 단계 가중치 w_t 계산에도 그대로 재사용 가능. (근거: 논문 §3.3.1 Eq.(8)(9)(10), Appendix A.2의 ‘unified procedure’)
적용 지점 — 지식 라이브러리 → 모델 파라미터로의 주기적 흡수 단계
기대 효과 — AUSO가 보여준 ‘스킬 활용 시 step 수 감소 + 정확도 향상’ 효과를 라이브러리 자동 압축 루프에 결합 가능. 정량 수치는 별도 측정 필요.
에이전트 self-eval 게이트로 action-level 불확실성 활용
장기 기억을 쓰는 에이전트의 handoff/종료 판단이라면, 매 (state, action) 쌍에서 외부 컨텍스트 유무 두 번의 forward pass로 JSD를 산출하고, 이를 uncertainty gate g(p_q)와 곱해 ‘이 결정이 얼마나 외부 지식에 매달려 있는가’ 점수 0~1로 만든다. 점수가 높으면 자동으로 인간 검수 큐에 넘기고, 낮으면 자동 통과시킨다. AUSO Appendix A.1의 variance 분석(precision ∝ p_q(1−p_q))이 그대로 ‘rollout 데이터가 흔들릴 때만 검수를 강화’ 정책의 근거가 된다. (근거: 논문 §3.3.3 Eq.(19)(20)(21), Appendix A.1)
적용 지점 — 에이전트 자체 confidence / human handoff 결정 단계
기대 효과 — AUSO의 SearchQA·ALFWorld 사례(같은 질의에 AUSO 24 step, Skill0.5 425 step)에서 보인 ‘불필요한 행동 절감’이 운영 검수 비용 절감으로 직결.
단계별 도입 로드맵
| 단계 | 목표 | 액션 | 기대 효과 |
|---|---|---|---|
| Phase 1 (파일럿, ~4주) | 도메인 내(ID) 데이터셋에 AUSO 3단계 커리큘럼을 그대로 이식해 베이스라인 대비 OOD 점수 향상 검증 | Qwen2.5-7B-Instruct + GRPO 베이스라인 위에 teacher-student JSD 손실 코드 통합, I[p_q=0] 조건·α(s)·β(s) 스케줄(2:5:3 비율) 적용, ID/OOD 카테고리 split 구성 | ID 손실 없이 OOD 일반화 +5~10p 수준의 첫 신호 확보, 도입 정당화 근거 마련 |
| Phase 2 (확장, 8~12주) | uncertainty gate와 action-level reweighting을 검색·웹 에이전트의 운영 트래픽에 실데이터 검증 | Top-K 어휘 근사 K값(논문은 4에서 peak) 그리드 탐색, 스킬 뱅크 고정 vs 주적 업데이트 비교, rollout group size G=8 외에 4·16에 대한 안정성 테스트 | 운영 환경에서 action-level JSD 비용(forward 2배) 대비 정확도·step 절감 ROI 정량화 |
| Phase 3 (고도화, 12주+) | 스킬 라이브러리 자체를 점진 갱신·퇴출하는 self-evolving 스킬 뱅크와 결합 | 각 행동의 JSD 누적을 추적해 ‘낮은 정보 이득을 주는 스킬’을 자동 retire, 새 도메인 진입 시 teacher가 되어줄 expert 모델을 online으로 교체 | 스킬 라이프사이클 전 자동화 — 내부화 ↔ 활용 ↔ 폐기 순환 완성, 장기 운영 시 cold-start 비용 절감 |
원문 PDF: 2026-08-25-auso-action-level-unified-skill-optimization-from-internalization-to-uti.pdf