AI 답이 튼튼한 여러 근거에 기대고 있는지, 아니면 한두 길이 막히면 바로 흔들리는지 확인해 위험한 답을 찾는 방법이다.
무엇이 문제였나 — 모델이 답을 낼 때 쓰는 여러 어텐션 머리 중 일부를 일부러 꺼 보고, 같은 답이 계속 안정적으로 나오는지 본다. 어떻게 풀었나 — 근거 문서를 읽고 답해야 하는 문제에서는, 확신은 높아 보여도 내부 경로가 흔들리는 답이 실제로 더 자주 틀렸다. 그래서 뭐가 좋아졌나 — 반대로 문서 없이 기억만으로 맞혀야 하는 문제에서는 이 방법이 잘 통하지 않았고, 논문은 이 실패도 설계상 예상된 경계라고 본다.
여러 사람이 같은 길 안내를 알고 있으면 한 사람이 빠져도 목적지에 도착한다. 하지만 딱 한 사람의 기억에만 기대고 있었다면 그 사람이 빠지는 순간 길을 잃는다. ASMI는 모델 답이 이런 한 사람짜리 길 안내에 기대고 있는지 보는 검사다.
논문 정보
Minsoo Kim, Sungyoung Ji, Kisung Moon, Ilyong Yoon · POSCO Holdings Future Technology Research Institute · arXiv preprint · 2025
왜 중요한가
검색 문서나 RAG 결과를 바탕으로 답하는 시스템에서는 겉보기 확신만으로 오답을 거르기 어렵다. ASMI는 답을 여러 번 새로 생성하지 않고도 내부 경로의 흔들림을 재서, 사람이 검토해야 할 위험한 답을 더 잘 골라낼 수 있는 단서를 준다.
핵심 지표
| 지표 | 값 | 설명 |
|---|---|---|
| Adapt-ASMI PRR on CoQA (Qwen3-4B) | 0.53PRR | Semantic Entropy 0.46 대비 Table 1 기준 우위, Table 13의 Sem-ASMI vs SemEnt paired Δ는 +0.060 [0.036, 0.085] |
| Confident-but-fragile vs confident-robust error (BabiQA) | 31% vs 10%% | Figure 4: MSP로는 둘 다 confident인 영역에서 fragile 예측이 약 3배 더 자주 틀림 |
| Retained error in MSP-confident stratum (BabiQA) | 5.6%% | Table 4: 원래 confident error 16.0%, entropy 필터 9.2%, ASMI 필터 5.6% |
| Estimator stability (Adapt-ASMI PRR redraw SD) | ±0.006PRR | Table 14: sample-diversity baseline ±0.014~±0.041보다 변동이 작음 |
어떻게 동작하나
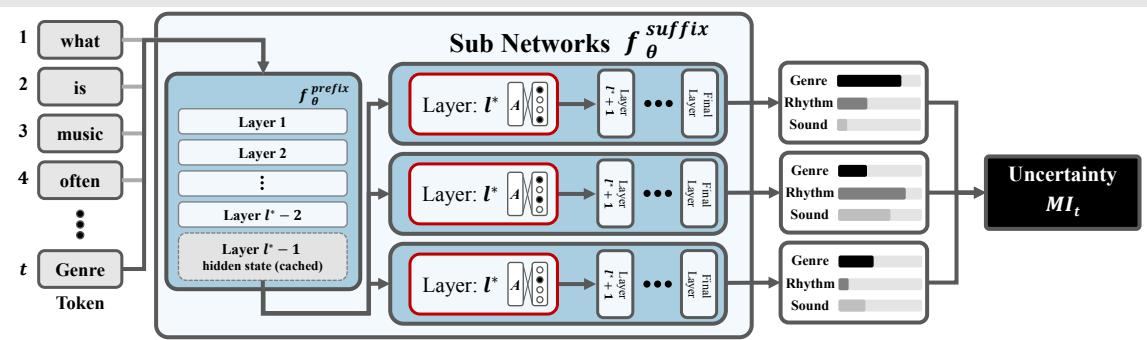
사전학습된 오토리그레시브 LLM의 greedy 응답 y를 먼저 고정한 뒤, 선택한 레이어 ℓ의 H=32 어텐션 헤드 출력에 독립 Bernoulli 마스크를 S=40회 적용한다. 논문 설정은 mask rate p=0.15이므로 각 헤드는 확률 1-p=0.85로 유지된다. ℓ 아래 prefix 계산은 한 번 캐시하고, 마스크가 적용되는 suffix만 반복 평가해 각 토큰 위치의 부분망 분포 p_t^{(s)}를 얻는다. 부분망 간 불일치는 BALD 형태의 M_{I_t}=H(평균 분포)-평균 H(개별 분포)로 계산한다. 이후 W_lm 출력 사영 행의 코사인 유사도로 만든 의미 동의 커널 A_t를 사용해 동의어·표면형 차이에서 오는 흔들림을 할인하고, u_t^{sem}=MI_t(1-A_t)를 토큰 점수로 둔다. Sem-ASMI의 시퀀스 점수는 토큰 점수 평균이며, Adapt-ASMI는 N=10 stochastic samples의 응답 다양도로 α(x)를 정해 의미 할인 강도를 조절한다.
 ASMI 파이프라인: 목표 레이어 아래 prefix를 1회 캐시하고 S개의 마스킹된 suffix로 동일 greedy 응답을 점수화
prefix cache로 Monte Carlo 비용이 prefix 1회 + suffix×S로 줄어드는 것이 학습-프리 추론의 핵심
핵심 수식:
M_{I_t}=H(\bar{p}_t)-\frac{1}{S}\sum_{s=1}^{S}H(p_t^{(s)}),\quad \bar{p}_t=\frac{1}{S}\sum_{s=1}^{S}p_t^{(s)},\quad A_t^{(m,n)}=(p_t^{(m)})^T G_t^{(m,n)}p_t^{(n)},\quad A_t=\frac{1}{S(S-1)}\sum_{m\ne n}A_t^{(m,n)},\quad u_t^{sem}=MI_t(1-A_t),\quad U(x,y)=\frac{1}{T}\sum_{t=1}^{T}u_t^{sem}
M_{I_t}는 S개 마스크 부분망의 평균 예측 분포 엔트로피와 개별 분포 엔트로피 평균의 차이다. p_t^{(s)}는 s번째 마스크 아래 토큰 t의 예측 분포, \bar{p}_t는 그 평균이다. G_t^{(m,n)}는 후보 토큰 간 의미 유사도 행렬, A_t는 부분망 쌍들의 평균 의미 동의 점수다. u_t^{sem}은 의미적으로 같은 후보의 흔들림을 할인한 토큰 불확실성, U(x,y)는 생성 시퀀스 전체 평균 점수다.
한계와 주의할 점
- BALD 형태의 MI_t는 epistemic/aleatoric 분리를 보장하지 않으며 논문도 Wimmer et al. 2023을 근거로 단순한 disagreement functional로만 사용한다고 제한한다.
- CoQA/Qwen3-8B 셀에서 {MSP, H} 통제 후 residual AUROC 신뢰구간이 0.5를 배제하지 못해 distinctness 결론이 해당 셀에서는 약하다.
- SQuAD/Qwen3-4B residual 효과는 두 독립 마스크 draw에서 0.550 vs 0.501로 갈려 Monte Carlo 해상도 경계에 있다.
- Llama-2-7B의 BabiQA처럼 head masking에 과도하게 견고한 모델에서는 MI 신호가 거의 0으로 축소되어 ASMI가 오류를 분리하지 못한다.
- base model에서 검증했으며 instruction-tuned model로 일반화되는지는 향후 과제로 남는다.
- 파라메트릭 회상(closed-book TriviaQA): 답이 제공 문서의 어텐션 라우팅보다 모델 내부 기억에 의존하므로 ASMI가 MSP보다 낫지 않으며, Table 7에서 u_sem AURC 0.327로 MSP 0.314와 entropy 0.305보다 나쁘다.
- 과견고(over-robust) 백본: Llama-2-7B의 BabiQA에서 mean token-level MI_t가 0.002에 머물러 correct/wrong 답이 거의 같은 낮은 MI 점수를 받는다.
- 긴 응답(예: SQuAD 평균 생성 18 토큰): 단순 토큰 평균이 신호를 희석할 수 있으며 Appendix D에서 top-quartile mean과 max aggregation이 더 강한 residual AUROC를 보였다.
- BabiQA의 깊이 비단조성: Qwen3-8B unweighted ASMI가 70% 깊이 0.78에서 80% 0.48로 떨어지고 90% 0.76으로 회복하는 등 단일 토큰 위치 복사 태스크에서 depth 민감도가 크다.
시스템 적용 아이디어
논문의 기법을 비슷한 구조를 가진 시스템에 옮길 때의 적용 지점이다.
RAG 파이프라인의 자기-규제형 환각 게이트에 ASMI 삽입
RAG 검색 후 응답 생성 단계에서 60% 상대 깊이 근처의 Sem-ASMI를 붙이고, MSP가 confident로 본 응답 중 u_sem이 높은 상위 비율을 human review로 보낸다. 논문 Table 4의 Qwen3-4B 결과처럼 MSP-confident stratum에서 retained error가 CoQA 13.6%→7.2%, BabiQA 16.0%→5.6%로 낮아진 사례를 기준으로 도메인별 ROI를 측정한다. 단, 폐북 지식 질문은 ASMI 적용 대상에서 제외한다.
적용 지점 — 에이전트 응답 신뢰도 게이트(RAG 후처리 단계)
기대 효과 — 논문 Qwen3-4B grounded QA 기준 MSP-confident stratum retained error를 CoQA 13.6%→7.2%, BabiQA 16.0%→5.6%로 감소
에이전트 자기검증 종료 조건에 confident-but-fragile 비율 활용
에이전트가 같은 근거 문서를 보고 답변을 재작성할 때, 각 iteration의 ASMI 점수 또는 fragile token 비율을 기록한다. 첫 응답보다 u_sem이 줄고 MSP confidence가 유지될 때만 종료하도록 실험한다. 논문은 sequence-level confident-but-fragile 효과가 BabiQA에서 31% vs 10%, CoQA에서 gap 0.12로 나타났지만 token-level confident stratum에서는 분리가 약했다고 하므로, 종료 조건은 토큰 하나가 아니라 응답 전체 점수로 설계한다.
적용 지점 — 에이전트 자기검증/재작성 종료 조건
기대 효과 — 근거 기반 QA에서 fragile sequence를 줄이는 방향의 품질 게이트 가능성 검증
운영 백본 자동 라벨-프리 스크리닝: 오버로버스트 진단
백본 교체 전 100~200개 대표 입력에 대해 greedy 응답과 S=40 head-mask scoring을 수행하고 평균 MI_t 및 score 분산을 본다. 논문 Table 12에서 Llama-2-7B BabiQA는 mean MI_t=0.002로 correct/wrong이 구분되지 않았고 MSP가 더 나았다. 이런 백본은 ASMI 신호를 끄고 MSP/entropy/Semantic Entropy로 fallback한다. 논문은 이 스크리닝을 retrospective candidate로만 제시했으므로, 운영 전 별도 검증이 필요하다.
적용 지점 — 운영 LLM 백본 진단/신호 호환성 사전 평가
기대 효과 — 오버로버스트 백본 조기 탐지로 부적합한 ASMI 게이트 도입 방지
응답 후처리 단계에 시맨틱 동의어 할인 커널 일반화
ASMI의 W_lm 코사인 기반 의미 동의 커널 A_t를 응답 후보 재순위나 후처리에도 응용한다. 논문 Table 1에서 CoQA의 Sem-ASMI는 raw ASMI보다 각 백본에서 약 +0.05~+0.06 PRR 높아 표면형 변동이 큰 데이터에서 의미 할인 효과가 컸다. 다만 Appendix D는 kernel이 항상 새로운 독립 정보를 주는 것은 아니며, real CoQA에서는 주로 MI ordering 안의 reranking 역할이라고 해석한다.
적용 지점 — RAG 응답 재순위 단계의 동의어 클러스터링
기대 효과 — CoQA에서 Sem-ASMI가 raw ASMI 대비 Qwen3-4B 0.46→0.52, Qwen3-8B 0.51→0.55, Llama-2-7B 0.49→0.54, Mistral-7B 0.48→0.53으로 개선
단계별 도입 로드맵
| 단계 | 목표 | 액션 | 기대 효과 |
|---|---|---|---|
| Phase 1 | 운영 중인 RAG/QA 시스템의 평가 인프라에 ASMI 평가 모듈 추가 | 1) greedy 응답 고정 및 prefix cache 기반 Sem-ASMI scoring 구현, 2) 기존 quality label 또는 AlignScore 유사 평가 파이프라인 구축, 3) MSP, entropy, Semantic Entropy, Sem-ASMI를 같은 응답 집합에서 비교 | 현재 도메인이 context-routed인지, ASMI가 confidence/entropy 위에 추가 정보를 주는지 사전 확인 |
| Phase 2 | confident stratum 전용 필터를 응답 라우터에 삽입 | 1) MSP 상위 절반 같은 confident stratum을 먼저 정의, 2) 그 안에서 u_sem 상위 응답만 abstain 또는 human review로 전송, 3) 도메인별 coverage와 retained error를 기준으로 threshold 튜닝 | 논문에서 효과가 집중된 confident-but-fragile 영역만 겨냥해 global selector보다 실용적인 개선을 노림 |
| Phase 3 | 도메인·백본별 적용 경계 모니터링 | 1) 평균 MI_t가 0 근처로 떨어지는 over-robust 백본 경고, 2) 폐북/근거 기반 모드별 ASMI 사용 여부 분리, 3) SQuAD처럼 긴 응답에서는 mean 외 top-quartile 또는 max aggregation도 함께 검증 | ASMI가 잘 작동하는 context-routing 영역과 실패가 예상되는 parametric recall 영역을 운영상 분리 |
원문 PDF: 2026-08-13-attention-path-fragility-as-an-uncertainty-signal-in-large-language-mode.pdf