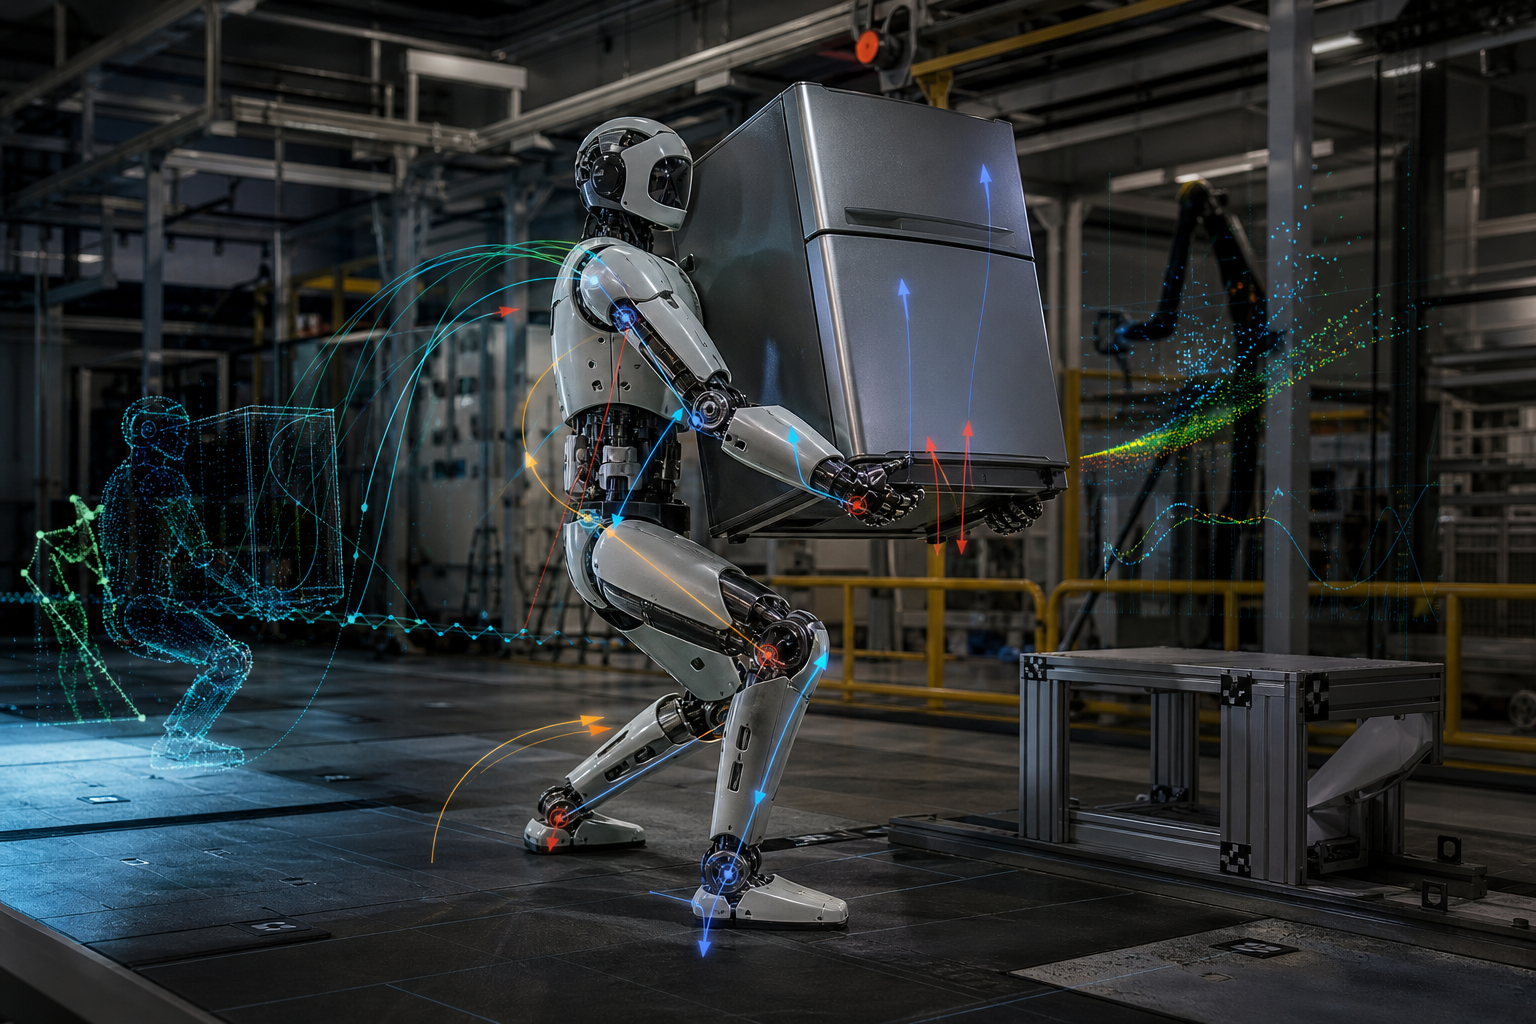
보스턴 다이내믹스의 Atlas가 미니 냉장고를 들어 옮기는 장면은 단순한 쇼맨십처럼 보일 수 있다. 하지만 이 데모의 핵심은 “로봇이 무거운 물건을 들었다”가 아니다. 휴머노이드가 실제 산업 현장에서 일하려면 무엇을 배워야 하는지 보여주는 실험에 가깝다.
핵심 요약
- Atlas는 미니 냉장고를 들어 옮기며 전신 제어, 힘, 균형, 적응 능력을 함께 보여줬다.
- 핵심은 카메라 기반 인식보다 몸의 감각, 즉 고유수용감각(proprioception)을 활용한 물리 지능이다.
- 강화학습으로 냉장고의 위치, 무게, 마찰, 잡히는 자세가 달라지는 수많은 상황을 시뮬레이션에서 연습했다.
- 실제 로봇 투입을 위해서는 시뮬레이션 정확도, 하드웨어 단순성, 빠른 반복 실험 체계가 모두 필요하다.
카메라만으로는 냉장고를 들 수 없다
최근 휴머노이드 로봇 연구는 시연 데이터와 AI 기반 행동 모델을 적극 활용한다. 로봇이 사람의 동작을 보고 배우고, 새로운 작업에 빠르게 적응하는 방향이다. 하지만 보스턴 다이내믹스는 이 접근만으로는 “힘든 육체 노동”을 충분히 해결하기 어렵다고 본다.
가벼운 물체를 손끝으로 집는 일과 무거운 냉장고를 몸으로 끌어안아 드는 일은 완전히 다르다. 사람도 냉장고를 들 때 손만 쓰지 않는다. 몸을 기울이고, 팔뚝과 가슴으로 지지하고, 무게가 어디로 쏠리는지 느끼며 자세를 바꾼다. 실제 작업은 물체와 몸이 부딪히고 밀착되는 순간에 일어난다.
Atlas의 냉장고 운반 데모가 중요한 이유도 여기에 있다. 로봇은 냉장고를 “보는” 데서 끝나지 않고, 몸 전체를 써서 물체의 무게와 마찰, 흔들림에 적응해야 한다. 이것이 보스턴 다이내믹스가 말하는 물리 지능의 핵심이다.
Atlas는 어떻게 훈련됐나
Atlas는 강화학습(RL)으로 냉장고를 드는 행동을 익혔다. 처음에는 기준 궤적이 필요하다. 사람이 원격 조작한 데이터일 수도 있고, 애니메이션일 수도 있다. 이번 냉장고 작업에서는 Atlas의 넓은 관절 가동 범위를 활용하기 위해 단순한 애니메이션에서 출발했다.
그다음 보상 함수를 설계한다. 로봇이 냉장고의 위치와 방향을 유지하고, 작업 중 외부 힘이 가해져도 목표 행동에서 벗어나지 않도록 보상을 준다. 이후 Atlas는 GPUs 기반 병렬 시뮬레이션에서 수많은 변형 상황을 경험한다. 냉장고의 위치, 무게, 바닥 마찰, 손과 냉장고 사이의 그립, 냉장고가 몸 사이에 놓이는 자세가 조금씩 달라진다.
흥미로운 점은 로봇이 “완벽한 냉장고”만 연습하지 않았다는 것이다. 실제 테스트에서는 냉장고 안에 여러 물체를 넣어 무게가 고르게 분포하지 않게 만들었다. 원문에 따르면 정책은 50~70파운드 하중으로 훈련됐지만, 실제로는 100파운드가 넘는 적재 냉장고도 옮겼다.
하드웨어가 단순해야 학습도 빨라진다
Atlas의 새 하드웨어는 대량 생산과 유지보수까지 고려해 설계됐다. 보스턴 다이내믹스는 몸 전체에 두 종류의 액추에이터만 사용한다고 설명한다. 같은 부품을 반복해서 쓰면 제조 비용과 복잡도가 낮아지고, 시뮬레이션에서도 로봇을 더 정확하게 모델링하기 쉽다.
팔과 다리, 어깨 구조와 골반 구조도 가능한 한 반복된다. 케이블을 관절에서 제거해 액추에이터가 무한 회전할 수 있게 만든 점도 중요하다. 고장 요인을 줄이고, Atlas만의 독특한 움직임을 가능하게 한다. 손, 팔, 다리, 머리는 현장에서 몇 분 안에 교체할 수 있는 모듈로 설계됐다.
화려한 백플립이나 물구나무도 단순한 묘기가 아니다. 90kg 로봇이 그런 동작을 할 수 있다는 것은 열 관리, 균형 회복, 미끄러짐 대응, 넓은 관절 범위를 검증한다는 뜻이다. 산업 현장의 거칠고 더운 환경에서 버티려면 이런 능력이 결국 작업 신뢰성으로 이어진다.
시뮬레이션과 현실의 간격을 줄이는 법
로봇 학습에서 가장 어려운 문제 중 하나는 시뮬레이션과 현실의 차이다. 시뮬레이션에서는 잘되던 정책이 실제 하드웨어에서는 마찰, 지연, 센서 노이즈 때문에 실패할 수 있다. 보스턴 다이내믹스는 Atlas의 기업용 버전에서 이 간격이 매우 작아졌다고 강조한다.
비결은 세 가지다. 첫째, 실제 하드웨어를 시뮬레이션에서 정확히 재현할 수 있을 만큼 단순하고 대칭적으로 설계했다. 둘째, 도메인 랜덤화로 훈련 환경을 일부러 흔들었다. 냉장고 무게, 바닥 마찰, 모터 강도 같은 변수를 계속 바꿔 실제 세계의 불확실성에 강하게 만든다. 셋째, 실제 로봇 테스트 데이터를 다시 훈련에 반영하는 반복 체계를 갖췄다.
이 흐름은 “오늘 정책을 학습하고, 내일 실제 로봇에 올려 테스트한 뒤, 다시 데이터를 모아 다음 행동을 개선하는” 방식에 가깝다. 휴머노이드가 제품이 되려면 멋진 데모 하나보다 이런 반복 속도가 더 중요하다.
실무자가 볼 핵심 포인트
- 휴머노이드의 병목은 손재주만이 아니다: 무거운 물체를 옮기는 일에는 전신 제어, 접촉, 균형, 힘 조절이 함께 필요하다.
- 물리 지능은 몸의 피드백에서 나온다: 카메라 인식만으로는 부족하다. 고유수용감각과 접촉 중 적응이 핵심이다.
- 시뮬레이션 품질이 곧 개발 속도다: 실제와 가까운 시뮬레이터가 있어야 강화학습 정책을 빠르게 현실에 배포할 수 있다.
- 하드웨어 단순화는 AI 성능에도 영향을 준다: 반복 부품, 대칭 구조, 적은 액추에이터 종류는 비용뿐 아니라 모델링 정확도와 유지보수성을 높인다.
- 데모보다 중요한 것은 반복 루프: 시뮬레이션, 실제 테스트, 데이터 수집, 정책 개선이 하루 단위로 돌아갈 때 제품화 가능성이 커진다.
원문 출처
원문: Training a Humanoid Robot for Hard Work — Alberto Rodriguez, Shane Rozen-Levy, Vinay Kamidi, Boston Dynamics