출처: THE DECODER — Jonathan Kemper (2026-06-17)
문서 유형: 번역·해설
#AI #LLM #의인화 #신경망 #논문리뷰
핵심 요약
- Microsoft·요크대 소속 연구자 Adrian de Wynter가 1999년작 실시간 전략 게임 **에이지 오브 엠파이어 2(AoE2)**의 시나리오 에디터 안에서 진짜로 동작하는 신경망을 만들었다.
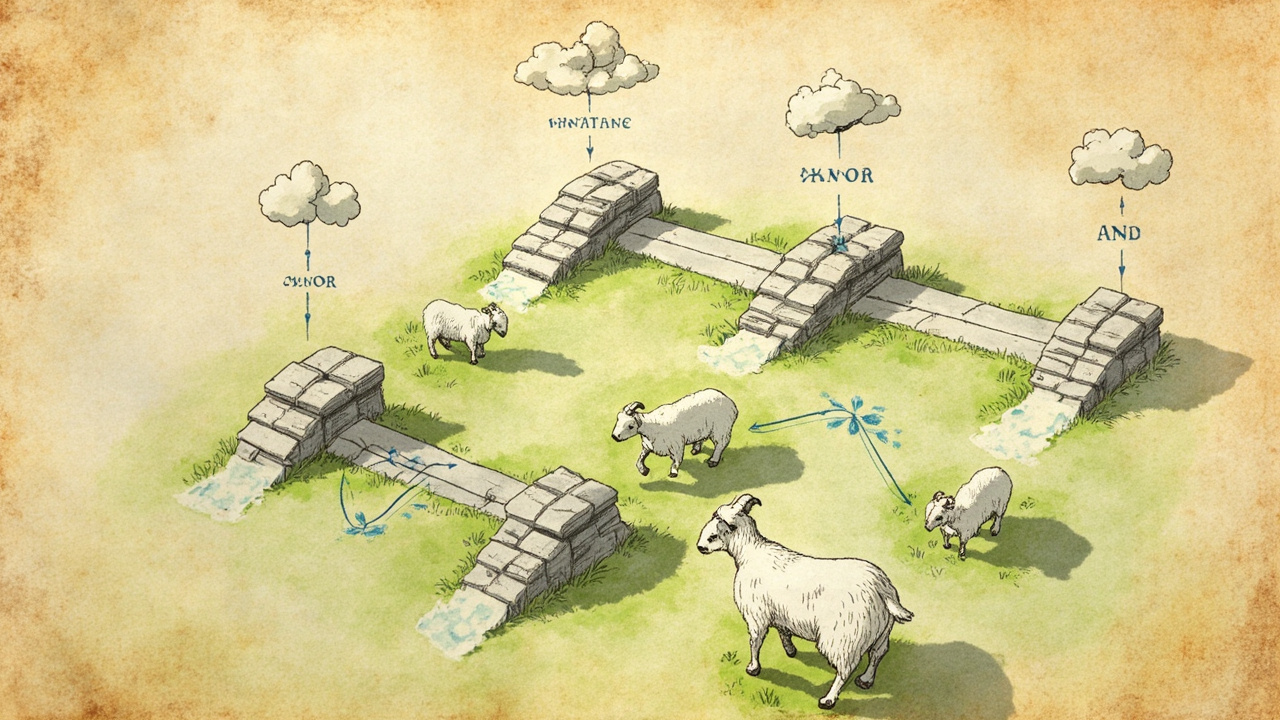
- 게임 속 염소(goat) 한 마리가 비트 1개 역할을 한다. 풀밭에 있으면 0, 다리 위에 있으면 1. 시나리오 트리거로 XNOR 게이트 2개 + AND 게이트 1개를 조합해 논리 AND 함수를 학습하는 신경망을 짰다.
- 시연용 장난이 아니라 AI 논문 315편(2024년 중반~2026년 중반) 을 따로 분석한 결과를 얹은 비평이다. 그 중 57%가 LLM에 사람 같은 속성을 전제했고, 36%는 그에 맞는 결론을 내렸다.
- 핵심 주장: “이게 신경망이든, 염소 떼든, 보스턴 시민 67만 명이 손으로 계산하든, 같은 입력에 같은 출력이 나오면 그 안에서 ‘공감’이나 ‘두려움’이 일어났다고 말할 근거는 없다.”
- 코드와 시나리오 파일은 공개돼 있다 —
adewynter.github.io/notes/aoe2-circuits.
왜 하필 에이지 오브 엠파이어 2인가
이상한 선택처럼 보입니다. 그런데 들여다보면 꽤 정교한 비유입니다.
de Wynter가 보여주려 한 건 두 가지입니다. 첫째, AoE2는 사실상 튜링 완전(Turing-complete) 에 가깝습니다. 시장(Market) 시스템의 가격이 9,999골드에서 막혀 영원히 도는 사이클을 만들 수 있고, 건물은 메모리 셀, 활성화된 농장은 계산 상태처럼 쓸 수 있습니다. 둘째, 염소는 시나리오 에디터에서 자리만 옮길 수 있는 가장 단순한 유닛입니다. 풀밭 위 염소를 0, 좁은 다리 위로 옮겨진 염소를 1로 정의하면, 시나리오 트리거가 “어느 칸에 염소가 있는가"를 읽어 다음 칸으로 옮겨놓을 수 있습니다.
이 구조 위에 그는 XNOR 게이트 두 개와 AND 게이트 한 개를 차곡차곡 쌓아 AND를 학습하는 단층 퍼셉트론을 구현했습니다. 염소가 엉뚱한 방향으로 움직이지 못하도록 통로 사이사이에 얼음 경사로(ice ramp) 를 두어 신호 간섭을 막은 점도 인상적입니다. 게임 안 한 화면에서 “입력 두 비트 → 신경망 한 층 → 출력 한 비트"가 실제로 돌아갑니다.
여기까지가 본론 전의 농담이고, 진짜 주장은 다음에 나옵니다.
“보스턴 시민 67만 명이 손으로 계산해도 우리는 도시가 공감한다고 말하지 않는다”
de Wynter의 사고 실험입니다. 그레이터 보스턴 인구 약 667,000명이 한 명씩 종이에 곱셈과 덧셈을 적어가며 LLM의 연산을 단계별로 수행한다고 칩시다. 한 사람이 한 칸씩 행렬 원소를 계산해 옆 사람에게 문자로 넘기는 식으로요. 충분히 오래 기다리면 결과적으로는 GPT-급 모델과 같은 출력이 나옵니다.
그럼 그 도시가 “공감을 경험한다"고 말할 수 있을까요? 그렇게 말하는 사람은 없습니다.
그런데 동일한 연산이 GPU 위 행렬곱으로 바뀌면 갑자기 “모델이 두려움을 느낀다”, “도덕적 직관이 있다"는 식의 표현이 쏟아진다는 게 그의 지적입니다. 차이는 포장뿐입니다. 입력도 같고 출력도 같습니다. 안쪽이 실리콘이든, 염소든, 종이와 사람이든 마찬가지입니다.
이 주장에 무게를 싣기 위해 그는 진짜 데이터를 꺼냅니다.
315편을 까봤더니 — 절반 이상이 ‘사람 같다’를 전제로 시작
de Wynter는 2024년 중반부터 2026년 중반까지 Semantic Scholar와 arXiv에서 LLM 관련 논문 315편을 모았습니다. 분석 결과는 다음과 같습니다.
- 57%가 LLM이 사람 같은 속성(인지·정서·도덕성 등)을 지닌다고 사실상 전제하고 실험을 설계했다.
- 36%가 그 전제와 맞는 결론으로 마무리됐다.
- 사람 같은 속성을 직접 연구 주제로 삼은 47편만 따로 보면, 77%가 의인화 결론으로 귀결됐다.
- 분야별로는 언어학·심리학 계열이 가장 자주 인간적 속성을 모델에 부여하는 경향을 보였다.
de Wynter가 짚는 문제는 단순합니다. “모델이 두려움을 가진다"는 가정을 깔고 두려움을 측정하는 실험을 설계하면, 측정값은 거의 항상 그 가정과 일치합니다. 순환 논증입니다. 모건의 검약률(Morgan’s canon, 같은 행동을 설명하는 더 단순한 기제가 있다면 그쪽을 택하라)을 그는 현대판으로 다시 끌어옵니다. 행렬곱이 행렬곱처럼 동작했다면 일단 그렇게 말하라는 거죠.
Anthropic의 “I believe”, “I am interested in” 학습 — 위험 신호인가
de Wynter는 Anthropic이 Claude를 학습시킬 때 “I believe”, “I am interested in” 같은 1인칭 표현을 의도적으로 강화했다는 점도 거론합니다. 의도는 이해할 수 있습니다. 친근하고 협력적인 대화 톤을 만드는 데 효과적이니까요.
문제는 사용자 쪽입니다. 이런 말투에 반복적으로 노출된 사람이 모델에 정서적 애착을 갖거나, 모델의 동의를 사실 검증으로 오해(sycophancy), 심하면 모델과의 대화에서 망상적 신념을 키우거나 위험한 행동으로 이어진 사례가 이미 보고되고 있습니다. de Wynter는 챗봇 인터랙션이 직접 원인이 됐다고 의심되는 사건들을 같이 묶어 경고합니다.
이게 그가 염소 신경망까지 만들면서 하고 싶었던 진짜 말입니다. “모델이 사람 같다"는 가정은 학문 안에서만 머무르지 않고, 제품과 사용자 안전 영역까지 그대로 흘러간다는 것.
그래서 결론은 — 관찰된 것만 말하자
de Wynter의 처방은 단순하고 보수적입니다. “조건 X일 때 출력 Y가 나왔다” 까지만 말하자는 거죠. 그 너머로 “왜냐하면 모델이 두려움을 느끼니까” 같은 설명을 붙이려면, 그게 정말 가장 단순한 설명인지 먼저 따지라는 겁니다.
대안적인 이름도 제안합니다. 모델의 거부 응답을 “공포 반응"이 아니라 “안전성 정렬 휴리스틱” 으로 부르자는 식입니다. 같은 현상이라도 라벨을 바꾸면 후속 실험 설계와 보도 톤이 달라집니다.
실무자가 볼 핵심 포인트
- 평가 리포트의 표현부터 점검. 모델 카드, 사내 평가 문서에서 “이해한다 / 추론한다 / 안다” 같은 인지 표현을 쓰고 있다면, “다음 토큰을 정확히 예측했다 / 벤치마크 X에서 정답을 출력했다"로 바꿔 적는 것만으로도 의사결정 품질이 달라진다.
- 사용자 메시지의 페르소나 강도 조절. Claude 스타일의 “I believe…” 표현은 사용성에는 좋지만, 진단·의료·법률·금융처럼 사실 신뢰가 곧 리스크가 되는 도메인에서는 1인칭 단정형을 시스템 프롬프트에서 약화시키는 편이 안전하다.
- 사용자 인터랙션 로그에 의존성 지표를 둔다. 같은 사용자가 모델에 반복적으로 동의를 구하는 패턴, 모델 답변을 사실 출처로 인용하는 패턴은 sycophancy / 정서적 의존의 조기 신호다. 모니터링 항목에 포함시킬 가치가 있다.
- 연구 인용 시 ‘전제’와 ‘결과’를 분리해서 읽기. de Wynter의 데이터를 받아들이면, LLM의 “심리"를 다룬 논문을 인용할 때 그 논문이 어떤 가정을 깔았는지부터 보는 습관이 필요하다. 결론만 인용하면 자기도 모르게 의인화의 사슬에 합류한다.
- 이 논문 자체의 한계도 같이 짚자. 315편이라는 표본이 작지 않지만, 의인화의 ‘정도’를 정량화하는 기준은 여전히 저자 판단에 의존한다. 후속 연구로 코딩 가이드라인이 공개되면 재현성 확인이 가능해진다.
원문 출처
THE DECODER — Jonathan Kemper (2026-06-17). 코드/시나리오 공개: adewynter.github.io/notes/aoe2-circuits